[논문리뷰] VGG-T³: Offline Feed-Forward 3D Reconstruction at Scale
CVPR 2026. [Paper] [Page] [Github]
Sven Elflein, Ruilong Li, Sérgio Agostinho, Zan Gojcic, Laura Leal-Taixé, Qunjie Zhou, Aljosa Osep
NVIDIA | University of Toronto
26 Feb 2026
Introduction
본 연구에서는 대규모 3D geometry reconstruction 문제를 다룬다. 최근의 학습 기반 접근 방식은 feed-forward 신경망을 통해 이미지로부터 장면의 geometry를 직접 예측한다. 이러한 방식은 정확도 면에서 기존 방법들과 대등한 수준을 보이며, 급격한 카메라 움직임이나 낮은 시각적 중첩도와 같은 까다로운 조건에서도 경험적으로 더 robust한 성능을 나타낸다. 그러나 입력 이미지의 수가 증가함에 따라 연산 및 메모리 요구량이 급격히 늘어나는 한계가 있다.
이러한 병목 현상은 global self-attention layer의 Key-Value (KV) space에 저장된 장면 수준 메모리에서 비롯된다. 모든 입력 이미지 토큰으로부터 projection된 이 KV space는 3D 속성 예측을 위해 쿼리되는, 가변 길이의 dense한 장면 표현 역할을 한다. 이 표현으로부터 장면의 geometry를 추정하기 위해, 모델은 global softmax attention 연산을 통해 KV space를 쿼리해야 한다. 이 연산은 입력 이미지 수의 제곱에 비례하여 증가하는 복잡도를 가진다.
저자들은 멀티뷰 이미지를 tokenize하고 출력 토큰으로부터 dense depth map을 디코딩하는 사전 학습된 멀티뷰 feed-forward 모델을 활용하였다. Global attention layer에서 softmax attention을 수행하는 대신, Test-Time Training (TTT)를 따라 고정된 크기의 MLP 가중치를 통해 KV space를 매핑한다. Test-time에 토큰 공간에서의 reconstruction loss를 사용하여 MLP를 최적화함으로써 사전 학습된 인코더/디코더 네트워크를 그대로 유지할 수 있다. 따라서 test-time에 입력 시점으로부터 depth map을 디코딩하기 위해 KV space를 쿼리하는 과정은, 입력 토큰을 학습된 MLP에 통과시키는 것만으로 이루어진다. 이 연산은 입력 이미지 집합의 크기에 대해 선형적인 복잡도를 갖는다.
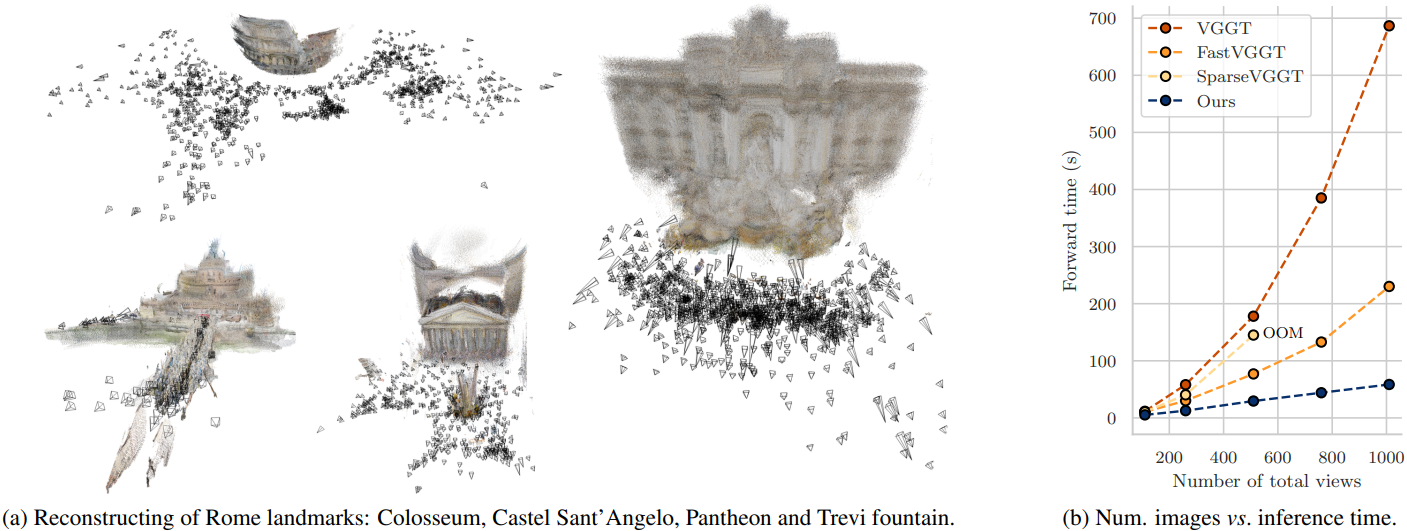
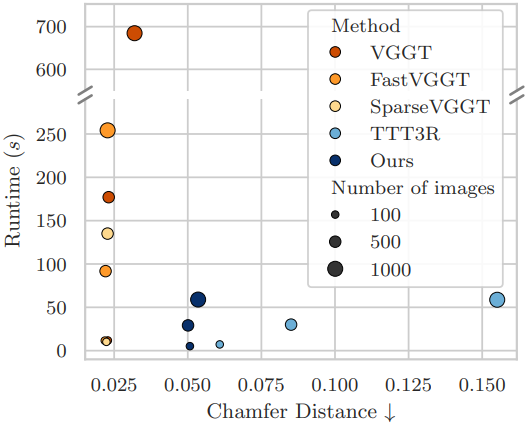
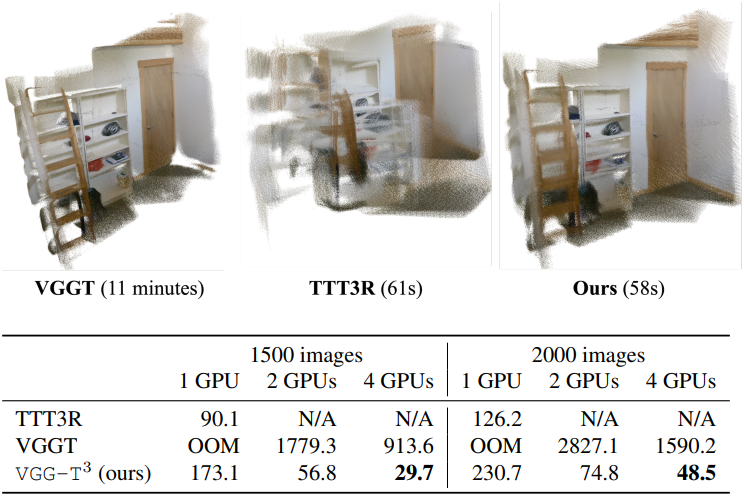
본 논문의 접근 방식을 활용하면 mini-batching을 통해 TTT loss의 전체 gradident를 계산할 수 있다. Mini-batch를 CPU로 off-loading하여 하나의 GPU에서 대규모 이미지 집합을 처리하거나, 이미지 토큰을 여러 GPU에 sharding하여 분산 inference를 수행할 수 있다. 그 결과, 2,000개의 이미지를 48.5초 만에 처리할 수 있으며, 이는 27분 소요되는 VGGT 대비 33배 향상된 성능이다.
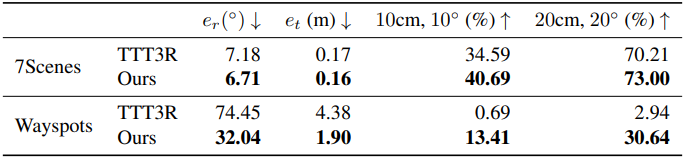
또한, 이러한 표현 방식의 변화는 새로운 가능성을 열어준다. Reconstruction을 수행한 후, 최적화된 MLP는 장면의 압축된 버전을 저장한다. 새로운 쿼리 뷰를 사용하여 저장된 MLP에 쿼리를 수행함으로써, 재구성된 장면을 기준으로 이 압축된 이미지의 위치를 파악하여 visual localization을 자연스럽게 수행할 수 있다. 기존에는 reconstruction과 localization을 위해 각각 별도의 솔루션이 필요했다. 하지만 본 접근 방식은 매핑과 localization에 동일한 모델을 사용하여 통합된 end-to-end 솔루션을 제공한다.
Method
1. Can We Fit Rome into MLPs?
Overview
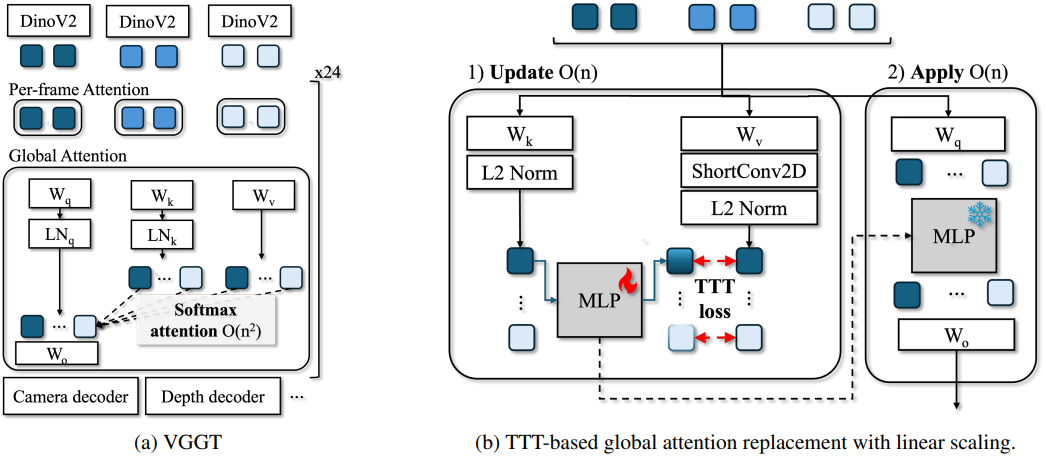
본 논문에서는 양방향 Transformer 아키텍처 내의 global attention 연산을 선형 연산으로 구조적으로 대체한다. Transformer 기반의 멀티뷰 네트워크를 사용하여 멀티뷰 입력을 토큰으로 projection한 후, forward pass는 각 global attention layer에서 실행되는 두 반복적인 단계로 구성된다.
- Update: 입력 토큰을 query $q$, key $k$, value $v$로 projection하고, TTT를 활용하여 KV 쌍에 저장된 가변 길이 정보를 MLP의 고정 크기 가중치로 변환한다. 이때 MLP는 학습 및 test-time에 최적화되는 가중치, 즉 fast weight $\theta$로 취급된다. 이는 결과적으로 현재 계층의 key-value 매핑을 고정 크기의 신경망 기반 장면 표현으로 압축하는 효과를 낸다.
- Apply: Fast weight를 최적화한 후, query에 MLP를 적용함으로써 해당 장면 표현을 효율적으로 쿼리할 수 있다. 토큰이 다음 layer로 전달되기 전, 현재 layer의 쿼리에 대해서만 global attention block 내에서 MLP를 적용하여 토큰을 갱신한다. 다운스트림 task를 위한 디코딩은 최종 Transformer layer를 통과한 후에만 수행된다.
사전 학습된 모델의 선형화
저자들은 VGGT의 사전 학습된 가중치를 사용하여 모델을 초기화하고자 하였다. 해당 가중치들은 원본 모델을 통해 학습된 일반적인 시각적 지식을 이미 내포하고 있다. 그러나 softmax attention을 TTT 연산으로 대체하는 선형화를 단순히 적용할 경우, TTT 과정에서 수렴 속도가 매우 느려진다.
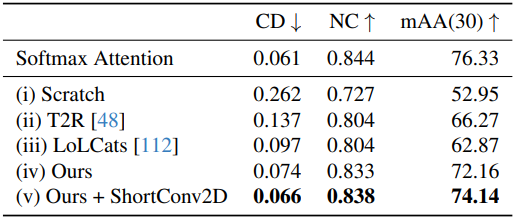
토큰 projection은 원본 모델의 softmax attention 연산을 안정화하는 LayerNorm (LN)을 포함한다. 그러나 LN은 test-time에 MLP가 학습하고자 하는 입력 공간을 왜곡시키는 추가 학습 가능한 파라미터를 수반한다. LN을 제거하고 대신 $L_2$ 정규화를 적용함으로써, 사전 학습된 가중치를 활용한 빠른 수렴을 이끌어낼 수 있다. 또한, 일반적인 softmax attention 학습 후 선형화를 이용한 후속 학습을 수행하는 방식이, TTT를 통해 처음부터 직접 학습하는 방식보다 더 유리하다.
Non-linear spatial mixing
Linear attention 기법들은 Transformer 모델의 속도를 크게 향상시키지만, 일반적으로 softmax attention 대비 성능 지표의 저하를 동반한다. 본 논문에서는 이러한 성능 저하의 원인을 TTT loss가 가진 본질적인 수학적 제약에서 찾았다. TTT loss의 목적은 key $K$에서 value $V$로의 매핑을 학습하는 것이다. 그러나 $K$와 $V$는 모두 동일한 토큰 $x$로부터 linear projection을 통해 도출되며, 이들 사이의 관계는 선형적이다. 따라서 단순히 TTT loss를 최적화하는 것만으로는 자명한 해를 얻게 될 수 있다.
이러한 의존성을 끊고 표현력을 높이기 위해, 저자들은 선형 언어 모델에서 효과적으로 활용된 short convolution과 같은 sequence mixing layer에 주목했다. 저자들은 이 원리를 3D reconstruction에 적용하여 $V$에서 공간적 혼합을 수행하는 ‘ShortConv2D’를 도입했으며, 이를 통해 TTT loss가 $K$에서 $V^\prime$로의 매핑을 학습하도록 했다. 구체적인 구현 방식은 다음과 같다.
- Reshape: Value $V = [v_1, \ldots, v_{N \times H/p \times W/p}], v_i \in \mathbb{R}^d$가 주어지면, 먼저 1D 토큰 시퀀스 $V$를 해당 2D 이미지 그리드 형태인 $(N, H/p, W/p, d)$로 reshape한다 ($p$는 tokenizer의 패치 크기).
- Convolve: 1D convolution보다 이미지 구조에 더 적합한 single-layer 2D convolution인 ‘ShortConv2D’를 적용한다. 이는 로컬한 이웃 정보를 통합하여 컨텍스트를 반영한 value $V^\prime$을 생성한다.
- Flatten: TTT loss를 최적화하기에 앞서, $V^\prime$을 다시 1D 시퀀스 형태로 reshape한다.
2D convolution을 적용함으로써 value $V^\prime$은 통합된 로컬 공간 컨텍스트를 포함하게 되는 반면, key $K$는 컨텍스트 정보가 제한된 상태로 유지된다. 이는 MLP가 feature $K$로부터 이웃 $V^\prime$을 예측해야 하므로, 더 강력한 self-supervised loss를 통해 robust한 장면 표현을 추출하도록 fast weight 최적화를 유도한다.
Test-time scaling
기존 feed-forward 모델이 상대적으로 작은 이미지 집합으로 학습되는 반면 (VGGT의 경우 24장), 본 논문의 목표는 대규모 SfM에서 흔히 요구되는 수천 장 규모의 훨씬 더 큰 이미지 집합을 처리하는 것이다. TTT 환경에서는 out-of-distribution 시퀀스 길이를 처리할 때 성능이 크게 저하되는 현상이 관찰된다. 예를 들어, 동일한 장면에 대해 이미지 수를 $N=100$에서 $N=1000$으로 늘릴 경우 reconstruction error가 약 5배 증가한다.
저자들은 학습 과정에서 사용되는 고정된 최적화 step 수(일반적으로 1회)가 훨씬 더 큰 규모의 장면 정보를 고정된 차원의 MLP로 압축하기에는 불충분하다고 가정하였다. 이를 확인하기 위해, 저자들은 두 가지 규모에서 TTT loss의 최적화 step별 성능을 분석했다 (20개 in-distribution, 1,000개 out-of-distribution).
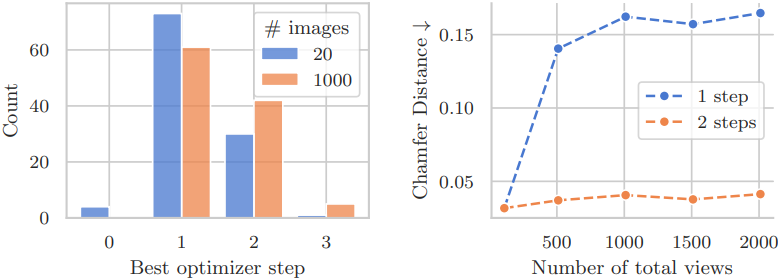
위 그림에서 볼 수 있듯이, 이미지 20개의 경우 1 step만으로도 충분한 반면, 1,000개의 경우에는 최적화 step을 늘리는 것이 유리하다. 단순히 최적화 step을 추가로 수행함으로써 임의의 시퀀스 길이에 대해 거의 일정한 scaling 특성을 얻을 수 있으며, 이는 추가 연산을 통한 test-time scaling의 한 형태를 보여준다. Step 수를 더 늘려도 품질 향상에는 도움이 되지 않으므로, 기본적으로 2 step을 수행한다.
2. Large-scale Reconstruction
장면 표현의 변경은 다음과 같은 장점이 있다.
Scalability
우선 연산 복잡도가 $O(n^2)$에서 $O(n)$으로 변화하여 기존 모델의 global attention layer에서 나타나는 병목 현상이 해소됨을 알 수 있다.
유연한 inference 전략
게다가 이러한 변화는 단일 GPU에서 임의의 대규모 이미지 컬렉션을 처리할 수 있게 해주는 inference 전략을 가능하게 하며, mini-batch 방식으로 TTT를 적용한 분산 inference를 통해 다중 GPU 환경에서 처리량을 선형적으로 가속화할 수 있게 한다.
TTT 최적화는 로컬 feature $K$를 $V$로 매핑하도록 MLP 가중치 $\theta$를 학습시키며, loss는 모든 입력 토큰 $i$에 대한 합으로 구성된다. 전체 최적화 loss가 단순히 로컬 loss들의 합이므로, MLP 가중치 $\theta$에 대한 loss의 전체 gradident 또한 로컬 gradident들의 합이 된다.
\[\begin{equation} \frac{d L_\textrm{total}}{d \theta} = \sum_i \frac{d}{d \theta} L (\textbf{k}_i, \textbf{v}_i) = \sum_s \left( \sum_{i \in s} \frac{d}{d \theta} L (\textbf{k}_i, \textbf{v}_i) \right) \end{equation}\]이는 loss의 gradident를 mini-batch $s$별로 독립적으로 계산할 수 있음을 의미한다. 분산 inference의 경우, 개별 GPU에서 mini-batch를 처리하고 gradident를 동기화할 수 있다. 이를 통해 시퀀스 데이터가 하나의 GPU의 메모리 용량을 초과하는 경우에도 효율적인 학습이 가능하다. 실제 구현 시에는 각 GPU가 전체 이미지의 일부인 부분집합 $s$만을 처리하도록 이미지를 sharding한다. 이후 global layer들에서는 위 식을 활용하여 GPU 간 MLP 가중치를 동기화하는데, 이때 MLP 가중치는 크기가 작아 효율적인 ‘all-to-all’ 통신 방식을 사용한다.
또한, 여러 GPU에 분산하는 대신, mini-batch를 호스트 메모리로 off-loading한다. 그런 다음, mini-batch를 한 번에 하나씩 디바이스 메모리로 로드하여 gradient를 계산하고 다시 호스트 메모리로 off-loading하는 방식으로 전체 시퀀스에 대한 업데이트를 수행할 수 있다. 이 과정에서는 디바이스 메모리에 한 번에 하나의 mini-batch만 유지하면 된다. Softmax attention에 의존하는 방식은 모든 이미지의 $q_i$, $k_i$, $v_i$를 GPU 메모리에 올려두어야 하므로, 대용량 GPU를 사용하더라도 더 큰 이미지 집합을 처리할 때 out-of-memory 오류가 발생하게 된다.
쿼리 가능한 reconstruction과 visual localization
특정 장면을 나타내는 일련의 이미지를 처리한 후, 모델에 새로운 관측 데이터를 입력하여 쿼리를 수행할 수 있다. 그러면 모델은 기존 reconstruction 결과와 비교하여 새로운 이미지의 장면 geometry와 카메라 포즈를 출력한다. 이를 위해 새로운 쿼리 이미지에 대해 forward pass를 수행하되, global attention layer 내에서 MLP 파라미터 $\theta$를 업데이트하지 않고, 고정된 MLP를 $q_i$에만 적용하여 장면 표현으로부터 정보를 추출한다. 이러한 쿼리 메커니즘을 통해 visual localization을 수행할 수 있다.
Experiments
1. Standard Benchmarks
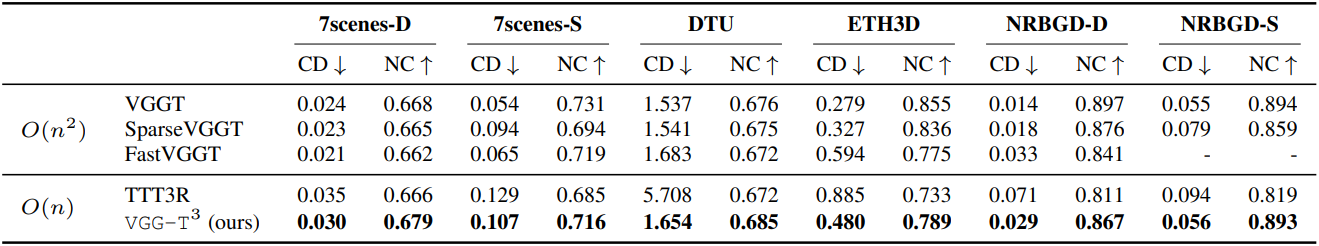
다음은 pointmap 추정에 대한 비교 결과이다. (D는 dense, S는 sparse)
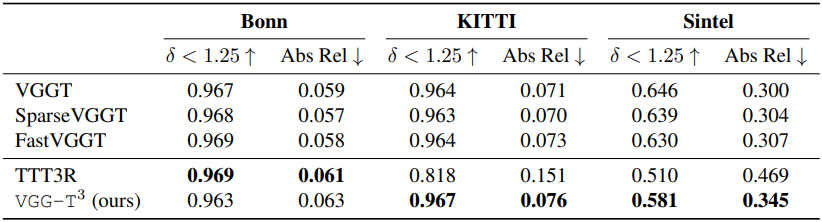
다음은 동영상 깊이 추정에 대한 비교 결과이다.
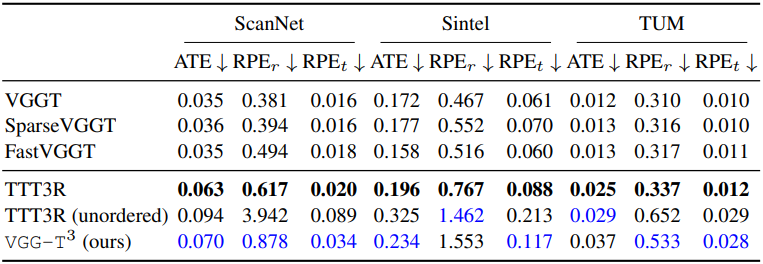
다음은 카메라 포즈 추정에 대한 비교 결과이다.
2. Large-Scale 3D Reconstruction
다음은 대규모 이미지 집합에 대한 비교 결과이다. (7scenes)
다음은 분산 inference 시의 latency를 비교한 결과이다.
3. Feed-forward Visual Localization
다음은 visual localization에 대한 비교 결과이다.
4. Ablations
다음은 ablation study 결과이다.