[논문리뷰] Global Structure-from-Motion Meets Feedforward Reconstruction
CVPR 2026 (Highlight). [Paper] [Page] [Github]
Linfei Pan, Johannes Schönberger, Marc Pollefeys
ETH Zurich | Meta Reality Labs | Microsoft
25 May 2026
Introduction
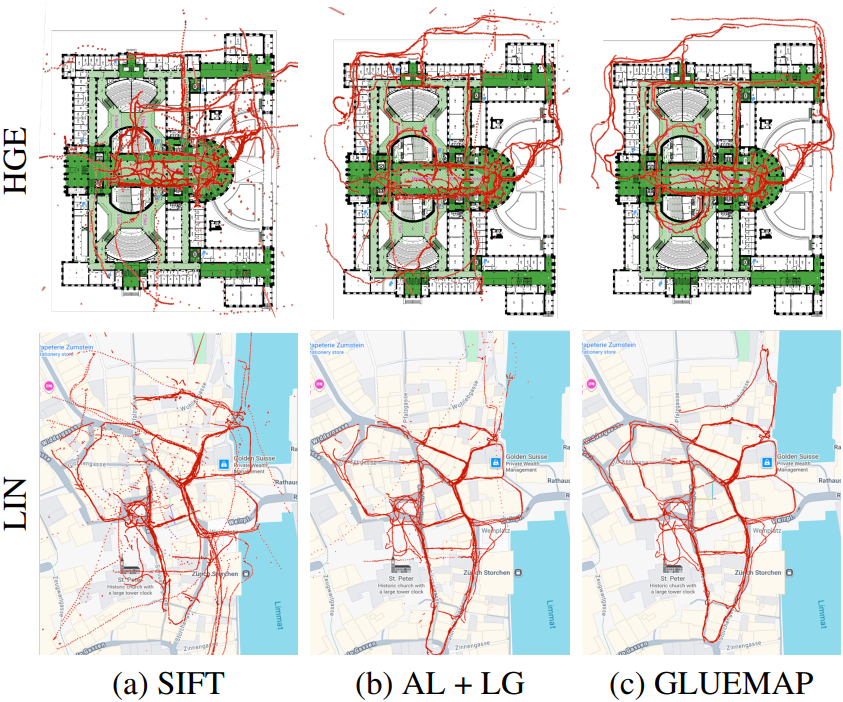
Structure-from-Motion (SfM)의 기술적 진보는 주로 최적화 기반 알고리즘에 의해 주도되어 왔으며, 본 논문에서는 이를 ‘전통적 방식’이라 부른다. 이러한 접근 방식들은 대체로 쌍별 feature point 매칭을 통한 correspondence 탐색과 robust한 최적화를 이용한 reconstruction으로 구성된다. 로컬 최적화와 글로벌 최적화를 반복하여 부분적인 reconstruction을 점진적으로 구축하는 방식과 달리, global reconstruction 방식은 통합 글로벌 최적화 단계에서 카메라 포즈와 장면 구조를 추정한다. Global reconstruction 방식은 일반적으로 실행 시간 측면의 scalability가 뛰어나고 대칭성 문제에 대해서도 더 높은 robustness를 보인다. 전통적 SfM 시스템은 입력 이미지가 sparse하게 배치되거나 시차(parallax)가 제한적이거나 혹은 매칭에 필요한 feature point가 충분하지 않은 경우에는 어려움을 겪는 경우가 많다.
전통적 방식의 한계를 극복하기 위해, 최근에는 3D reconstruction 파이프라인에서 모듈들을 학습된 feedforward 구성 요소로 대체하고 있으며, 동시에 기존의 최적화 기법은 계속 활용하고 있다. 또한, 대규모 모델 학습의 발전에 힘입어, 하나의 feedforward 아키텍처를 사용하여 멀티뷰 3D reconstruction 문제를 end-to-end로 해결함으로써 솔버와 최적화 기법의 필요성을 효과적으로 제거하고 있다.
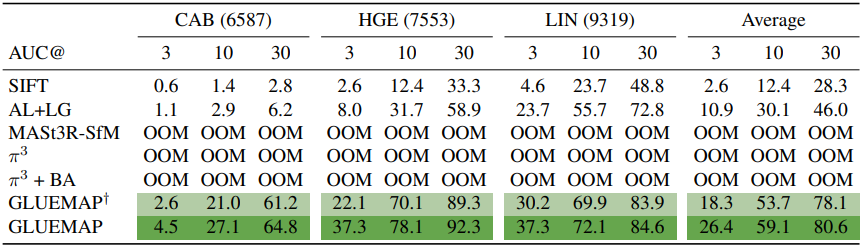
하지만 무거운 transformer 기반 아키텍처에 의존하기 때문에 메모리 요구량이 높아져 scalability가 제한되고, 상대적으로 낮은 이미지 해상도에서 입력 뷰를 수백 개 정도로 제한되어 정확도가 떨어진다. 최근 이러한 scalability 문제를 해결하려는 노력이 있었지만, 여전히 천 개 이상의 이미지를 처리하는 데 어려움을 겪고 있다. 전통적 방식이 성공적인 시나리오에서도 feedforward 방식은 일반적으로 정확도 측면에서 크게 뒤처진다. Feedforward 방식이 전통적 방식의 성능에 근접하는 경우는 최적화 기반 bundle adjustment (BA)를 통해 이루어지며, 이는 격차를 부분적으로만 해소할 뿐이다. Robustness 측면에서, 기존 방법 중 어느 것도 여러 개의 connected component들을 안정적으로 처리하거나, 대칭 구조를 해결하거나, 관련 없는 입력 이미지와 같은 outlier를 체계적으로 제거할 수 없다.
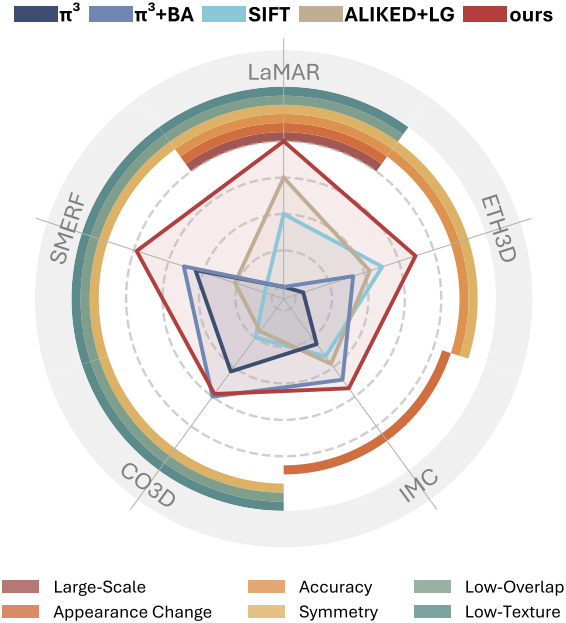
본 논문에서는 전통적 방식과 feedforward 방식의 3D reconstruction 기법이 가진 한계를 분석하였다. 이를 바탕으로 각 방식의 장점을 결합한 새로운 파이프라인을 제안하였으며, 폭넓은 시나리오에서 SOTA 성능을 달성했다.
Method
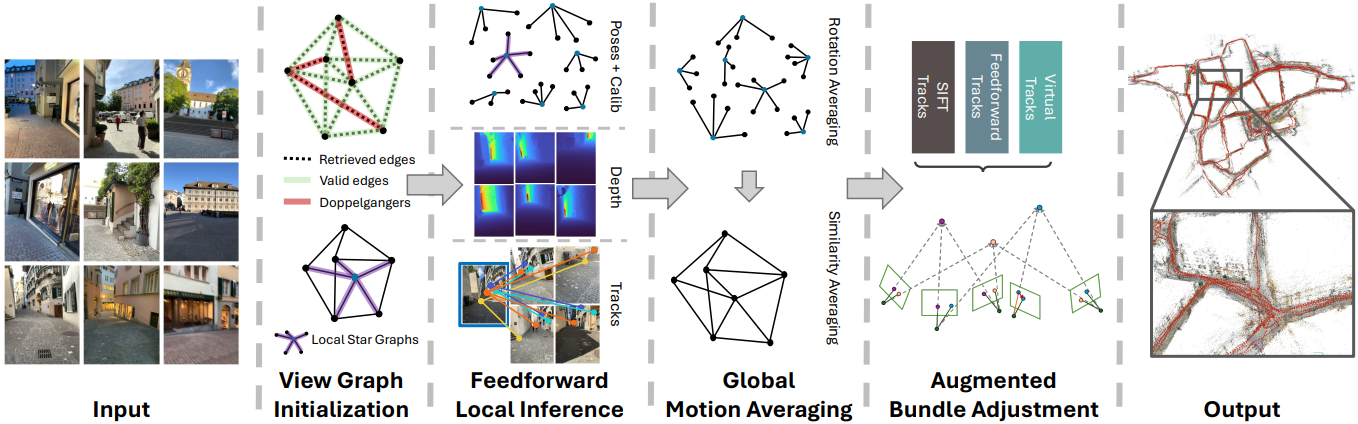
본 시스템은 순서가 지정되지 않은 이미지 집합 \(\mathcal{I} = \{I_i \in \mathbb{R}^{H_i \times W_i \times 3}\}_{i=1}^n\)을 입력으로 받아, 신뢰도 높게 정합된 이미지의 부분 집합 $I^\ast$에 대해 장면 포인트 \(\mathcal{X} = \{X_k \in \mathbb{R}^3\}_{k=1}^m\), 카메라 포즈 \(\mathcal{P} = \{P_i = (R_i, t_i) \in SE(3) \mid i \in I^\ast\}\), 그리고 intrinsic \(\mathcal{K} = \{\pi_i : \mathbb{R}^3 \rightarrow \mathbb{R}^2 \mid i \in I^\ast\}\)를 추정한다.
1. View Graph Initialization
모든 이미지에 대해 global attention을 수행하는 일반적인 feedforward 방식 대신, 생성된 sparse view graph $G(\mathcal{I}, \mathcal{E})$를 활용하여 로컬한 범위에서만 feedforward reconstruction을 수행한다. 이러한 방식은 메모리 부족 문제를 방지하고 다수의 로컬 reconstruction을 병렬로 일괄 처리함으로써, 임의 개수의 입력 이미지에 대해서도 효율적으로 확장할 수 있게 해준다. 나아가 가장 관련성 높은 정보에만 집중하고 명시적인 필터링을 적용함으로써, 정확도가 크게 향상되고 대칭성 문제에 대해서도 더욱 robust한 성능을 확보할 수 있다.
구체적으로, 각 입력 이미지 $I_i$에 대해 SALAD를 사용하여 고정된 개수 $c$개의 후보 이웃 \(\mathcal{C}_i\)를 검색하여 총 $O(c·n)$개의 후보 쌍을 얻는다. 그런 다음, 각 쌍 \((i, j), j \in \mathcal{C}_i\)에 대해 잠재적으로 겹치지 않는 Doppelganger edge들을 식별한다.
\[\begin{equation} \alpha_{ij} = \textrm{DG} (I_i, I_j) \end{equation}\](\(\alpha_{ij}\)는 Doppelgangers++ 점수)
로컬 연결성을 보장하기 위해 다음과 같이 \(\alpha_{ij}\)에 동적 thresholding을 적용한다. \(\mathcal{E}_{t=0} = \emptyset\)인 빈 view graph $G_{t=0}$에서 시작하여, 서로 다른 connected component $\textrm{CC}(i)$ 사이에 edge를 반복적으로 추가한다.
\[\begin{equation} \mathcal{E}_{t+1} = \mathcal{E}_t \cup \{ (i,j) \mid \alpha_{ij} > \delta_t, \textrm{CC} (i) \ne \textrm{CC} (j) \} \end{equation}\]초기 필터링 threshold \(\delta_0 = 0.8\)로 시작한다. 업데이트된 그래프 $G_{t+1}$이 연결되어 있으면 iteration을 중단하고 해당 그래프를 채택한다. 그렇지 않은 경우, threshold를 0.1만큼 낮춘다. \(\delta_t\)가 0.2보다 작아지면 iteration을 중단하고 가장 큰 connected component를 유지한다. 최종 view graph $G_T$는 각 이미지 $l$에 대한 로컬 이웃을 \(\mathcal{N}_l = \{l\} \cup \{m \mid (l, m) \in \mathcal{E}_T\}\)로 정의한다.
2. Feedforward Local Inference
다음으로, 확립된 view graph로부터 feedforward reconstruction이 진행된다. 이를 위해 view graph는 local star graph $S_l$로 분해되며, 이를 각각 독립적인 batch로 reconstruction한다.
\[\begin{equation} S_l = G(\mathcal{N}_l, \{(l, m) \mid m \in \mathcal{N}_l, l \ne m\}) (\mathcal{P}_l, \mathcal{F}_l, \mathcal{D}_l, \mathcal{T}_l) = \textrm{FF} (I_{\mathcal{N}_l}) \end{equation}\](\(\mathcal{P}_l\)은 로컬 포즈 집합, \(\mathcal{F}_l\)은 초점 거리 집합, \(\mathcal{D}_l\)은 depth map 집합, \(\mathcal{T}_l\)는 track 집합)
$\textrm{FF}$로는 $\pi^3$ (FF)를 사용하며, 이웃의 수가 25개를 초과하는 경우, DG 점수가 가장 높은 25개의 프레임을 유지한다.
각 이미지는 \(\vert \mathcal{N}_l \vert\)개의 local star graph에 포함되므로, 로컬 reconstruction 결과들이 서로 중첩된다. Local star graph 간에 중첩된 track을 병합하기 위해, track 위치를 반경 1px 이내의 SIFT keypoint에 snap시키고 동일한 keypoint에 일치하는 track들을 하나로 합친다. 모든 star graph에 대해 병합한 track 집합을 $\mathcal{T}$라 하자.
각 local star graph에 대해 시각적 중첩을 확인하기 위해 forward-backward 깊이 일관성 검사를 추가로 수행한다. 구체적으로, local star graph $S_l$의 임의의 이미지 $i$에서 $j$로의 단방향 reprojection error \(\epsilon_{i \rightarrow j}\)를 다음과 같이 계산한다.
\[\begin{aligned} X_i &= D_i (x, y) \cdot (u, v, 1)^\top \\ (x^\prime, y^\prime)^\top &= \Pi_j (R_{ij} X_i + t_{ij}) \\ X_j &= D_j (x^\prime, y^\prime) \cdot (u^\prime, v^\prime, 1)^\top \\ (x^{\prime \prime}, y^{\prime \prime})^\top &= \Pi_i (R_{ij} X_j + t_{ij}) \\ \epsilon_{i \rightarrow j} &= \| (x, y)^\top - (x^{\prime \prime}, y^{\prime \prime})^\top \|_2 \end{aligned}\]($(x, y) \in \mathbb{R}^2$는 픽셀 이미지 좌표, $(u, v, 1) = \pi^{-1}(x, y)$는 정규화된 좌표)
Reprojection threshold $\tau$를 사용하여, $S_l$ 내의 $i$와 $j$ 사이의 중첩 비율 \(\tilde{o}_{ij}^l\)을 다음과 같이 정의한다.
\[\begin{equation} \tilde{o}_{ij}^l = \frac{1}{W_i H_i} \cdot \sum_{(x,y) \in H_i \times W_i} \unicode{x1D7D9} (\epsilon_{i \rightarrow j} < \tau) \end{equation}\]Co-visibility을 측정하기 위해, $o_{ij}^l$를 다음과 같이 정의한다.
\[\begin{equation} o_{ij}^l = \max_{\tilde{\mathcal{O}} \in \mathcal{O}_{ij}} \prod_{(p,q) \in \tilde{\mathcal{O}}} \tilde{o}_{pq}^l \end{equation}\](\(\mathcal{O}_{ij}\)는 \(\mathcal{N}_l\)상의 완전 연결 그래프에서 이미지 $i$와 $j$ 사이의 모든 경로)
$o_{ij}^l$ 값이 작은 edge에 대해, 이를 제거할 경우 view graph의 연결성이 끊어지지 않는 한 필터링한다.
3. Global Motion Averaging
이 단계에서는 global SfM 기법을 사용하여 $n$개의 독립적인 로컬 reconstruction을 하나의 글로벌 reconstruction으로 병합한다. 구체적으로, 카메라 intrinsic, rotation, 카메라 중심은 각각 intrinsic averaging, rotation averaging, similarity averaging을 통해 추정된다.
Intrinsic averaging의 경우, 카메라별로 추정된 모든 초점 거리의 중앙값을 계산한다.
Rotation averaging의 경우, relative rotation $R_{ij}$의 집합으로부터 global rotation $R_i$를 최적화하여 추정한다.
\[\begin{equation} \min_R \sum_{(i,j) \in E} \rho (o_{ij}^l \cdot d (R_{ij}^l, R_j R_i^\top)) \end{equation}\]($d$는 geodesic error function, $\rho$는 Huber loss, $R_{ij}^l$는 $S_l$ 내에서 로컬하게 추정된 카메라 포즈로부터 도출된 relative rotation)
Rotation averaging 후, similarity averaging을 사용하여 카메라 중심 $c_i \in \mathbb{R}^3$을 추론한다. Relative translation은 다음과 같이 계산할 수 있다.
\[\begin{equation} t_{ij}^l = s^l \cdot R_{ij}^l (c_i - c_j) \end{equation}\]$S_l$ 내의 relative translation은 스케일 일관성을 가지므로 각 star graph에 대해 하나의 scale $s_l$만 필요하다. 카메라 중심 $c_i$와 star scale $s_l$은 다음과 같이 추정된다.
\[\begin{equation} \min_{c,s} \sum_{l, (i,j) \in S_l} o_{ij} \cdot d \left( R_{ij}^\top t_{ij} - s_l \cdot (c_i - c_j) \right), \quad s_0 = 1 \end{equation}\]각 edge의 가중치를 중첩 비율 $o_{ij}^l$로 설정한 maximum spanning tree를 사용하여 이 최적화 과정을 초기화한다.
마지막으로, $S_l$ 내 이미지 $i$에 대한 depth map \(\tilde{D}_i^l\)을 \(\tilde{D}_i^l = \frac{1}{s_l} D_i^l\)로 계산하여 글로벌하게 일관된 depth map을 얻을 수 있다.
4. Augmented Bundle Adjustment
최종 reconstruction의 정확도는 augmented bundle adjustment (BA)이라고 하는 프로세스를 통해 향상된다. 표준 BA 공식은 멀티뷰 중첩이 있는 track $\mathcal{T}$가 충분히 많을 때만 사용 가능하다. 중첩이 적은 뷰 구성으로 인해 이론적으로 완벽한 매칭 알고리즘을 사용하더라도 이러한 track을 설정하는 것이 불가능할 수 있다. 또한, 충분한 중첩이 있더라도 낮은 텍스처 품질로 인해 실제로는 충분한 중첩을 가진 track을 생성하지 못할 수 있다.
이와 대조적으로, 멀티뷰 feedforward 모델은 정교한 장면 prior를 활용하여 두 개의 뷰 또는 때로는 뷰 중첩이 전혀 없는 경우에도 정확한 카메라 포즈와 일관된 depth map을 추론함으로써 이러한 단점을 극복할 수 있다. 저자들은 다음과 같이 표준 BA 공식을 virtual track으로 증강하여 이러한 장면 prior를 인코딩하였다.
각 star graph의 중심 이미지 $l$에서 샘플링된 픽셀 $(x, y)$을 reprojection하여 두 가지 유형의 virtual track을 생성한다.
\[\begin{equation} \mathcal{V}_{l \rightarrow m}^l = \Pi_m \left( R_{lm}^l \left( \tilde{D}_l^l (x, y) \cdot \Pi_l^{-1} (x, y) - c_{lm}^l \right) \right) \\ \tilde{\mathcal{V}}_{l \rightarrow m}^l = \Pi_m \left( R_m \left( R_l^\top \tilde{D}_l^l \cdot \Pi_l^{-1} (x, y) + c_l \right) - c_m \right) \\ \mathcal{V} = \{ \mathcal{V}_{l \rightarrow m}^l \mid m \in \mathcal{N}_l, l \ne m\}, \quad \tilde{\mathcal{V}} = \{ \tilde{\mathcal{V}}_{l \rightarrow m}^l \mid m \in \mathcal{N}_l, l \ne m\} \end{equation}\]생성된 \(\vert \mathcal{N}_l \vert\)-view track $\mathcal{V}$와 $\tilde{\mathcal{V}}$는 feedforward 방식의 로컬 inference와 global motion averaging 결과에서 얻은 각 포즈를 조건으로 한다. 일반적인 feature track과 달리, 여기서는 virtual track이 인접 이미지의 영역을 벗어나 projection되는 것을 허용하며, 가상 3D 포인트가 인접 카메라의 뒤쪽에 위치할 수도 있다. 수치적 안정성을 위해 최적화 과정에서는 imaging plane과 일치하는 관측치를 무시한다.
저자들은 약 100개의 virtual track을 샘플링하되, 그중 10%는 글로벌 카메라 포즈를 조건으로 설정하도록 했다. 직관적으로 볼 때, 글로벌 포즈를 조건으로 하는 track의 비율이 높을수록 BA 결과는 global motion averaging의 출력값에 더 가까워진다.
최종 augmented BA 문제에서는 세 가지 유형의 track, 즉 feedforward 네트워크에서 얻은 track $\mathcal{T}$, virtual $\mathcal{V}$와 $\tilde{\mathcal{V}}$, 그리고 일반적인 SIFT track을 사용한다. 모든 이미지에 대해 표준 reprojection cost function $\Pi$를 사용하되, SIFT track과 feedforward track에는 Huber 함수를, virtual track에는 Arctan 함수를 robustifier로 적용한다. Track $\mathcal{T}$를 snap하는 과정에서 SIFT feature point를 부수적으로 얻을 수 있다. Virtual track의 3차원 위치는 구성 방식에 의해 이미 알고 있는 반면, 나머지 track의 위치는 triangulation을 통해 산출된다.
Experiments
1. Feedforward Graph Analysis
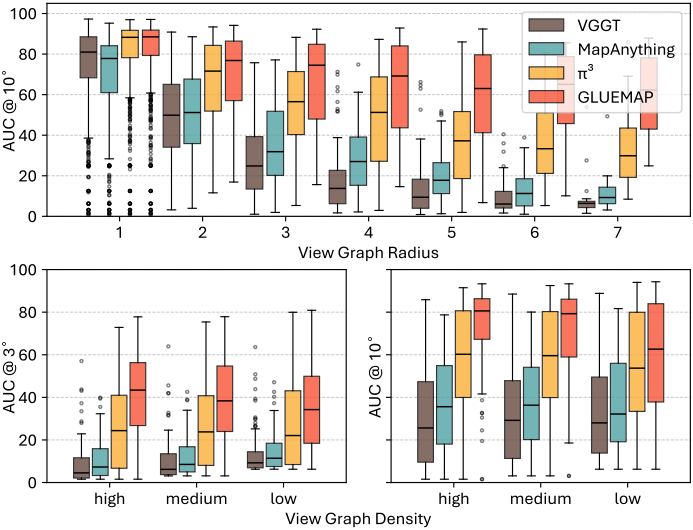
다음은 view graph 반경과 밀도에 대한 비교 결과이다.
2. Comparative Analysis on Real-World Datasets
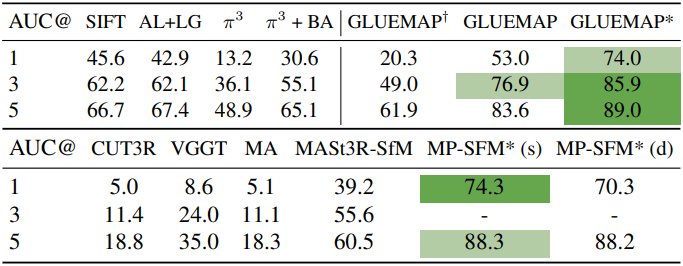
다음은 ETH3D에서의 결과이다.
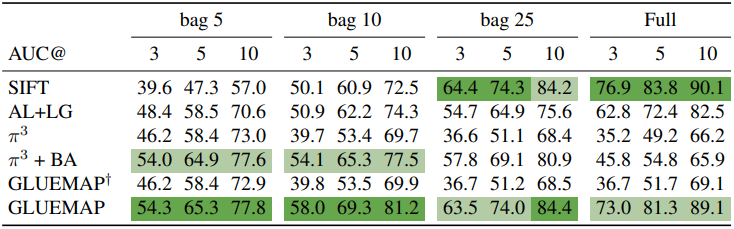
다음은 IMC2021에서의 결과이다.
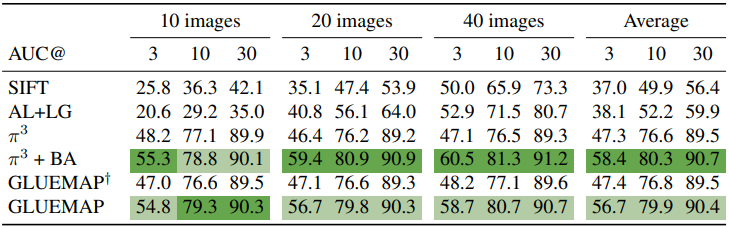
다음은 CO3Dv2에서의 결과이다.
다음은 SMERF 벤치마크에서의 결과이다.
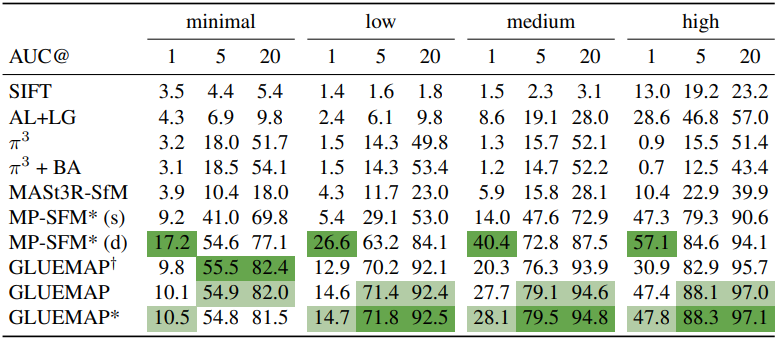
다음은 LaMAR에서의 결과이다.