[논문리뷰] DiffusionNFT: Online Diffusion Reinforcement with Forward Process
ICLR 2026 (Oral). [Paper] [Page] [Github]
Kaiwen Zheng, Huayu Chen, Haotian Ye, Haoxiang Wang, Qinsheng Zhang, Kai Jiang, Hang Su, Stefano Ermon, Jun Zhu, Ming-Yu Liu
Tsinghua University | NVIDIA | Stanford University
19 Sep 2025
Introduction
GRPO 방식의 diffusion RL은 여전히 다음과 같은 근본적인 한계에 직면해 있다.
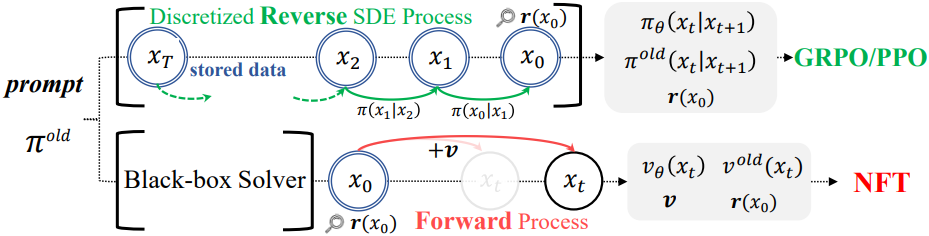
- Forward 불일치: Reverse process에만 집중하면 forward process를 준수하지 못하게 되어 모델이 cascaded Gaussian으로 퇴화할 위험이 있다.
- Solver 제약: 데이터 수집 과정은 first-order SDE sampler에 의존하므로, flow model에 기본적으로 사용되고 효율성에 유리한 ODE 또는 high-order solver를 충분히 활용할 수 없다.
- 복잡한 CFG 통합: Diffusion model은 conditional 모델과 unconditional 모델 모두를 학습해야 하는 CFG에 크게 의존한다. 현재의 RL 방식은 일반적으로 CFG를 post-training에 통합하여 복잡하고 비효율적인 두 모델 최적화 방식을 사용한다.
본 논문은 diffusion RL에서 데이터 수집 과정을 분리하고, solver에 대한 제약을 제거하며, 표준적인 supervised pretraining과의 일관성을 유지하는 것을 목표로 한다. Forward process는 하나로 고정되어 있는데, reverse process는 sampler/solver 선택에 따라 여러 방식이 가능하다. 그래서 reverse trajectory에 직접 RL을 적용하면 어느 sampler를 policy로 볼 것인가에 따라 학습 대상과 gradient가 달라진다.
본 논문은 Diffusion Negative-aware FineTuning (DiffusionNFT)이라는 새로운 online RL 패러다임을 제안하였다. DiffusionNFT는 기존의 policy gradient 프레임워크를 따르는 대신, flow matching loss를 통해 forward process에서 직접 policy 최적화를 수행한다. 이 방법은 reward를 기준으로 구분된 positive 샘플과 negative 샘플로부터 학습된 두 implicit policy 간의 개선 방향을 정의하며, 샘플링 프로세스를 변경하지 않고 positive policy를 향해 최적화를 진행한다.
Forward-process RL 공식은 여러 가지 실질적인 이점을 제공한다.
- First-order SDE sampler에 의존하는 대신 임의의 solver를 사용하여 데이터를 수집할 수 있다.
- 전체 샘플링 궤적을 저장할 필요 없이 policy 최적화를 위해 깨끗한 이미지만 필요하다.
- 표준 diffusion 학습과 완벽하게 호환되므로 기존 코드를 최소한으로 수정하면 된다.
- DiffusionNFT는 기본적으로 off-policy 알고리즘이므로 중요도 샘플링 없이도 학습시키는 policy와 샘플링 policy를 분리할 수 있다.
Method
1. Problem Setup
Online RL
사전 학습된 diffusion policy \(\pi^\textrm{old}\)와 프롬프트 데이터셋 \(\{\textbf{c}\}\)를 고려해 보자. 각 iteration에서 프롬프트 $\textbf{c}$에 대해 $K$개의 이미지 \(\textbf{x}_0^{1:K}\)를 샘플링한 다음, 최적성 확률을 나타내는 스칼라 reward function \(r(\textbf{x}_0, \textbf{c}) := p(\textbf{o} = 1 \vert \textbf{x}_0, \textbf{c})\)을 사용하여 각 이미지를 평가한다.
수집된 데이터는 무작위로 두 개의 가상 부분집합으로 나눌 수 있다. 이미지 \(\textbf{x}_0\)는 확률 $r$로 positive 데이터셋 \(\mathcal{D}^{+}\)에 속하게 되며, 그렇지 않은 경우에는 negative 데이터셋 \(\mathcal{D}^{-}\)에 속하게 된다. 무한한 수의 샘플이 주어졌을 때, 이 두 부분집합의 분포는 각각 다음과 같다.
\[\begin{equation} \pi^{+} (\textbf{x}_0 \vert \textbf{c}) := \pi^\textrm{old} (\textbf{x}_0 \vert \textbf{o} = 1, \textbf{c}) = \frac{p(\textbf{o} = 1 \vert \textbf{x}_0, \textbf{c}) \pi^\textrm{old} (\textbf{x}_0 \vert \textbf{c})}{p_{\pi^\textrm{old}} (\textbf{o} = 1 \vert \textbf{c})} = \frac{r (\textbf{x}_0, \textbf{c})}{p_{\pi^\textrm{old}} (\textbf{o} = 1 \vert \textbf{c})} \pi^\textrm{old} (\textbf{x}_0 \vert \textbf{c}) \\ \pi^{-} (\textbf{x}_0 \vert \textbf{c}) := \pi^\textrm{old} (\textbf{x}_0 \vert \textbf{o} = 0, \textbf{c}) = \frac{p(\textbf{o} = 0 \vert \textbf{x}_0, \textbf{c}) \pi^\textrm{old} (\textbf{x}_0 \vert \textbf{c})}{p_{\pi^\textrm{old}} (\textbf{o} = 0 \vert \textbf{c})} = \frac{1 - r (\textbf{x}_0, \textbf{c})}{1 - p_{\pi^\textrm{old}} (\textbf{o} = 1 \vert \textbf{c})} \pi^\textrm{old} (\textbf{x}_0 \vert \textbf{c}) \end{equation}\]RL은 각 iteration마다 policy improvement를 수행해야 한다. 최적화된 policy $\pi^\ast$는 다음 조건을 만족한다.
\[\begin{equation} \mathbb{E}_{\pi^\ast (\cdot \vert \textbf{c})} r(\textbf{x}_0, \textbf{c}) > \mathbb{E}_{\pi^\textrm{old} (\cdot \vert \textbf{c})} r(\textbf{x}_0, \textbf{c}) \end{equation}\]간단하게 \(\pi^\ast \succ \pi^\textrm{old}\)로 표기한다.
Reinforcement Guidance
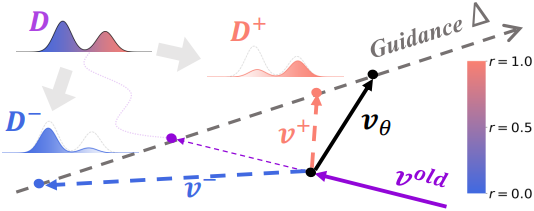
$\pi^\ast$를 최적화의 대상으로 취급하는 대신, negative 데이터와 positive 데이터를 모두 활용하여 개선 방향 $\Delta \in \mathbb{R}^n$을 도출한다. 학습 loss는 다음과 같이 정의된다.
\[\begin{equation} \textbf{v}^\ast (\textbf{x}_t, \textbf{c}, t) := \textbf{v}^\textrm{old} (\textbf{x}_t, \textbf{c}, t) + \frac{1}{\beta} \Delta (\textbf{x}_t, \textbf{c}, t) \end{equation}\]($\textbf{v}$는 diffusion model의 velocity predictor, $\beta$는 hyperparameter)
이러한 정의는 Classifier-Free Guidance (CFG)와 같은 diffusion guidance의 형태와 유사하다. \(\Delta (\textbf{x}_t, \textbf{c}, t) \in \mathbb{R}^n\)을 reinforcement guidance라 부르고, $1/\beta \in \mathbb{R}$을 guidance strength라고 부른다.
2. Negative-aware Diffusion Reinforcement with Forward Process
$\Delta$는 개선된 policy와 원래 policy의 분포 변화에 해당한다. 이를 정형화하기 위해, 먼저 \(\pi^{+} \succ \pi^\textrm{old} \succ \pi^{-}\) 사이의 분포 차이를 살펴보자.
Improvement Direction
Policy triplet $\pi^+$, $\pi^-$, $\pi_{\text{old}}$에 대한 diffusion model $v^+$, $v^-$, $v_{\text{old}}$를 고려해 보자. 이 모델들 간의 방향적 차이는 비례 관계에 있다.
\[\begin{equation} \Delta := [1 - \alpha (\textbf{x}_t)] [\textbf{v}^\textrm{old} (\textbf{x}_t, \textbf{c}, t) - \textbf{v}^{-} (\textbf{x}_t, \textbf{c}, t)] = \alpha (\textbf{x}_t) [\textbf{v}^{+} (\textbf{x}_t, \textbf{c}, t) - \textbf{v}^\textrm{old} (\textbf{x}_t, \textbf{c}, t)] \\ \textrm{where} \quad \alpha (\textbf{x}_t) := \frac{\pi_t^{+} (\textbf{x}_t \vert \textbf{c})}{\pi_t^\textrm{old} (\textbf{x}_t \vert c)} \mathbb{E}_{\pi^\textrm{old} (\textbf{x}_0 \vert \textbf{c})} r (\textbf{x}_0, \textbf{c}) \in [0, 1] \end{equation}\]위 식은 $v^\textrm{old}$를 개선하기 위한 이상적인 guidance 방향 $\Delta$를 나타낸다. 적절한 guidance strength를 설정하면 policy improvement를 보장할 수 있다. 예를 들어, \(\beta = \alpha (\textbf{x}_t)\)로 설정하면 \(\textbf{v}^\ast = \textbf{v}^{+}\)가 되어, \(\pi^\ast = \pi^{+} \succ \pi^\textrm{old}\)라는 관계가 성립한다.
Policy Optimization
\(\textbf{v}_\theta\)를 \(\textbf{v}^\ast\) 방향으로 직접 최적화하는 다음과 같은 학습 loss를 고려해 보자.
\[\begin{equation} \mathcal{L}(\theta) = \mathbb{E}_{\textbf{c}, \pi^\textrm{old} (\textbf{x}_0 \vert \textbf{c}), t} r \| \textbf{v}_\theta^{+} (\textbf{x}_t, \textbf{c}, t) - \textbf{v} \|_2^2 + (1 - r) \| \textbf{v}_\theta^{-} (\textbf{x}_t, \textbf{c}, t) - \textbf{v} \|_2^2 \\ \textrm{where} \quad \textbf{v}_\theta^{+} (\textbf{x}_t, \textbf{c}, t) := (1 - \beta) \textbf{v}^\textrm{old} + \beta \textbf{v}_\theta (\textbf{x}_t, \textbf{c}, t) \quad (\textrm{Implicit positive policy}) \\ \textrm{and} \quad \textbf{v}_\theta^{-} (\textbf{x}_t, \textbf{c}, t) := (1 + \beta) \textbf{v}^\textrm{old} - \beta \textbf{v}_\theta (\textbf{x}_t, \textbf{c}, t) \quad (\textrm{Implicit negative policy}) \end{equation}\]($\textbf{v} = \boldsymbol{\epsilon} - \textbf{x}_0$는 target velocity)
무제한의 데이터와 모델 용량이 주어질 때, \(\mathcal{L}(\theta)\)의 최적해는 다음을 만족한다.
\[\begin{equation} \textbf{v}_{\theta^\ast} (\textbf{x}_t, \textbf{c}, t) = \textbf{v}^\textrm{old} (\textbf{x}_t, \textbf{c}, t) + \frac{2}{\beta} \Delta (\textbf{x}_t, \textbf{c}, t) \end{equation}\]이 방법은 Policy Gradient를 적용하는 대신 supervised learning (SL) loss를 채택하되, negative 데이터 \(\mathcal{D}^{-}\)를 활용한 추가 학습을 수행한다. 이러한 방식은 알고리즘의 범용성을 높여 기존 SL 방법들과 호환될 수 있게 한다. 이 방법은 언어 모델 분야의 NFT와 개념적으로 유사하기 때문에 DiffusionNFT라 부른다.
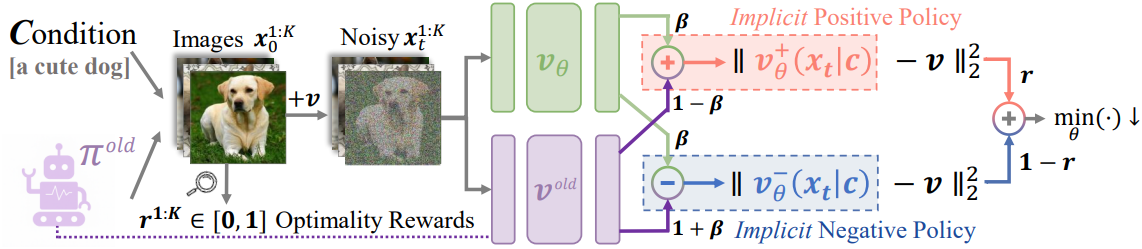
DiffusionNFT는 몇 가지 독보적인 장점을 가지고 있다.
- Forward process에서 일반적인 diffusion loss를 정의하기 때문에, 학습된 모델이 유효한 forward process에 대응하도록 보장한다.
- Policy 학습과 데이터 샘플링을 완전히 분리한다. 따라서 샘플링 전반에 걸쳐 임의의 solver를 활용할 수 있다. 또한 데이터 수집 중에 전체 샘플링 궤적을 저장할 필요가 없으며, 학습에는 reward가 포함된 깨끗한 이미지만 필요하다.
- 별도의 모델 없이, 하나의 policy 모델에 대해 RL을 지속적으로 수행할 수 있도록 해주며, 이는 online RL에 매우 중요하다.
- 근본적으로 likelihood 근사에 의존하는 기존의 diffusion RL 방법과 달리, DiffusionNFT는 본질적으로 likelihood에 의존하지 않으므로 근사를 우회한다.
3. Practical Implementation
Optimality Reward
대부분의 visual RL 환경에서 reward는 binary 신호가 아닌, 연속적인 스칼라 값으로 나타난다. 기존의 GRPO 방식에 착안하여, raw reward \(r^\textrm{raw}\)를 최적성 확률을 나타내는 $r$로 변환한다.
\[\begin{equation} r(\textbf{x}_0, \textbf{c}) := \frac{1}{2} + \frac{1}{2} \textrm{clip} \left[ \frac{r^\textrm{raw} (\textbf{x}_0, \textbf{c}) - \mathbb{E}_{\pi^\textrm{old} (\cdot \vert \textbf{c})} r^\textrm{raw} (\textbf{x}_0, \textbf{c})}{Z_\textbf{c}}, -1, 1 \right] \end{equation}\](\(Z_\textbf{c} > 0\)는 global reward std와 같은 normalizing factor)
데이터 수집 중에 각 프롬프트 $\textbf{c}$에 대해 $K$개의 이미지를 샘플링하므로, 각 프롬프트에 대한 평균 reward \(\mathbb{E}_{\pi^\textrm{old} (\cdot \vert \textbf{c})} r^\textrm{raw} (\textbf{x}_0, \textbf{c})\)를 추정할 수 있다.
Soft Update of Sampling Policy
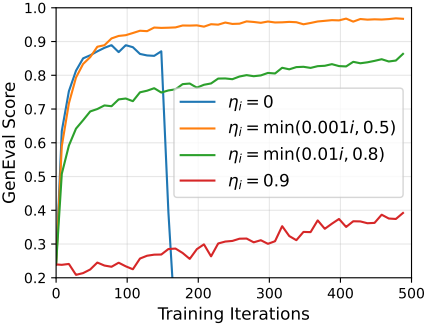
DiffusionNFT의 off-policy 특성은 샘플링 policy \(\pi^\textrm{old}\)와 학습시키는 policy \(\pi_\theta\)를 분리한다. 이는 매 iteration $i$마다 \(\pi^\textrm{old}\)를 직접 업데이트할 필요를 없애준다. 대신, 이러한 특성을 활용하여 EMA 업데이트를 적용한다.
\[\begin{equation} \theta^\textrm{old} \leftarrow \eta_i \theta^\textrm{old} + (1 - \eta_i) \theta \end{equation}\]파라미터 $\eta$는 학습 속도와 안정성 간의 trade-off를 조절한다. 엄격한 on-policy 방식($\eta = 0$)은 초기 학습은 빠르지만 심각한 불안정성을 보이기 쉽다. 반면, offline 방식에 가까운 방식($\eta \rightarrow 1$)은 안정성은 뛰어나지만 수렴 속도가 지나치게 느려 실용적이지 않다.
Adaptive Loss Weighting
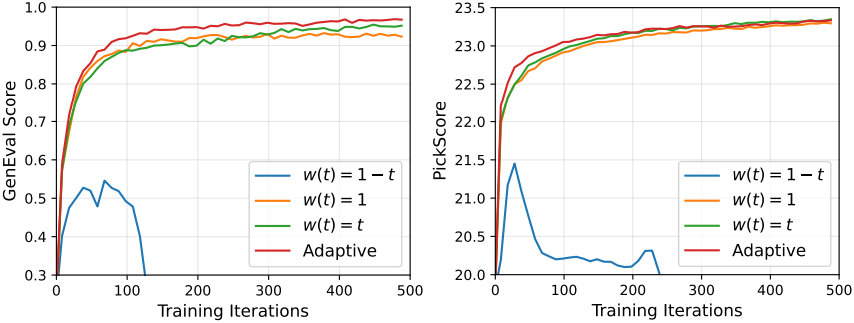
일반적인 diffusion loss는 time-dependent weighting $w(t)$를 포함한다. 저자들은 수동적인 튜닝 대신 적응형 방식을 채택하였다. Velocity predictor \(\textbf{v}_\theta\)는 \(\textbf{x}_0\) predictor \(\textbf{x}_\theta\)로 등가 변환될 수 있다. 저자들은 diffusion distillation 기법인 DMD에서 착안하여, 해당 가중치를 다음과 같이 대체하였다.
\[\begin{equation} w(t) \| \textbf{v}_\theta (\textbf{x}_t, \textbf{c}, t) - \textbf{v} \|_2^2 \leftarrow \frac{\| \textbf{x}_\theta (\textbf{x}_t, \textbf{c}, t) - \textbf{x}_0 \|_2^2}{\textrm{sg} (\textrm{mean} (\textrm{abs} (\textbf{x}_\theta (\textbf{x}_t, \textbf{c}, t) - \textbf{x}_0)))} \end{equation}\]CFG-Free Optimization
CFG는 inference 시 생성 품질을 높이기 위한 기법이지만, post-training 과정을 복잡하게 만들고 효율성을 저하시킨다. 저자들은 CFG를 reinforcement guidance $\Delta$의 offline 형태로 해석하였으며, 이때 conditional 모델과 unconditional 모델은 각각 positive 신호와 negative 신호에 대응한다. 이러한 관점에 따라 알고리즘 설계 시 CFG를 배제하고, 오직 conditional 모델만을 사용하여 policy를 초기화한다.
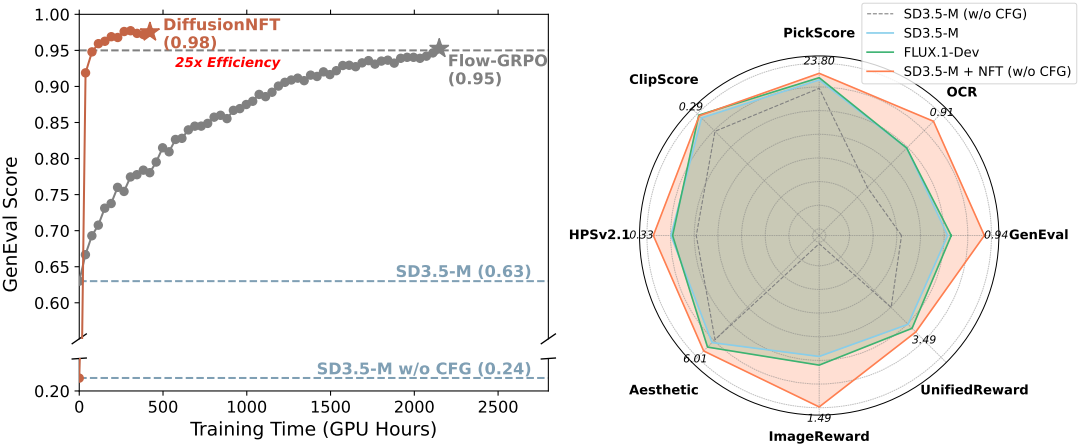
초기화 상태가 다소 불리해 보임에도 불구하고, 실제로는 성능이 급격히 향상되어 CFG 기반의 baseline을 빠르게 능가한다. 이는 CFG의 기능이 RL post-training을 통해 효과적으로 학습되거나 대체될 수 있음을 시사한다.
Experiments
- Base model: SD3.5-Medium (512$\times$512)
1. Multi-Reward Joint Training
다음은 5개의 reward (GenEval, OCR, PickScore, ClipScore, HPSv2.1)에 대하여 공동 최적화한 결과이다. (회색은 in-domain reward)
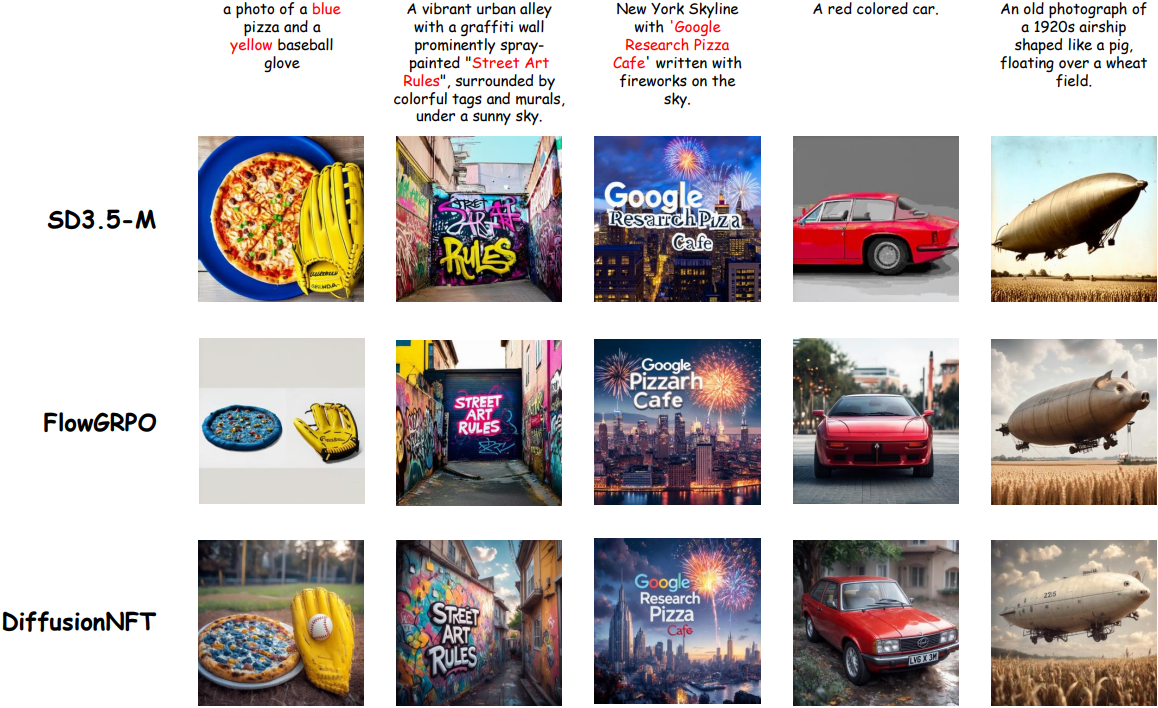
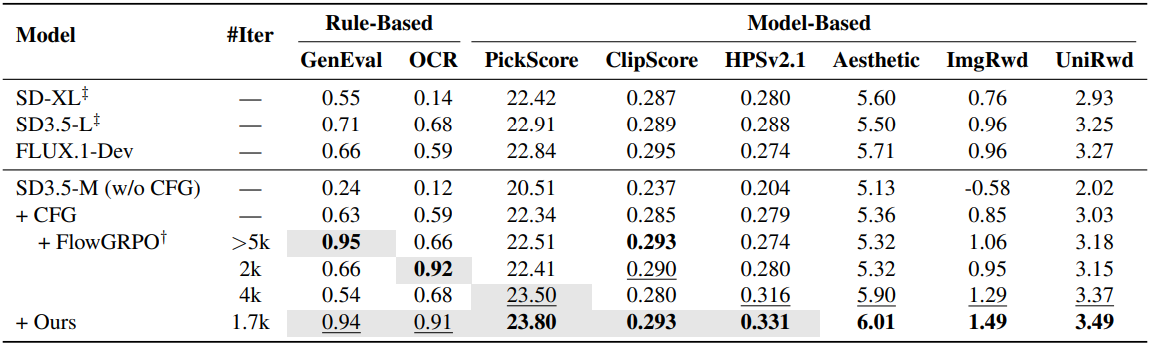
2. Head-to-Head Comparison
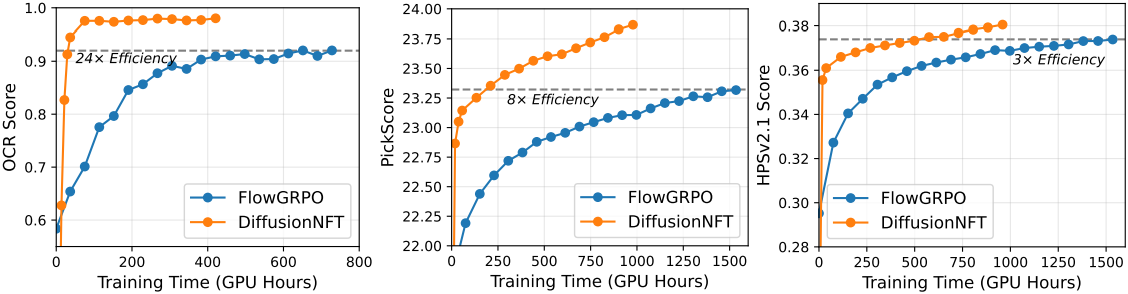
다음은 단일 reward에 대하여 FlowGRPO와 비교한 결과이다.
3. Ablation Studies
다음은 데이터 수집에 사용한 sampler에 따른 성능을 비교한 결과이다.
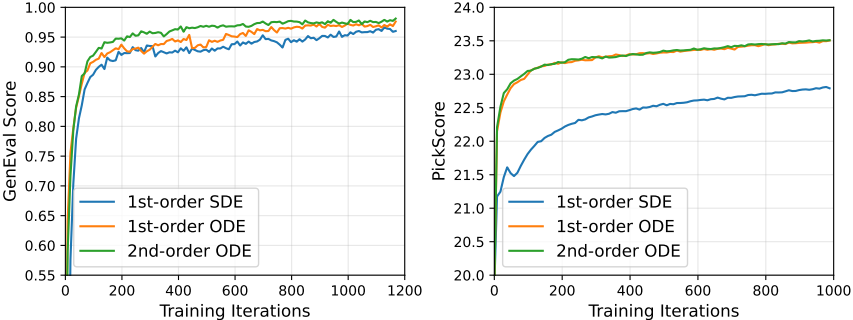
다음은 EMA 업데이트 전략에 따른 성능을 비교한 결과이다.
다음은 time-dependent weighting에 따른 성능을 비교한 결과이다.
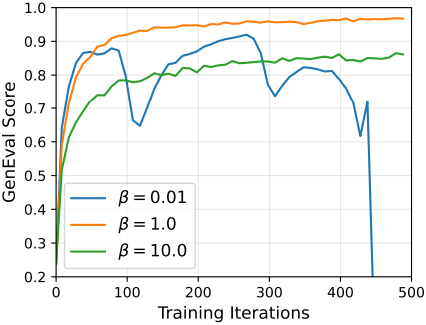
다음은 $\beta$에 따른 성능을 비교한 결과이다.