[논문리뷰] PixelDiT: Pixel Diffusion Transformers for Image Generation
CVPR 2026 (Oral). [Paper] [Page] [Github]
Yongsheng Yu, Wei Xiong, Weili Nie, Yichen Sheng, Shiqiu Liu, Jiebo Luo
NVIDIA | University of Rochester
25 Nov 2025
Introduction
Pixel-space diffusion의 핵심 과제는 픽셀 모델링이다. 픽셀 모델링이란 dense한 픽셀 단위 상호작용과 고주파 디테일을 포착하는 메커니즘을 의미하며, 이는 일반적으로 패치 토큰으로 처리되는 semantic 구조 생성과는 구별된다. 이러한 픽셀 단위 토큰을 효과적으로 모델링하는 것은 텍스처 충실도에 매우 중요하지만 계산 비용이 많이 든다. 실용적인 pixel-space diffusion의 장애물은 글로벌 semantics와 픽셀 단위 업데이트를 모두 모델링할 수 있는 효율적인 픽셀 모델링 메커니즘의 부재에 있다.
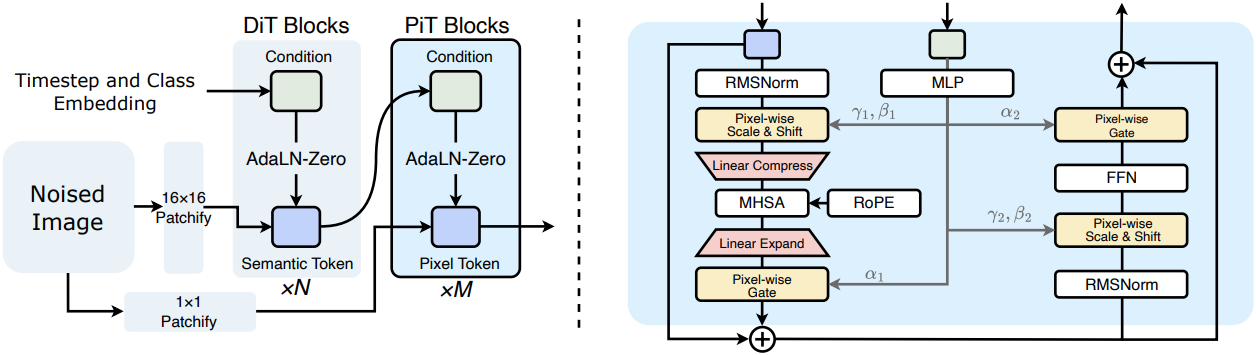
이러한 문제들을 해결하기 위해, 본 논문에서는 pixel space에서 end-to-end 학습 및 샘플링을 수행하고 픽셀 모델링을 명시적으로 구조화하는 transformer 기반 diffusion model인 PixelDiT를 제안하였다. PixelDiT는 dual-level 아키텍처 설계를 통해 이미지 semantics와 픽셀 단위 학습을 분리하였다. 첫 번째 레벨은 공격적인 패치 크기를 사용하는 patch-level DiT로, 짧은 패치 토큰 시퀀스에 long-range attention을 적용하여 글로벌 레이아웃과 콘텐츠를 포착한다. 두 번째 레벨은 pixel-level DiT로, 픽셀 단위 토큰 모델링을 통해 로컬 텍스처 디테일을 개선한다.
저자들은 본 설계의 효율성을 높이기 위해 두 가지 기술을 제안하였다.
- Pixel-wise AdaLN: 각 픽셀 토큰을 semantic 토큰으로 컨디셔닝하고, 픽셀 단위 업데이트를 글로벌 컨텍스트와 정렬한다.
- 픽셀 토큰 압축 메커니즘: Full attention 전에 각 픽셀 토큰을 압축하고 후에 다시 압축 해제한다. 이를 통해, global attention을 효율적으로 수행하면서 픽셀 단위 토큰 모델링을 가능하게 한다.
Method
1. Dual-level DiT Architecture
Semantic 학습을 patch-level 경로에 집중시키고 pixel-level 경로에서는 디테일을 정교화하기 위해 전용 Pixel Transformer (PiT) block들을 활용하는 dual-level transformer 구조를 채택한다. 이러한 구조는 대부분의 semantic 추론이 저해상도 그리드에서 이루어지도록 하여 pixel-level 경로의 부담을 줄이고 학습 속도를 높인다.
Patch-level architecture
입력 이미지를 $x \in \mathbb{R}^{B \times C \times H \times W}$라고 하자. 중첩되지 않는 $p \times p$ 크기의 패치 토큰 \(x_\textrm{patch} \in \mathbb{R}^{B \times L \times (p^2 C)}\)를 생성한다 ($L = HW/p^2$는 토큰 개수). 그런 다음, 이를 hidden size $D$로 projection한다.
\[\begin{aligned} s_0 &= W_\textrm{patch} x_\textrm{patch} \\ c &= \textrm{SiLU}(W_t t + W_y y + b) \in \mathbb{R}^{B \times 1 \times D} \end{aligned}\]LightningDiT를 따라, LayerNorm을 RMSNorm으로 대체하고 모든 attention layer에 2D RoPE를 적용하여 DiT block을 확장한다. Patch-level 경로는 $N$개의 확장된 DiT block으로 구성된다. Block $i$에 대해 다음과 같다.
\[\begin{aligned} \tilde{s}_i &= \textrm{RMSNorm}(s_i) \\ \bar{s}_i &= s_i + \alpha_1 (c) \odot \textrm{Attn} (\gamma_1 (c) \odot \tilde{s}_i + \beta_1 (c); \textrm{RoPE}) \\ s_{i+1} &= \bar{s}_i + \alpha_2 (c) \odot \textrm{MLP} (\gamma_2 (c) \odot \textrm{RMSNorm} (\bar{s}_i) + \beta_2 (c)) \end{aligned}\]AdaLN 파라미터는 글로벌 컨디셔닝 $c$에서 생성된 후 $L$개의 패치 토큰에 걸쳐 broadcasting된다. 이러한 broadcasting은 모든 패치 토큰에 동일한 feature별 AdaLN 파라미터를 적용한다. 이는 이후 pixel-level 경로에서 사용되는 pixel-wise AdaLN과는 대조적이다.
$N$개의 block을 거친 후, semantic 토큰 $s_N \in \mathbb{R}^{B \times L \times D}$를 얻는다. Pixel-level 경로를 위한 컨디셔닝 신호를 \(s_\textrm{cond} = s_N + t\)로 정의하며, 여기서 $t$는 timestep 임베딩이다. 이 토큰들은 pixel-wise AdaLN을 통해 PiT block에 semantic 컨텍스트를을 제공한다.
Pixel-level architecture
Pixel-level DiT는 $M$개의 PiT blcok layer로 구성된다. 픽셀 토큰과 patch-level DiT의 출력 \(s_\textrm{cond}\)를 입력으로 받아 픽셀 토큰 모델링을 수행하고 최종 결과를 생성한다.
2. Pixel Transformer Block
각 PiT block은 두 가지 핵심 구성 요소로 이루어져 있다.
- Pixel-wise AdaLN: 개별 픽셀 수준에서 dense한 컨디셔닝을 가능하게 하여 픽셀별 업데이트를 글로벌 컨텍스트와 일치시킨다.
- 픽셀 토큰 압축 메커니즘: 픽셀 토큰 간의 중복성을 줄여 global attention이 관리 가능한 시퀀스 길이에서 작동하도록 한다.
Pixel-wise AdaLN Modulation
Pixel-level 경로에서는 linear layer를 사용하여 각 이미지를 픽셀당 하나의 토큰으로 임베딩한다.
\[\begin{equation} X \in \mathbb{R}^{B \times C \times H \times W} \xrightarrow{\text{reshape + linear}} \mathbb{R}^{B \times H \times W \times D_\textrm{pix}} \end{equation}\]Patch-level의 semantic 토큰과 일치시키기 위해, 이를 $p^2$개의 픽셀 토큰의 $B \cdot L$개의 시퀀스, 즉 $X \in \mathbb{R}^{(B \cdot L) \times p^2 \times D_\textrm{pix}}$로 reshape한다. 각 패치에 대해, 글로벌 컨텍스트를 요약하는 semantic 토큰 \(s_\textrm{cond} \in \mathbb{R}^{(B \cdot L) \times D}\)를 생성한다.
단순한 패치 단위 변조는 패치 내의 모든 $p^2$개의 픽셀에 대해 동일한 파라미터를 반복한다. 그러나 이것으로는 dense한 픽셀별 변화를 포착할 수 없다. 대신, 저자들은 linear projection \(\Phi : \mathbb{R}^D \rightarrow \mathbb{R}^{p^2 \cdot 6 D_\textrm{pix}}\)를 통해 \(s_\textrm{cond}\)를 $p^2$개의 AdaLN 파라미터 세트로 확장하여 각 픽셀에 독립적인 변조를 할당한다.
\[\begin{equation} \Theta = \Phi (s_\textrm{cond}) \in \mathbb{R}^{(B \cdot L) \times p^2 \times 6 D_\textrm{pix}} \end{equation}\]$\Theta$의 마지막 차원을 크기가 \(D_\textrm{pix}\)인 6개의 그룹으로 분할하여 \((\beta_1, \gamma_1, \alpha_1, \beta_2, \gamma_2, \alpha_2) \in (\mathbb{R}^{(B \cdot L) \times p^2 \times D_\textrm{pix}})^6\)를 얻는다. 이러한 변조 파라미터는 학습을 통해 결정되며 각 픽셀마다 서로 다른 값을 가진다. 이 파라미터들은 pixel-wise AdaLN을 통해 $X$에 적용되어 픽셀별 업데이트를 가능하게 한다.
Pixel Token Compaction
Pixel-level 경로에서 모든 $H \times W$개의 픽셀 토큰에 대해 직접적인 attention을 수행하는 것은 연산 비용 측면에서 감당하기 어렵다. 따라서 global attention을 수행하기에 앞서 각 패치 내의 $p^2$개 픽셀 토큰을 하나의 압축된 패치 토큰으로 변환하고, 이후 attention이 적용된 표현을 다시 픽셀 단위로 확장한다. 이를 통해 attention 시퀀스 길이는 $H \times W$에서 $L$로 줄어들어 $p^2$배만큼 감소하게 된다. 예를 들어 $p=16$인 경우, 픽셀별 업데이트를 유지하면서도 시퀀스 길이를 1/256로 축소할 수 있다.
저자들은 학습 가능한 linear map \(\mathcal{C} : \mathbb{R}^{p^2 \times D_\textrm{pix}} \rightarrow \mathbb{R}^D\)와 \(\mathcal{E} : \mathbb{R}^D \rightarrow \mathbb{R}^{p^2 \times D_\textrm{pix}}\)를 사용하여 압축 연산자를 구현하였다. VAE와 달리, 이 메커니즘은 attention 연산을 위해 일시적으로만 표현을 압축한다. 이 압축은 순전히 self-attention의 계산 오버헤드를 줄이기 위한 것이며, 미세한 디테일을 손상시키지 않는다. 고주파 정보는 residual connection과 학습된 $\mathcal{E}$를 통해 보존된다.
3. PixelDiT for Text-to-Image Generation
Pixel-level 경로는 그대로 유지하면서 텍스트와 이미지의 semantic 정보를 융합하는 multi-modal DiT (MM-DiT) block을 통해 patch-level 경로를 확장한다. 각 MM-DiT block에서 이미지 토큰과 텍스트 토큰은 각각 별도의 QKV projection을 거쳐 두 개의 스트림을 형성한다.
텍스트 임베딩 \(y \in \mathbb{R}^{B \times L_\textrm{txt} \times D_\textrm{txt}}\)는 고정된 Gemma-2 인코더를 통해 생성된다. 이때 사용자 프롬프트 앞에 간결한 시스템 프롬프트를 추가한 뒤 해당 시퀀스를 텍스트 인코더에 입력한다. 생성된 토큰 임베딩은 모델의 width에 맞춰 projection된 후 MM-DiT의 텍스트 스트림으로 사용된다.
저자들이 실험적으로 확인한 결과, patch-level 경로에서 생성된 semantic 토큰만으로도 픽셀 업데이트 과정에 텍스트적 의도를 전달하기에 충분했다. 따라서 pixel-level 경로의 구조는 클래스 조건부 모델과 동일하다. 즉, 이 경로는 픽셀 토큰을 처리하며, semantic 토큰과 timestep을 통해서만 컨디셔닝된다. 텍스트 토큰이 픽셀 스트림으로 직접 전달되는 일은 없다.
4. Training Objectives
저자들은 pixel space에서 Rectified Flow 공식을 채택하고, velocity-matching loss를 사용하여 모델을 학습시켰다.
\[\begin{equation} \mathcal{L}_\textrm{diff} = \mathbb{E}_{t,x,\epsilon} \left[ \| f_\theta (x_t, t, y) - v_t \|_2^2 \right] \end{equation}\]REPA를 따라, patch-level 경로의 중간 토큰이 고정된 DINOv2 인코더의 feature와 일치하도록 유도하는 alignment loss를 포함한다. 전체 loss는 다음과 같다.
\[\begin{equation} \mathcal{L} = \mathcal{L}_\textrm{diff} + \lambda_\textrm{repa} \mathcal{L}_\textrm{repa} \end{equation}\]Experiments
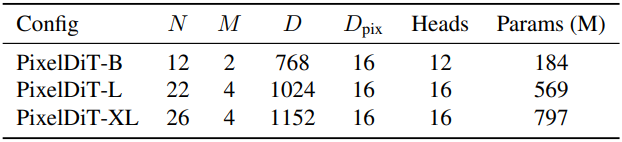
1. Class-conditioned Image Generation on ImageNet
다음은 ImageNet 256$\times$256에서의 비교 결과이다.
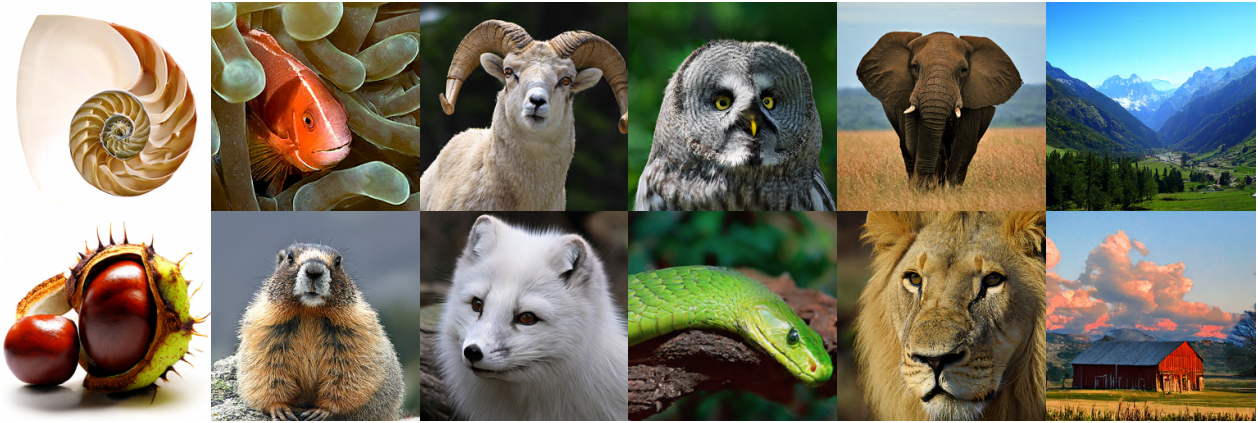
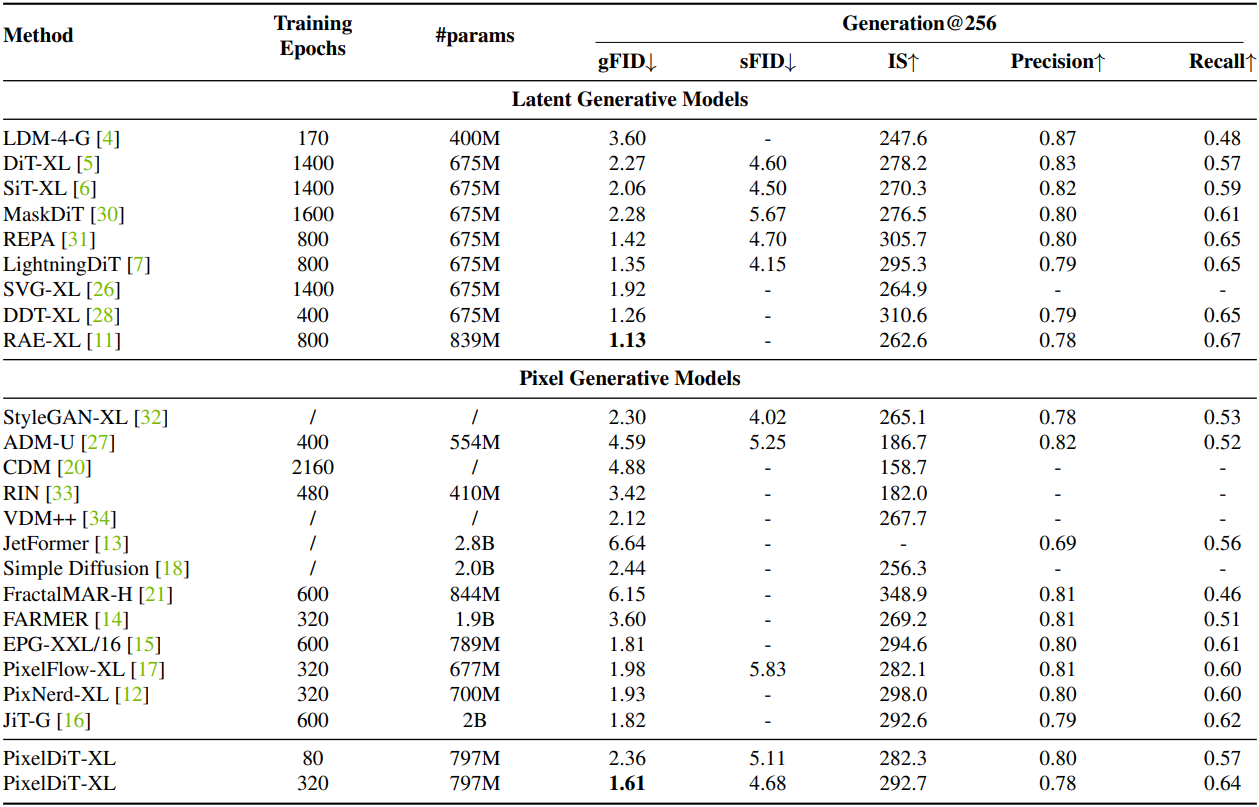
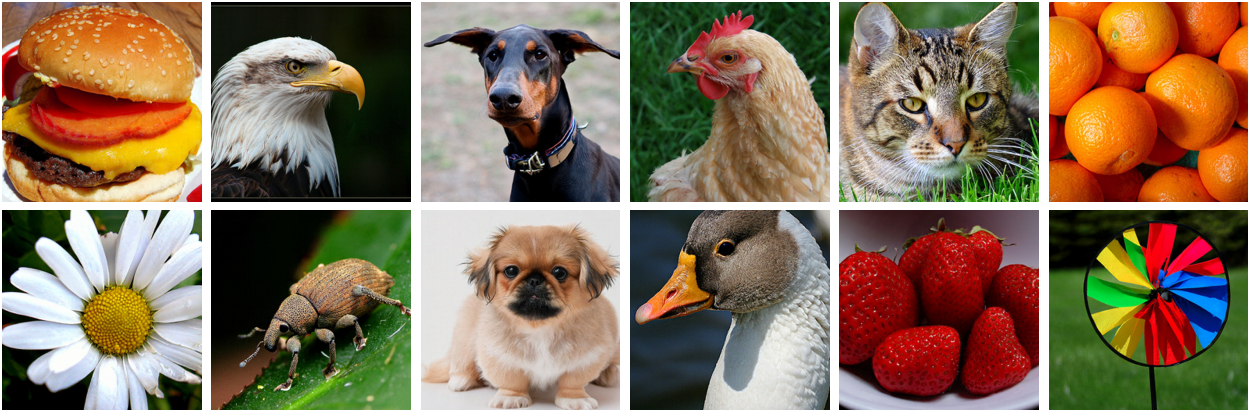
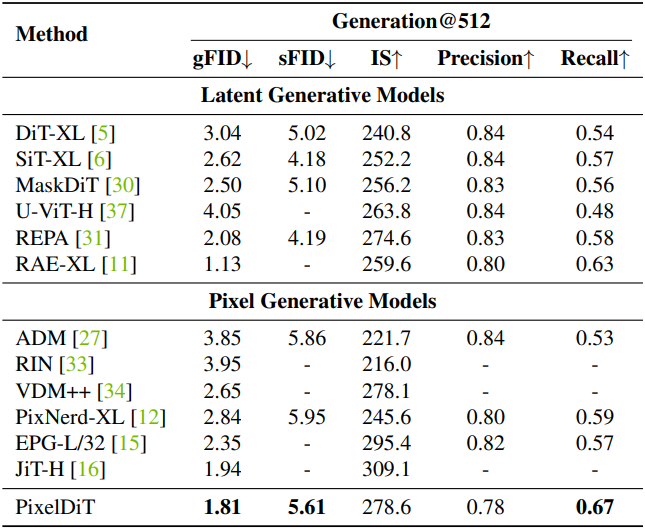
다음은 ImageNet 512$\times$512에서의 비교 결과이다.
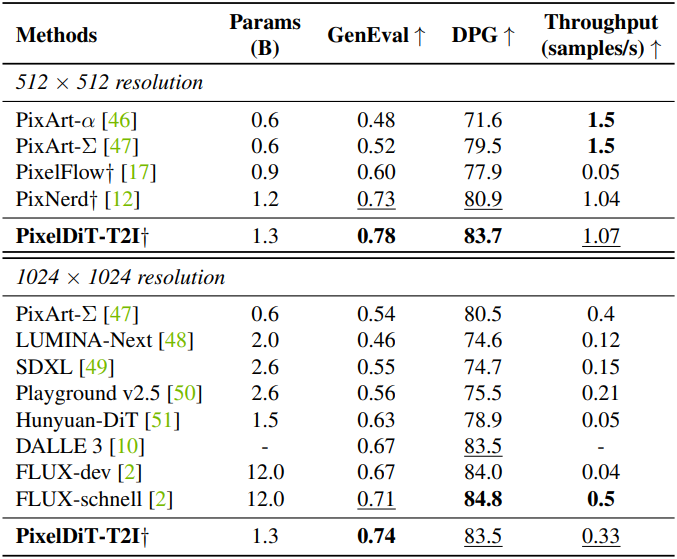
2. Text-to-Image Generation
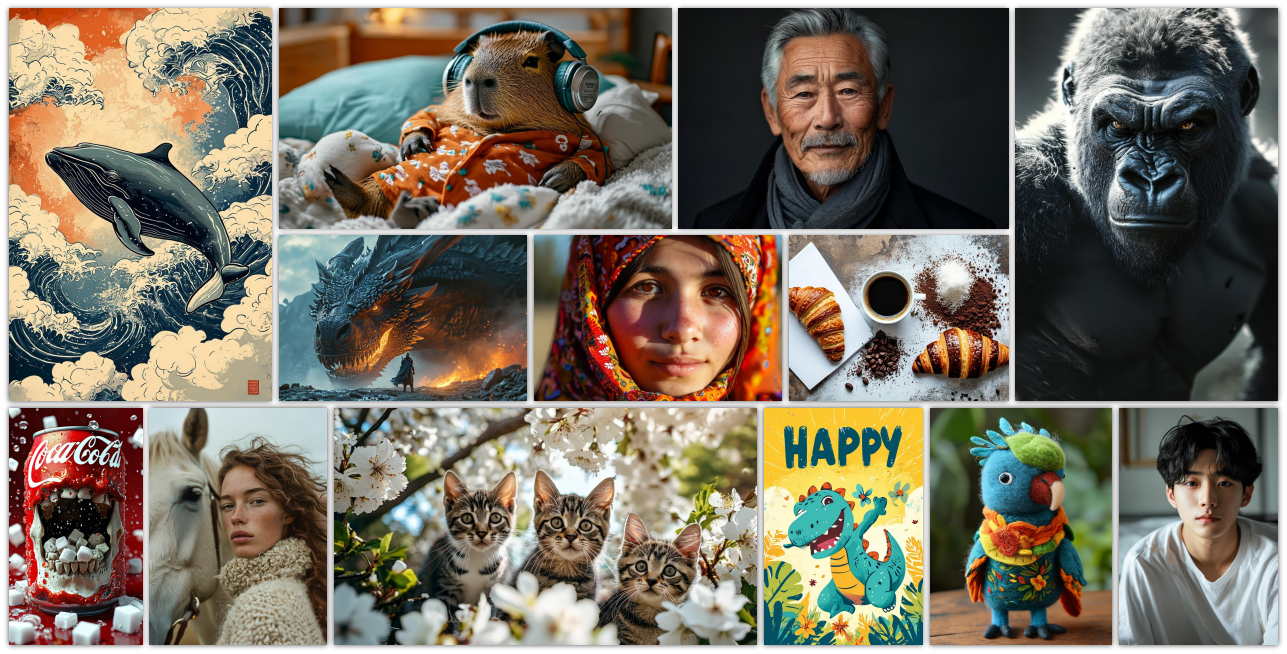
다음은 text-to-image 비교 결과이다.
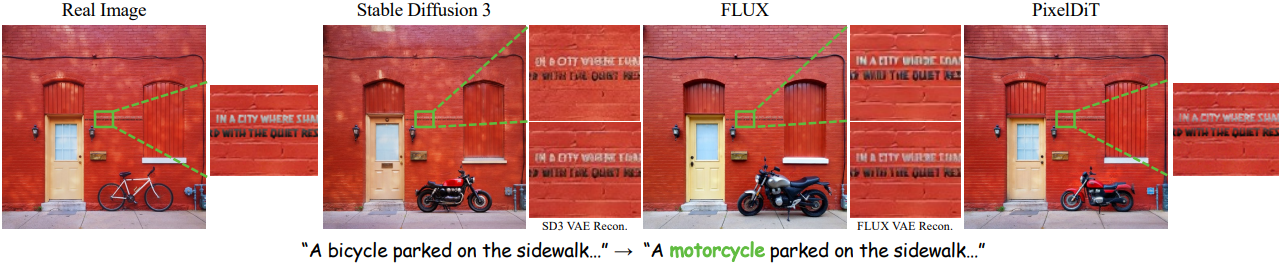
3. Detail Preservation in Image Editing
다음은 FlowEdit을 사용하여 이미지를 편집한 결과이다.
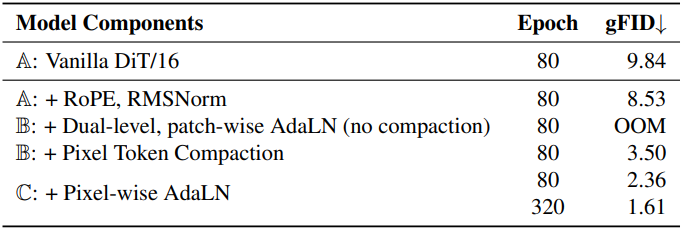
4. Ablation Study
다음은 PixelDiT-XL에 대한 여러 ablation study 결과이다. (ImageNet 256$\times$256)
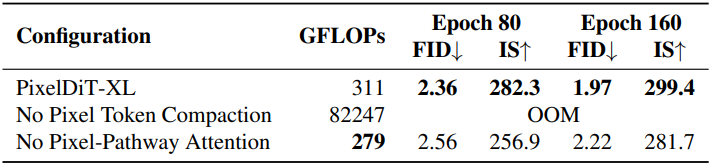
다음은 픽셀 토큰 압축 메커니즘에 대한 ablation 결과이다.
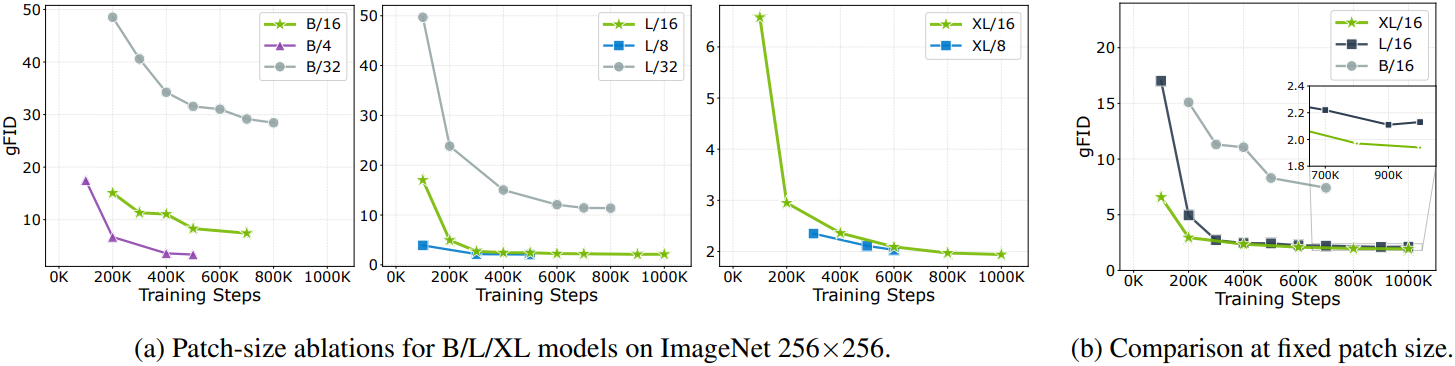
다음은 모델 크기와 패치 크기에 따른 수렴성을 분석한 그래프이다.