[논문리뷰] Elastic Diffusion Transformer
ICML 2026. [Paper] [Github]
Jiangshan Wang, Zeqiang Lai, Jiarui Chen, Jiayi Guo, Hang Guo, Xiu Li, Xiangyu Yue, Chunchao Guo
Tsinghua University | Tencent Hunyuan | MMLab | CUHK | HITSZ
15 Feb 2026
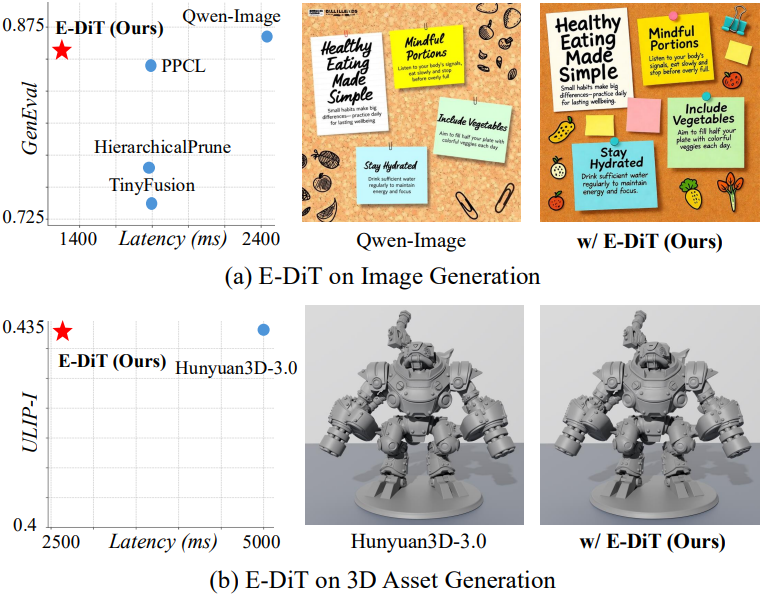
Introduction
본 논문에서는 생성된 콘텐츠에 따라 연산량을 적응적으로 배분할 수 있는 다양한 DiT backbone에 적용 가능한 일반적인 가속 프레임워크를 개발하는 것을 목표로 하였다. 저자들은 생성 과정에서 상당한 sparsity가 나타나는 것을 관찰했다. 즉, denoising process 중 특정 연산은 최종 생성 품질에 미미한 영향만을 미친다. 중요한 것은 이러한 sparsity가 샘플 전체에 걸쳐 균일하게 나타나는 것이 아니라 콘텐츠에 따라 달라진다는 점이며, 이는 세 가지 주요 측면에서 확인할 수 있다.
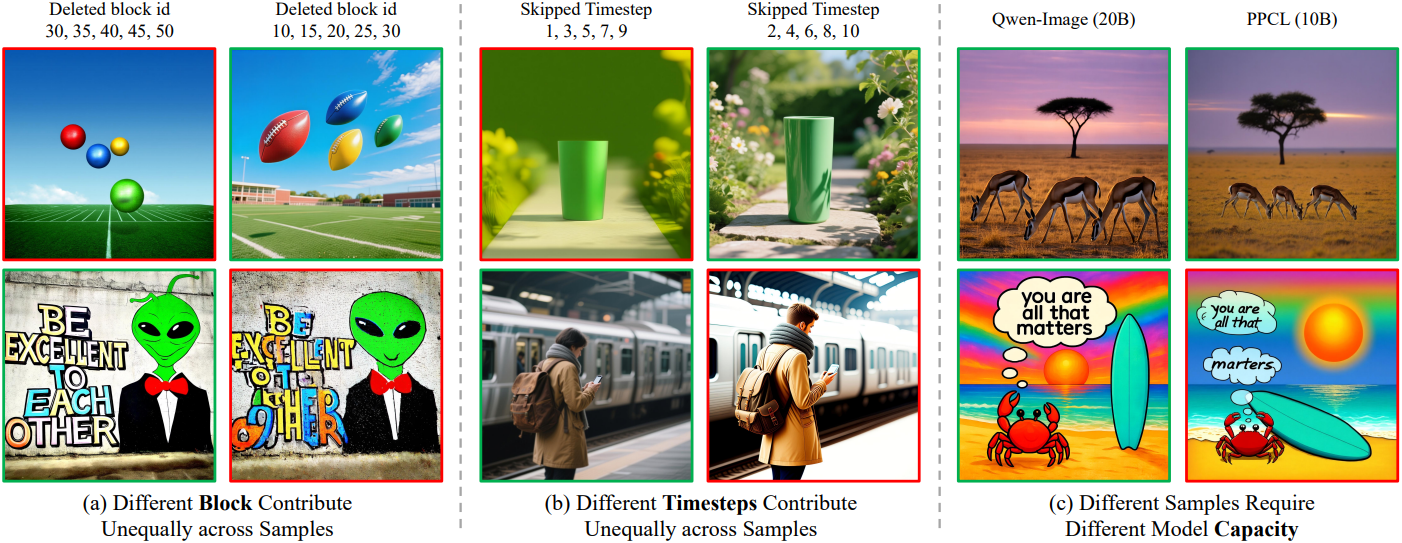
- 서로 다른 DiT block들이 샘플에 대해 불균등하게 기여한다.
- Denoising timestep 또한 샘플에 따라 중요도가 다르다.
- 연산 요구량은 생성된 샘플의 복잡성과 상관관계가 있다.
Diffusion 생성 과정에서 샘플에 따른 sparsity를 활용하기 위해, 본 논문에서는 DiT를 위한 일반적이고 적응적인 가속 프레임워크인 Elastic Diffusion Transformer (E-DiT)를 제안하였다. E-DiT는 세 가지 상호 보완적인 구성 요소를 통해 샘플 적응 방식으로 생성을 가속화한다.
- Adaptive block skipping: 생성에 대한 기여도가 미미할 것으로 예측되는 DiT block 전체를 동적으로 스킵한다.
- Adaptive MLP width reduction: 스킵되지 않은 block 내에서 활성화된 MLP width를 샘플 복잡도에 따라 조정한다.
- Block-wise caching: 학습 없이 인접한 denoising step에서 중간 feature를 재사용하여 중복 계산을 제거한다.
구체적으로, E-DiT의 각 DiT block에는 입력 latent와 denoising timestep에 따라 작동하는 경량 라우터가 탑재되어 있다. 이 라우터는 block을 스킵할 수 있는지 여부를 예측하고, 활성화된 block에 대해서는 block 내에서 효과적인 MLP width를 결정한다. 학습 과정에서 생성 품질을 유지하기 위한 성능 loss와 효율적인 라우팅 결정을 유도하기 위한 효율성 loss를 동시에 최적화한다.
학습된 라우터 예측은 서로 다른 block의 상대적 중요도를 자연스럽게 포착한다. 저자들은 이러한 특성을 활용하여, 라우터 예측을 denoising step 전반에 걸쳐 feature 재사용 기준으로 사용하는 block-wise caching 메커니즘을 도입함으로써 추가 학습 없이 inference 속도를 향상시켰다.
Method
1. Model Designs
Router Architecture
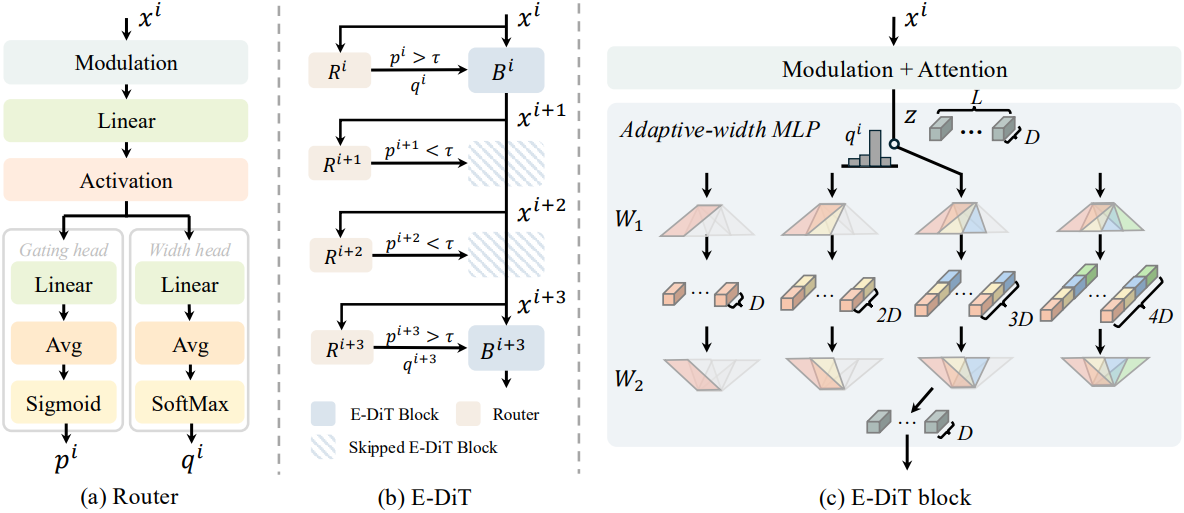
$n$개의 block \(\{\textbf{B}^i\}_{i=1}^n\)으로 구성된 DiT가 주어졌을 때, 각 block \(\textbf{B}^i\)에는 적응형 연산을 가능하게 하는 경량 라우터 \(\textbf{R}^i\)가 장착된다. 주어진 입력에 대해 \(\textbf{R}^i\)는 먼저 해당 block을 활성화해야 하는지 예측하고, 활성화해야 하는 경우 해당 block 내에서 적절한 MLP width를 예측한다.
\(\textbf{x}_t^i \in \mathbb{R}^{L \times D}\)를 diffusion step $t$에서 block \(\textbf{B}^i\)에 대한 latent라 하자. 라우터 내부에서 먼저 Layer Normalization (LN)를 사용하여 timestep 기반 변조를 적용한 다음, element-wise scaling 및 shifting을 수행한다.
\[\begin{equation} \tilde{\textbf{x}}_t^i = (1 + \gamma (t)) \odot \textrm{LN} (\textbf{x}_t^i) + \delta (t) \end{equation}\]$\gamma (t), \delta (t) \in \mathbb{R}^D$는 timestep 임베딩 $\textbf{E}(t) \in \mathbb{R}^D$의 linear projection을 통해 얻은 scale 및 shift 파라미터이다. 변조된 feature \(\tilde{\textbf{x}}_t^i\)는 projection된 후 non-linear activation을 통과한다.
\[\begin{equation} \textbf{h} = \sigma (\tilde{\textbf{x}}_t^i \textbf{W}) \in \mathbb{R}^{L \times H_r} \\ \textrm{where} \quad \textbf{W} \in \mathbb{R}^{D \times H_r}, \; H_r \ll D \end{equation}\]$\textbf{h}$를 기반으로 라우터는 별도의 linear head와 global averaging을 통해 두 개의 출력을 생성한다.
- Adaptive block skipping을 위한 gating logit \(\ell_t^i\)
- Adaptive MLP width reduction을 위한 width logit 벡터 \(\textbf{u}_t^i \in \mathbb{R}^4\)
Adaptive Block Skipping
라우터가 예측한 logit \(\ell_t^i \in \mathbb{R}\)을 sigmoid function을 통해 확률로 변환한다.
\[\begin{equation} p_t^i = \sigma (\ell_t^i) \in [0, 1] \end{equation}\]만약 $p_t^i$가 미리 정의된 threshold $\tau = 0.5$보다 낮으면 해당 block \(\textbf{B}^i\)는 스킵되며, 이를 통해 모델은 중복 계산을 제거할 수 있다.
학습 과정에서 discrete한 block-skipping 연산은 미분 불가능하다. 이를 해결하기 위해, Straight Through Estimator (STE)를 사용한다.
\[\begin{equation} g_t^i = \unicode{x1D7D9}[p_t^i \ge \tau] + p_t^i - \textrm{StopGrad}(p_t^i) \end{equation}\]($\unicode{x1D7D9}[\cdot]$는 indicator function)
그러면 $i$번째 block의 출력은 다음과 같이 계산된다.
\[\begin{equation} \textbf{x}_t^{i+1} = \textbf{x}_t^i + g_t^i \cdot (\textbf{B}^i (\textbf{x}_t^i) - \textbf{x}_t^i) \end{equation}\]계산 효율성을 높이기 위해, 다음과 같은 gating loss를 통해 평균 gating 확률 \(\bar{p} = \frac{1}{n} \sum_{i=1}^n p_t^i\)가 목표 \(\rho_g \in (0, 1)\)과 일치하도록 제한함으로써 라우팅을 정규화한다.
\[\begin{equation} \mathcal{L}_\textrm{gating} = (\bar{p} - \rho_g)^2 \end{equation}\]Inference 시에는 가속을 위해 $p_t^i < \tau$인 block을 직접 스킵한다.
\[\begin{equation} \textbf{x}_t^{i+1} = \begin{cases} \textbf{x}_t^i, & p_t^i < \tau \\ \textbf{B}^i (\textbf{x}_t^i), & p_t^i \ge \tau \end{cases} \end{equation}\]Adaptive MLP Width Reduction
스킵되지 않는 block의 경우, 미리 정의된 축소 비율 집합 \(\mathcal{S} = \{ \frac{1}{4}, \frac{1}{2}, \frac{3}{4}, 1\}\)에 따라 원래 $H/D = 4$인 MLP width를 동적으로 조정하여 계산량을 더욱 줄인다. 구체적으로, 라우터 예측 \(\textbf{u}_t^i \in \mathbb{R}^4\)가 주어지면, 먼저 softmax를 통해 width 확률을 계산한다.
\[\begin{equation} \textbf{q}_t^i = \textrm{softmax} (\textbf{u}_t^i) \in \mathbb{R}^4 \end{equation}\]그런 다음 확률이 가장 높은 width가 선택된다.
\[\begin{equation} k = \underset{j}{\arg \min} \; \textbf{q}_t^i [j], \quad \hat{s}_t^i = \mathcal{S}[k] \end{equation}\]학습 과정에서 미분 가능성을 유지하기 위해 중간 activation 값을 마스킹하는 방식으로 적응형 MLP를 구현한다.
\[\begin{equation} \textrm{MLP}_\textrm{adapt} (\textbf{z}) = \left( \sigma (\textbf{z} \textbf{W}_1) \odot \textbf{m} (\hat{s}_t^i) \right) \textbf{W}_2 \end{equation}\](\(\textbf{m} (\hat{s}_t^i) \in \{0, 1\}^H\)는 hidden dimension을 따라 feature의 처음 \(\hat{s}_t^i \cdot H\) 부분만 유지하는 마스크)
보다 효율적인 width 선택을 유도하기 위해, 스킵되지 않은 모든 block에 걸쳐 평균 MLP width를 정규화한다. Timestep $t$에서 block \(\textbf{B}^i\)에 대한 평균 width 감소는 다음과 같이 정의된다.
\[\begin{equation} r_t^i = \sum_{j=1}^4 \textbf{q}_t^i [j] s [j] \end{equation}\]Width 할당은 block이 스킵되지 않았을 때만 의미가 있으므로 스킵된 block을 마스킹하고, 마스킹된 평균 width 감소는 다음과 같이 계산된다.
\[\begin{equation} \bar{r} = \frac{\sum_{i=1}^n \unicode{x1D7D9}[p_t^i \ge \tau] r_t^i}{\sum_{i=1}^n \unicode{x1D7D9}[p_t^i \ge \tau]} \end{equation}\]\(\mathcal{L}_\textrm{width}\)를 통해 $\bar{r}$가 목표 width \(\rho_w \in (0, 1)\)에 맞도록 한다.
\[\begin{equation} \mathcal{L}_\textrm{width} = (\bar{r} - \rho_w)^2 \end{equation}\]Inference 시에는 비활성화된 채널에 대한 계산을 피하기 위해 명시적인 행렬 분할을 통해 적응형 MLP width가 구현된다.
\[\begin{equation} \textrm{MLP}_{\hat{s}_t^i} (\textbf{z}) = \sigma (\textbf{z} \tilde{\textbf{W}}_1) \tilde{\textbf{W}}_2 \\ \textrm{where} \quad \tilde{\textbf{W}}_1 = \textbf{W}_1 [:, : H \cdot \hat{s}_t^i], \; \tilde{\textbf{W}}_2 = \textbf{W}_2 [: H \cdot \hat{s}_t^i, :] \end{equation}\]비활성화된 채널에 대한 계산을 스킵되어 실제 가속이 이루어진다.
2. Training and Inference
학습 파이프라인
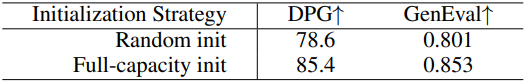
사전 학습된 DiT를 기반으로 E-DiT를 end-to-end 방식으로 학습시킨다. 학습 시작 시 모든 라우터는 완전히 열린 상태로 설정된다. 즉, 각 block은 전체 MLP width로 활성화되어 학습이 원래의 dense model 동작에서 시작되고 불안정한 초기 최적화 단계를 방지한다.
학습 과정에서 latent 입력의 mini-batch와 랜덤 샘플링된 timestep이 주어지면, 각 라우터는 각 block \(\textbf{B}^i\)에 대한 block gate 확률 $p_t^i$와 width 분포 \(\textbf{q}_t^i\)를 예측한다. 전체 학습 loss는 품질과 효율성을 결합한 것이다.
\[\begin{aligned} \mathcal{L} &= \mathcal{L}_\textrm{perf} + \lambda \mathcal{L}_\textrm{eff} \\ \mathcal{L}_\textrm{eff} &= \mathcal{L}_\textrm{gating} + \mathcal{L}_\textrm{width} \end{aligned}\]($\lambda = 1$)
성능 loss \(\mathcal{L}_\textrm{perf}\)는 기본 diffusion backbone에서 사용되는 flow-matching loss이다. 이를 통해 E-DiT가 원래 dense model의 생성 품질을 유지하면서 동적이고 콘텐츠에 의존하는 계산을 학습할 수 있도록 한다.
Inference 파이프라인 & Block-wise Caching
Inference 시에 E-DiT는 block 실행과 MLP width을 동적으로 조정한다. 각 block \(\textbf{B}^i\)에 대해 라우터는 각 denoising step $t$에서 $p_t^i$와 \(\textbf{q}_t^i\)를 예측한다. $p_t^i < \tau$인 경우 block은 스킵되지고, 그렇지 않으면 선택된 MLP width로 활성화된다.
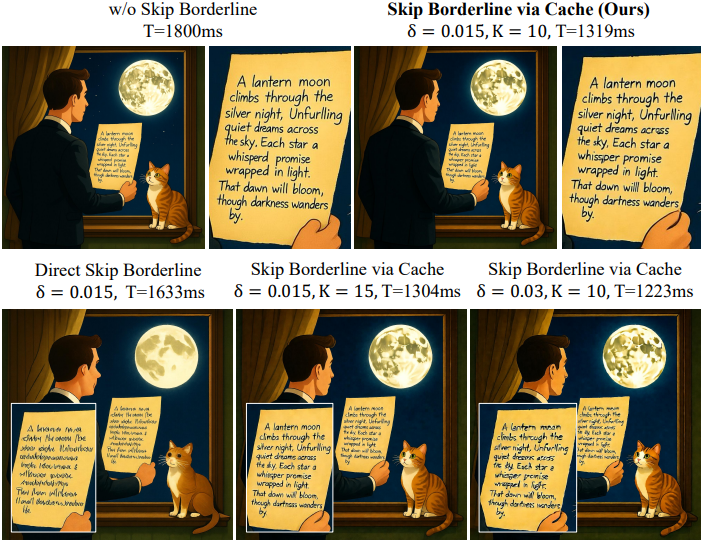
적응형 block-skipping과 MLP width 축소는 이미 최소한의 품질 손실로 대부분의 중복 계산을 제거하지만, 일부 활성 block은 gating 확률이 $\tau$에 근접하여 추가적인 가속 가능성이 있다. 이를 활용하기 위해, block이 직접 스킵되지는 않지만 미미하게 기여할 가능성이 있는 경계 영역 $p_t^i \in [\tau, \tau + \delta]$를 정의한다. 이러한 block에 대해서는 block-wise caching 메커니즘을 통해 denoising step 전반에 걸쳐 시간적 중복성을 활용하고, 중간 feature를 재사용하여 계산량을 더욱 줄인다.
구체적으로, timestep $t$에서 \(\textbf{B}^i\)가 활성화될 때, 그 residual 업데이트를 다음과 같이 계산한다.
\[\begin{equation} \Delta^i = \textbf{B}^i (\textbf{x}_t^i, \textbf{q}_t^i) - \textbf{x}_t^i \end{equation}\]그리고 이를 feature bank \(\mathcal{C}^i\)에 저장한다. 이후 시점 $\tilde{t}$에서, 이 block의 gating 확률 \(p_{\tilde{t}}^i\)가 경계 영역에 속하고 \(\mathcal{C}^i\)에 캐싱된 residual이 있는 경우, 전체 block 계산을 스킵하고 latent를 업데이트한다.
\[\begin{equation} \textbf{x}_{\tilde{t}}^{i+1} = \textbf{x}_{\tilde{t}}^i + \Delta^i \end{equation}\]그렇지 않으면 전체 forward pass가 수행되고, 새로 계산된 residual로 feature bank가 갱신된다. 오차 누적을 방지하기 위해 캐싱된 각 residual은 재계산 전에 최대 $K$번까지 재사용된다.
Feature 재사용 시점을 결정하기 위해 복잡한 기준을 설계해야 하는 기존 캐싱 방법과 달리, E-DiT는 라우터 예측 $p_t^i$를 원칙적인 캐시 지표로 자연스럽게 활용하여 중복 계산을 더욱 줄이는 간단하면서도 효과적인 메커니즘을 제공한다.
Experiments
- Base model
- Qwen-Image
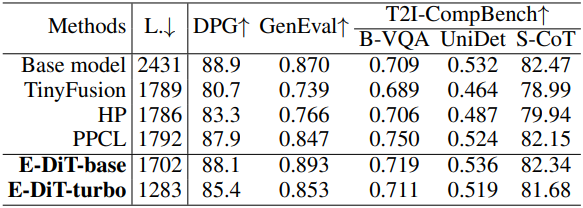
- E-DiT-base: \(\rho_g = 0.6\), \(\rho_w = 0.65\), $\delta = 0.1$, $K = 5$
- E-DiT-turbo: \(\rho_g = 0.5\), \(\rho_w = 0.6\), $\delta = 0.15$, $K = 10$
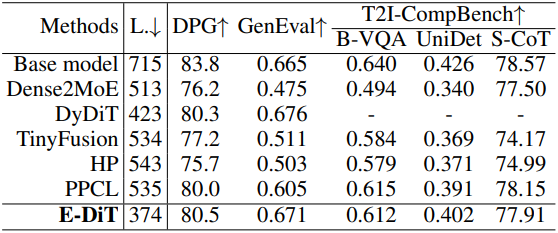
- FLUX.1-dev: \(\rho_g = 0.5\), \(\rho_w = 0.6\), $\delta = 0.1$, $K = 3$
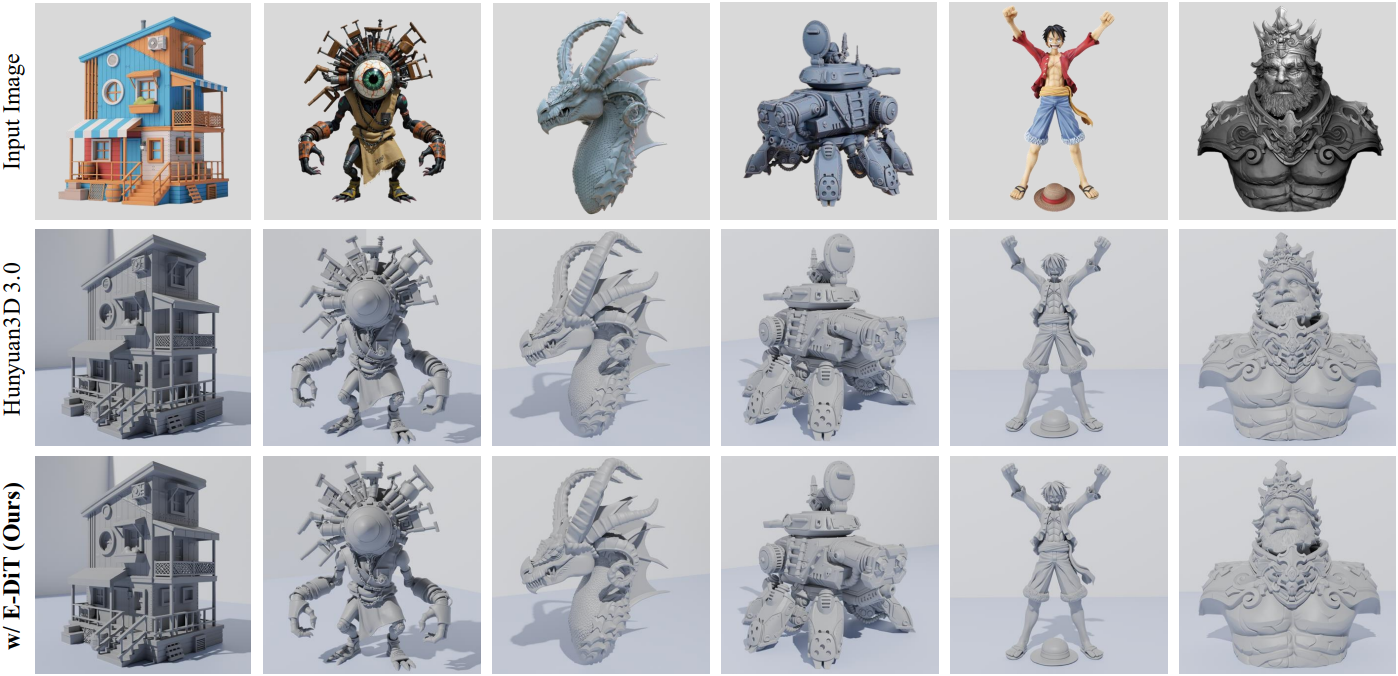
- Hunyuan3D-3.0: \(\rho_g = 0.45\), \(\rho_w = 0.5\), $\delta = 0.15$, $K = 5$
- Qwen-Image
1. Text-to-Image Generation
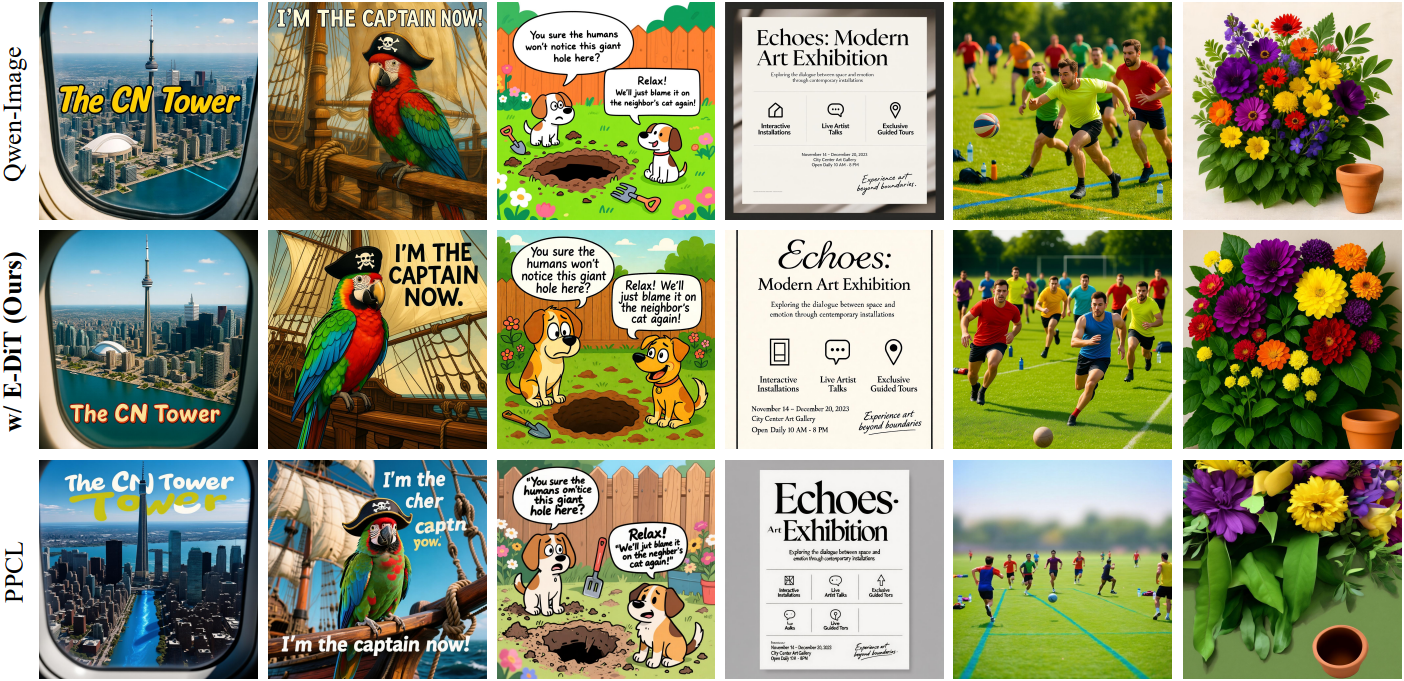
다음은 Qwen-Image에 대한 성능 비교 결과이다. (L.은 inference latency (ms))
다음은 FLUX.1-dev에 대한 성능 비교 결과이다.
2. Image-to-3D Generation
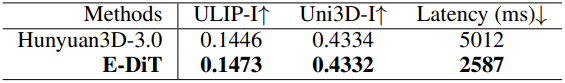
다음은 Hunyuan3D 3.0에 대한 성능 비교 결과이다.
3. Discussions
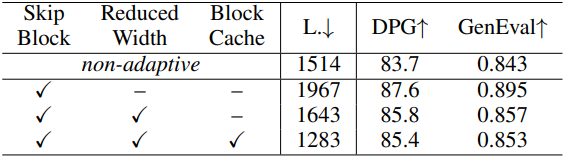
다음은 가속 구성 요소에 대한 ablation study 결과이다.
다음은 초기화 전략에 대한 ablation study 결과이다.
다음은 block-wise caching에 대한 ablation study 결과이다.
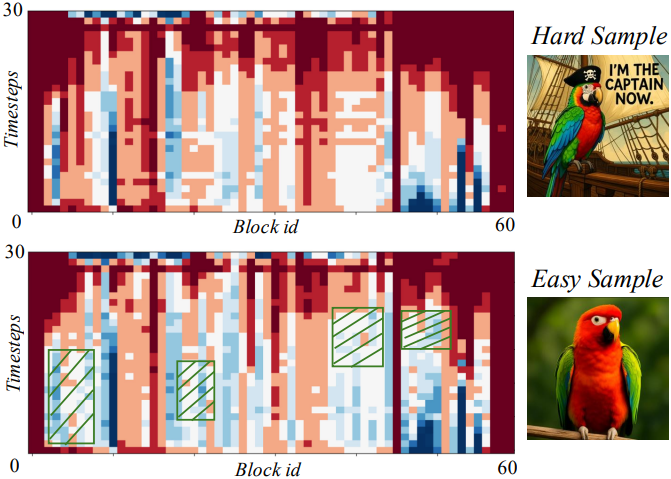
다음은 라우터 예측을 시각화한 것이다.