[논문리뷰] NFT: Bridging Supervised Learning and Reinforcement Learning in Math Reasoning
ICLR 2026. [Paper] [Page] [Github]
Huayu Chen, Kaiwen Zheng, Qinsheng Zhang, Ganqu Cui, Lifan Yuan, Yin Cui, Haotian Ye, Tsung-Yi Lin, Ming-Yu Liu, Jun Zhu, Haoxiang Wang
Tsinghua | NVIDIA | UIUC | Stanford
23 May 2025
Introduction
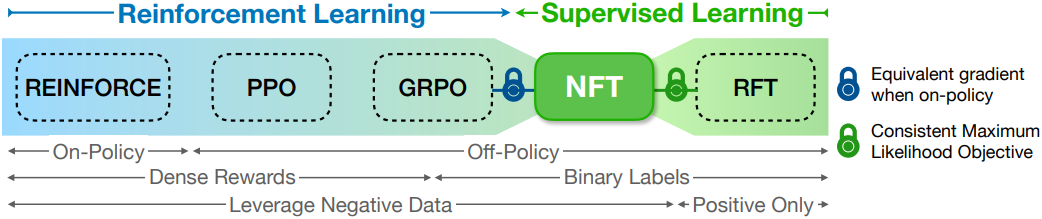
강화 학습(RL)은 검증 기반의 LLM 학습에 매우 적합한 방식으로 보인다. PPO나 GRPO와 같은 RL 알고리즘은 reward 신호를 극대화하도록 설계되었는데, 이때 reward 신호는 verifier의 binary 결과를 취하기에 용이하다. 반면, supervised learning (SL)은 이러한 검증 기반 학습을 구현하는 데 있어 거의 고려되지 않는다. Supervised learning은 본질적으로 좋은 데이터를 암기하도록 설계되어 있어, 실수로부터 스스로 성찰하며 배우는 과정에는 적합하지 않다는 것이 일반적인 견해이다.
본 논문에서는 검증 기반 학습이 RL에만 국한된다는 통념에 의문을 제기하며, supervised learning 패레다임 내에서도 이와 유사한 방식의 학습이 가능함을 입증하였다.
저자들은 간단한 SL baseline인 Rejection Fine-Tuning (RFT)에서 시작하였다. 매 iteration마다 LLM은 질문에 대한 답변을 생성한다. 이때 verifier가 나쁜 답변을 모두 걸러내는 역할을 한다. 남은 좋은 답변들은 데이터셋으로 구성되어, LLM을 supervised fine-tuning하는 데 사용된다. 하지만 이 방식은 나쁜 답변을 통한 학습을 배제한다는 한계가 있다. 즉, LLM이 자신의 실수를 되돌아보고 개선하기보다는 이미 잘 수행하는 능력을 강화하는 방향으로 유도된다.
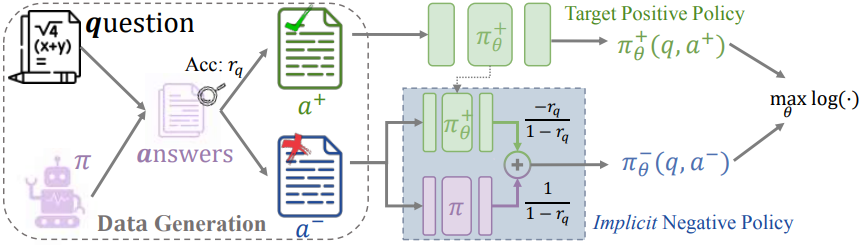
이러한 한계를 극복하기 위해, 저자들은 LLM이 나쁜 생성 결과로부터 학습할 수 있도록 하는 online learning 알고리즘인 Negative-aware Fine-Tuning (NFT)을 제안하였다. RFT와 마찬가지로, NFT는 좋은 답변으로 LLM을 supervised fine-tuning한다. 중요한 점은 NFT가 나쁜 답변을 단순히 버리는 대신, 이를 모델링하기 위한 implicit negative policy를 구축한다는 것이다. 이 implicit policy는 좋은 데이터로 최적화하려는 LLM을 통해 parameterize되므로, LLM의 모든 생성 결과에 대해 직접적인 policy 최적화가 가능하다. NFT는 학습 과정 내내 하나의 모델만 유지하면 되므로 메모리 오버헤드가 매우 적다.
놀랍게도, NFT와 GRPO는 완전히 다른 이론적 틀에서 출발했음에도 불구하고 엄격한 strict-on-policy 학습 환경에서는 실제로 동일한 성능을 보였다. 특히, GRPO의 advantage normalization 특성이 NFT의 loss에 이미 반영되어 있다. 두 방법의 주요 차이점은 off-policy 환경에서 학습된 policy가 old policy에서 벗어날 때 모델 gradient를 clipping하는 전략의 차이에서 나타난다.
저자들은 7B 및 32B 규모의 Qwen 모델을 대상으로 NFT를 평가하여 두 가지 주요 결과를 확인했다.
- Supervised learning만으로도 LLM의 수학적 추론 능력을 크게 향상시킬 수 있다.
- RFT와 RL 간에 나타나는 성능 격차는 RL의 본질적인 우위 때문이라기보다는, 기존 supervised learning이 나쁜 답변을 활용하지 못했던 한계에서 주로 기인한다.
Method
1. Problem Setup
데이터셋
$N$개의 수학 문제 집합 \(\{\textbf{q}^{1:N}\}\), 사전 학습된 LLM \(\pi_\textrm{old} (\textbf{o} \vert \textbf{q})\), 정답 여부 \(r \in \{0,1\}\)를 판별하는 verifier가 주어졌다고 가정하자. 매 iteration마다, 각 문제에 대해 $K$개의 답변 $\textbf{a}^{1:K}$가 수집되며, verifier가 정답 여부 $r^{1:K}$를 판단한다. 이를 통해 데이터셋 \(\mathcal{D} = \{\textbf{q}, \textbf{a}^{1:K} \sim \pi, r^{1:K}\}^{1:N}\)가 생성된다.
$\pi$를 통해 생성된 데이터셋 $\mathcal{D}$는 정답 부분집합 \(\mathcal{D}^{+}\)와 오답 부분집합 \(\mathcal{D}^{-}\)으로 둘로 나눌 수 있다. 이때 $\mathcal{D}^{+}$의 답변 분포를 $\pi^{+} (\cdot \vert \textbf{q})$로 표기한다.
Target policy
Old policy $\pi$를 새로운 policy \(\pi_\theta^{+} \approx \pi^{+}\)로 최적화하는 것이 목표이다. Target policy \(\pi^{+} (\textbf{a} \vert \textbf{q})\)는 Bayes’ Rule을 사용하여 다음과 같이 쓸 수 있다.
\[\begin{equation} \pi^{+} (\textbf{a} \vert \textbf{q}) = \pi (\textbf{a} \vert \textbf{q}, r=1) = \frac{\pi_\textrm{old} (\textbf{a} \vert \textbf{q}) p (r=1 \vert \textbf{q}, \textbf{a})}{\sum_{\textbf{a} \in A} \pi_\textrm{old} (\textbf{a} \vert \textbf{q}) p (r=1 \vert \textbf{q}, \textbf{a})} \end{equation}\]2. Direct Optimization of Language Models with Negative Answers
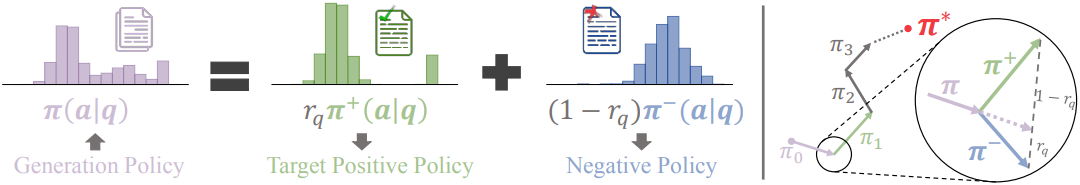
Target policy $\pi^{+}$는 negative policy $\pi^{-}$와 밀접하게 연관되어 있어 \(\mathcal{D}^{-}\)로부터 \(\pi_\theta^{+}\)를 직접 학습시키는 것이 가능하다.
\(\pi^{+} (\textbf{a} \vert \textbf{q})\)와 유사하게 negative policy $\pi^{-}$는 다음과 같이 정의된다.
\[\begin{equation} \pi^{-} (\textbf{a} \vert \textbf{q}) = \pi (\textbf{a} \vert \textbf{q}, r=0) = \frac{\pi_\textrm{old} (\textbf{a} \vert \textbf{q}) [1 - p (r=1 \vert \textbf{q}, \textbf{a})]}{\sum_{\textbf{a} \in A} \pi_\textrm{old} (\textbf{a} \vert \textbf{q}) [1 - p (r=1 \vert \textbf{q}, \textbf{a})]} \end{equation}\]두 식을 결합하면 다음과 같은 중요한 사실을 알 수 있다.
\[\begin{equation} r_\textbf{q} \pi^{+} (\textbf{a} \vert \textbf{q}) + [1 - r_\textbf{q}] \pi^{-} (\textbf{a} \vert \textbf{q}) = \pi_\textrm{old} (\textbf{a} \vert \textbf{q}) \\ \textrm{where} \quad r_\textbf{q} = \sum_{\textbf{a} \in A} \pi_\textrm{old} (\textbf{a} \vert \textbf{q}) p (r=1 \vert \textbf{q}, \textbf{a}) = p(r=1, \textbf{q}) \end{equation}\]\(r_\textbf{q}\)는 질문 $\textbf{q}$에 대한 LLM \(\pi_\textrm{old}\)의 정답률이다. 실제로는 데이터셋 $\mathcal{D}$에 포함된 $K$개의 reward의 평균으로 \(r_\textbf{q}\)를 추정할 수 있다.
\[\begin{equation} r_\textbf{q} \approx \textrm{mean} \{r^{1:K}\} \end{equation}\]Implicit negative policy
사전 학습된 LLM으로서 $\pi$가 이미 존재하고 \(r_\textbf{q}\)를 추정할 수 있다는 점을 고려할 때, 나쁜 답변을 통해 $\pi^{-}$를 학습시키는 것은 좋은 답변을 이용한 supervised learning과 유사한 방식으로 target policy \(\pi_\theta^{+}\)를 형성하게 될 것이다.
다음과 같이 target policy \(\pi_\theta^{+}\)를 re-parameterize함으로써 implicit negative policy \(\pi_\theta^{+}\)를 구성한다.
\[\begin{equation} \pi_\theta^{-} (\textbf{a} \vert \textbf{q}) = \frac{\pi_\textrm{old} (\textbf{a} \vert \textbf{q}) - r_\textbf{q} \pi_\theta^{+} (\textbf{a} \vert \textbf{q})}{1 - r_\textbf{q}} \end{equation}\]따라서 나쁜 답변에 대해 \(\pi_\theta^{-}\)를 학습시키는 것은 결과적으로 기반이 되는 LLM인 \(\pi_\theta^{+}\)를 최적화하는 것으로 이어진다.
좋은 데이터를 더욱 활용하기 위해, \(\mathcal{D}^{+}\)에 대한 학습을 추가로 수행한다.
\[\begin{equation} \mathcal{L}_{(\textbf{a}, \textbf{q}, r) \sim \mathcal{D}}^\textrm{NFT} (\theta) = r \left[ - \log \frac{\pi_\theta^{+} (\textbf{a} \vert \textbf{q})}{\pi_\textrm{old} (\textbf{a} \vert \textbf{q})} \right] + (1 - r) \left[ - \log \frac{1 - r_\textbf{q} \frac{\pi_\theta^{+} (\textbf{a} \vert \textbf{q})}{\pi_\textrm{old} (\textbf{a} \vert \textbf{q})}}{1 - r_\textbf{q}} \right] \end{equation}\]Loss에서 baseline 항인 \(- \log \pi_\textrm{old} (\textbf{a} \vert \textbf{q})\)를 뺀다. 이 항은 $\theta$와 무관하므로 loss의 gradient나 최적해에는 영향을 미치지 않는다. 학습 초기에는 \(\pi_\theta^{+} = \pi\)가 되어 \(\mathcal{L}_{(\textbf{a}, \textbf{q}, r) \sim \mathcal{D}}^\textrm{NFT} (\theta) = 0\)이 된다.
RFT와 비교했을 때, 이 방법은 policy 최적화를 위해 나쁜 답변을 추가로 활용할 수 있게 해주기 때문에 Negative-aware Fine-Tuning (NFT)라고 부른다.
Continuous Reward
수학적 추론을 위해 주로 binary reward를 고려하지만, NFT는 continuous reward에도 직접적으로 적용될 수 있다. 답변이 좋을 확률이 $r$, 나쁠 확률이 $1-r$임을 의미하는 optimality reward $r \in [0, 1]$을 정의할 수 있다. Loss 정의와 그 수렴 특성은 그대로 유지된다.
메모리 효율성
실제 구현 시에는 메모리에 단 하나의 모델 사본만 유지하기 때문에 NFT는 메모리 효율적이다. Old policy likelihood \(\pi_\textrm{old} (\textbf{a} \vert \textbf{q})\)는 데이터 생성 과정에서 미리 계산해 둘 수 있다.
3. Practical Algorithm
저자들은 \(\mathcal{L}_{(\textbf{a}, \textbf{q}, r) \sim \mathcal{D}}^\textrm{NFT} (\theta)\)에 몇 가지 개선 사항을 도입하고, NFT의 실용적인 loss를 제안하였다.
\[\begin{equation} \mathcal{L}_\mathcal{D}^\textrm{NFT} (\theta) = - \sum_{\textbf{q}, \textbf{a}, r} \omega (\textbf{q}) \sum_t \left[ r \log R_\theta^t (\textbf{q}, \textbf{a}) + (1 - r) \log \textrm{max_v} ( \frac{1 - \hat{r}_\textbf{q} R_\theta^t (\textbf{q}, \textbf{a})}{1 - \hat{r}_\textbf{q}}, \epsilon) \right] \\ \textrm{where} \quad R_\theta^t (\textbf{q}, \textbf{a}) = \frac{\pi_\theta^{+} (\textbf{a}_t \vert \textbf{q}, \textbf{a}_{< t})}{\pi_\textrm{old} (\textbf{a}_t \vert \textbf{q}, \textbf{a}_{< t})}, \quad \hat{r}_\textbf{q} = \frac{1}{K} \sum_{\textbf{a} \vert \textbf{q}} r (\textbf{q}, \textbf{a}), \quad \textrm{max_v}(\textbf{x}, \epsilon) = \textrm{stop-gradient}(\max (\textbf{x}, \epsilon) - \textbf{x}) + \textbf{x} \end{equation}\]Token-level loss
원래 loss는 본질적으로 시퀀스 데이터를 다루는데, 여기서 답변 확률 \(\pi (\textbf{a} \vert \textbf{q}) = \prod_t \pi (\textbf{a}_t \vert \textbf{q}, \textbf{a}_{< t})\)는 답변 길이와 강한 상관관계를 보인다. 이는 gradient 추정 시 높은 분산을 초래하고 학습 과정에서 수치적 불안정성을 유발한다. 저자들은 각 토큰 결정을 개별 단위로 간주하고 이들의 loss를 합산하였다.
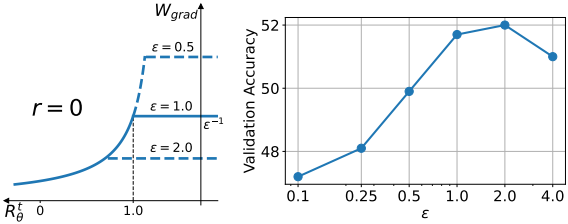
Clipping negative likelihood ratio
\(\frac{1 - \hat{r}_\textbf{q} R_\theta^t (\textbf{q}, \textbf{a})}{1 - \hat{r}_\textbf{q}}\)는 로그 함수에 들어가기 때문에 항상 양수여야 한다. \(R_\theta^t\)가 최적화되지 않은 상태에서는 이 조건이 충족되지 않을 수 있으며, 이는 잠재적으로 학습 붕괴를 초래할 수 있다. 따라서 최솟값 $\epsilon > 0$을 적용하고, clipping 후에도 gradient flow가 유지되도록 straight-through gradient 방식을 적용한다.
Prompt weighting
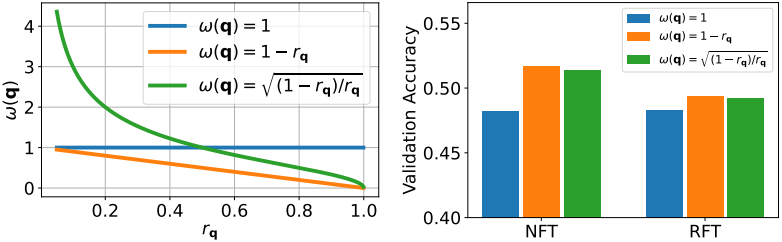
더 유익한 사례에 학습을 집중시키기 위해, 각 프롬프트 $\textbf{q}$에 가중치 $\omega (\textbf{q})$를 부여하여 \(r_\textbf{q}\) 값이 낮은 난이도 높은 질문에 더 높은 중요도를 할당한다.
Experiments
- Base model: Qwen2.5-Math-7B, Qwen2.5-32B
- 학습 데이터셋: DAPO-Math-17k
- 학습 디테일
- batch size 512
- 약 5,000 gradient step
- 생성 temperature: 1.0
1. NFT Performance Evaluation
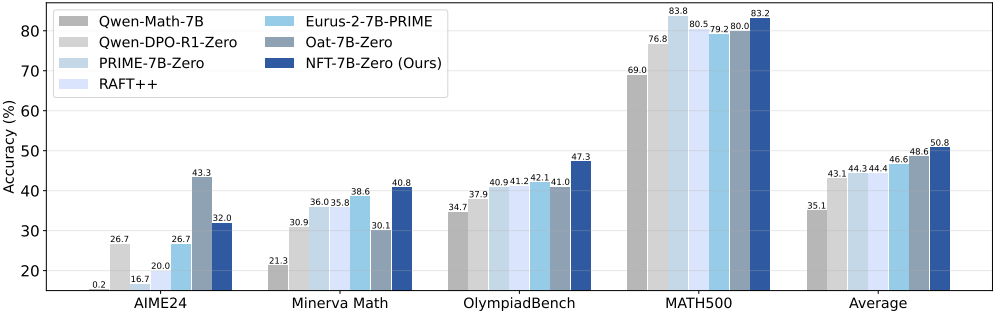
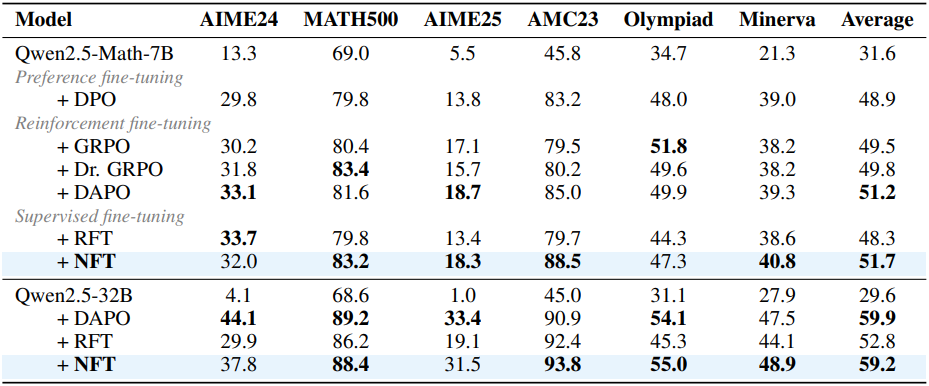
다음은 다른 알고리즘들과의 비교 결과이다.
2. Benefits of Negative Data
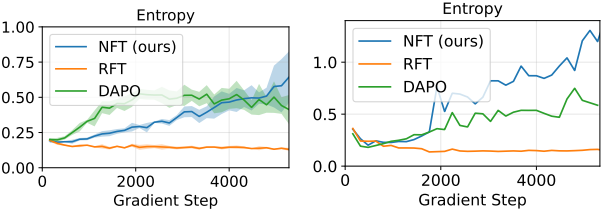
다음은 (왼쪽) 7B 모델과 (오른쪽) 32B 모델의 entropy curve를 비교한 것이다.
3. Ingredients Behind NFT’s Effectiveness
다음은 prompt weighting에 대한 영향을 비교한 결과이다.
다음은 $\epsilon$에 대한 영향을 비교한 결과이다.