[논문리뷰] ViT³: Unlocking Test-Time Training in Vision
CVPR 2026 (Oral). [Paper] [Github]
Dongchen Han, Yining Li, Tianyu Li, Zixuan Cao, Ziming Wang, Jun Song, Yu Cheng, Bo Zheng, Gao Huang
Tsinghua University | Alibaba Group
1 Dec 2025
Introduction
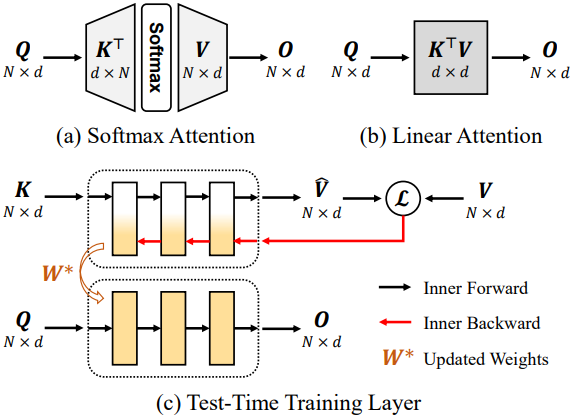
Test-Time Training (TTT) 모델은 전체 attention 연산을 온라인 학습 프로세스t로 재구성한다. 각 컨텍스트에서 key-value 쌍으로부터 간결한 내부 모델을 학습하거나 구축한 후 모든 query에 적용한다. Softmax attention과 linear attention의 고정된 설계와 달리, TTT는 내부 모델이 임의의 모듈 \(\mathcal{F}_W (\cdot) : \mathbb{R}^d \rightarrow \mathbb{R}^d\)가 될 수 있도록 한다. TTT는 key-value 쌍을 “mini-dataset”으로 취급하고 테스트 시점에 몇 step의 self-supervised 온라인 학습을 수행하여 이 내부 모델의 파라미터 $W$를 업데이트한다. 이러한 접근 방식은 훨씬 더 풍부하고 강력한 선형 복잡도 설계 공간을 열어주며, 다양한 시나리오에서 인상적인 $O(N)$ 시퀀스 모델링 결과를 제공한다.
\[\begin{equation} \hat{V} = \mathcal{F}_W (K), \quad W \leftarrow W - \eta \cdot \frac{\partial \mathcal{L} (\hat{V}, V)}{\partial W} \\ O = \mathcal{F}_W (Q) \end{equation}\]그러나 TTT의 설계 공간은 방대하고 아직 충분히 탐구되지 않았다. 내부 학습 과정 및 내부 모델 아키텍처와 관련된 핵심 선택 사항들에 대한 기존 연구들의 체계적인 이해가 부족하여 강력한 비전 TTT 모델 설계가 어렵다. 이러한 연구 공백이 바로 본 논문의 핵심 질문이다.
본 논문에서는 컴퓨터 비전 분야에서 TTT 모델의 새로운 설계 공간을 체계적으로 탐색하였다. 특히 내부 학습 설정과 내부 모델 설계라는 두 가지 핵심적인 측면에 초점을 맞추었다. 저자들은 일련의 실험을 통해 얻은 경험을 바탕으로 다음과 같은 6가지 통찰을 도출했다.
- \(\frac{\partial^2 \mathcal{L}}{\partial \hat{V} \partial V}\)가 거의 0이 되는 loss function $\mathcal{L}$은 적합하지 않다.
- Full-batch 내부 학습을 한 epoch만 수행해도 효과적이다.
- 비교적 큰 내부 learning rate가 효과적이다 (ex. 1.0).
- 내부 모델 용량을 증가시키면 성능이 지속적으로 향상된다.
- 현재 TTT 설정에서 깊은 내부 모델은 최적화에 어려움을 겪는다.
- Convolution 아키텍처는 비전 task에 특히 적합한 내부 모델이다.
이러한 연구 결과를 바탕으로, 본 논문에서는 비전 시퀀스 모델링에 최적화된 간단하고 병렬화 가능한 순수 TTT 아키텍처인 Vision Test-Time Training (ViTTT, ViT³) 모델을 제안하였다. ViT³는 이미지 분류, 이미지 생성, object detection, semantic segmentation 등 다양한 task에서 Mamba 및 linear attention과 같은 $O(N)$ 모델과 일관되게 동등하거나 그 이상의 성능을 보였으며, $O(N^2)$ ViT와의 성능 격차를 효과적으로 좁혔다.
Exploring Test-Time Training Designs
모든 실험은 ImageNet-1K에서 300 epoch 학습 설정으로 진행되었다.
1. Inner Training Configuration
Insight 1: \(\frac{\partial^2 \mathcal{L}}{\partial \hat{V} \partial V}\)가 0으로 소멸하는 inner loss function $\mathcal{L}$은 적합하지 않다.
TTT layer의 내부 학습 과정은 외부 네트워크와 함께 최적화된다. 구체적으로, value projection 행렬 $W_V \in \mathbb{R}^{C \times d}$는 내부 업데이트 항 \(G = \frac{\partial \mathcal{L} (\hat{V}, V)}{\partial W}\)에 적용된 backpropagation을 통해 outer-loop gradient를 얻는다. 즉, inner step을 통해 미분하고 gradient의 gradient를 취한다.
\[\begin{equation} \frac{\partial G}{\partial W_V} = \frac{\partial^2 \mathcal{L} (\hat{V}, V)}{\partial W \partial W_V} = \frac{\partial \hat{V}}{\partial W} \cdot \frac{\partial^2 \mathcal{L} (\hat{V}, V)}{\partial \hat{V} \partial V} \cdot \frac{\partial V_B}{\partial W_V} \end{equation}\]\(\frac{\partial^2 \mathcal{L}}{\partial \hat{V} \partial V}\)가 거의 0이면, inner step을 통한 backpropagation 후 outer loop의 $W_V$에 대한 gradient 신호가 사라져 학습이 저해되고 성능이 저하된다.
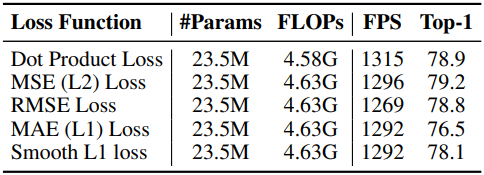
위 표는 이러한 분석을 뒷받침한다. \(\frac{\partial^2 \mathcal{L}}{\partial \hat{V} \partial V}\)이 거의 모든 곳에서 0인 MAE (L1) loss는 가장 낮은 정확도를 보인다. Smooth L1 loss 또한 특정 영역에서 \(\frac{\partial^2 \mathcal{L}}{\partial \hat{V} \partial V}\)가 소멸되기 때문에 성능이 저조한 반면, 이러한 문제를 나타내지 않는 나머지 세 가지 loss는 약 79.0%의 정확도를 달성하였다.
Insight 2: Full-batch 내부 학습을 한 epoch만 사용해도 비전 학습에 효과적이다.
아래 표는 batch size와 epoch 수에 대한 성능을 비교한 것이다. $B = N$은 full-batch gradient descent를 의미한다.
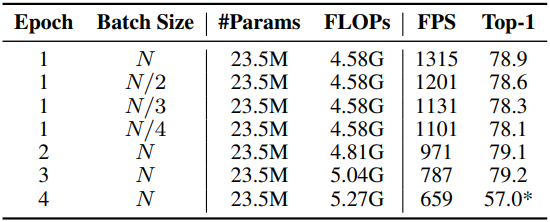
언어 모델링에 대한 기존 TTT 연구 결과에서는 더 작은 mini-batch가 성능 향상을 가져왔지만, 이 비전 실험에서는 $B = N$이 최상의 결과를 가져왔다. 이러한 차이는 인과적 데이터와 비인과적 데이터의 특성 차이에 기인한다. 구체적으로, 순차적 mini-batch gradient descent는 인과적 편향을 부과한다.
- 이전 mini-batch의 업데이트는 내부 모듈 가중치를 변경하여 이후 mini-batch의 gradient에 영향을 미친다.
- 이후 mini-batch의 업데이트는 이전에 생성된 업데이트를 덮어쓸 수 있다.
이러한 인과적 의존성은 언어와 같은 인과적 데이터에 이상적으로 적합하지만 비전에는 최적이 아닐 수 있다.
Full-batch 내부 학습을 여러 번 반복하면 정확도가 향상된다. 하지만 모델 처리량이 현저히 감소하고 학습 불안정성이 발생할 수 있다.
Insight 3: 비교적 큰 내부 learning rate 1.0이 효과적이다.
아래 표는 0.1에서 10까지 다양한 내부 learning rate $\eta$에 대한 결과이다.
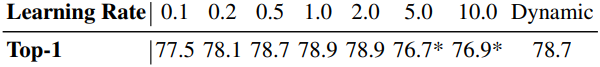
내부 learning rate가 작으면 내부 모델 가중치 $W$의 업데이트가 불충분하고, 지나치게 크면 학습 불안정성을 초래할 수 있다. 1.0일 때 외부 최적화의 안정성을 유지하면서 의미 있는 내부 업데이트가 이루어진다. 또한, 입력 의존적인 토큰별 동적 learning rate는 일반적으로 효과가 떨어지는 것으로 나타났다.
일부 특수한 경우, 내부 learning rate는 $K$와 $V$의 scaling에 포함될 수 있다. 예를 들어, 내부 모델이 linear layer $$\mathcal{F}_W (x) = xW$이고 inner loss가 MSE인 경우, gradient 기반 업데이트 항은 다음과 같다.
\[\begin{equation} \eta \cdot \frac{\partial \mathcal{L} (\hat{V}, V)}{\partial W} = \eta \cdot K^\top (KW - V) = \tilde{K}^\top (\tilde{K} W - \tilde{V}) \\ \textrm{where} \quad \tilde{K} = \sqrt{\eta} K, \; \tilde{V} = \sqrt{\eta} V \end{equation}\]즉, $K$와 $V$의 scaling은 수학적으로 $\eta$를 변경하는 것과 동일하다. 그럼에도 불구하고, 이러한 scaling은 학습하기 어렵거나 다른 모델 구성 요소와 호환되지 않을 수 있기 때문에 여전히 $\eta$는 중요한 hyperparameter이다.
2. Inner Model Design
Insight 4: 내부 모델 용량 증가는 성능 향상에 지속적인 영향을 미친다.
이를 검증하기 위해, 저자들은 내부 모델 \(\mathcal{F}_W (\cdot) : \mathbb{R}^d \rightarrow \mathbb{R}^d\)를 SiLU activation을 사용하는 2-layer MLP로 구현하고, hidden dimension을 $d$에서 $4d$까지 점진적으로 확장했다.
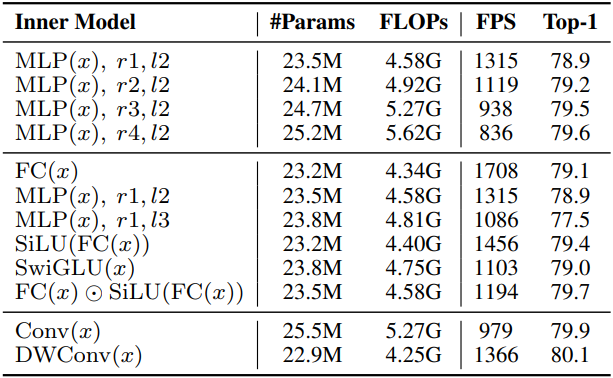
위 표에서 볼 수 있듯이, 내부 모델 용량이 증가함에 따라 정확도가 지속적으로 향상된다. 이는 기존의 linear attention 방식과 비교했을 때 TTT 패러다임의 핵심적인 장점을 보여준다. 즉, TTT는 내부 모델로 더욱 복잡한 비선형 모듈을 사용할 수 있도록 허용하고, 그 용량을 지속적으로 활용할 수 있도록 한다.
Insight 5: 현재 TTT 설정에서 깊은 내부 모델은 최적화에 어려움을 겪는다.
내부 모델의 폭을 조정하면 일관된 성능 향상을 가져온다. 일반적인 대안은 네트워크 깊이를 조정하는 것이다. 저자들은 깊이가 다른 세 가지 내부 모델 (linear layer, 2-layer MLP, 3-layer MLP)을 평가했다. 2-layer MLP와 3-layer MLP의 hidden dimension은 입출력 차원과 동일하게 $d$로 설정했다.
위 표에서 볼 수 있듯이, 정확도가 내부 모델 깊이에 따라 증가하지 않고 오히려 명확하게 저하되었다. 저자들은 내부 모듈의 깊이가 증가할수록 최적화 난이도가 높아져 효율성이 저하된다는 가설을 세웠다. 이 가설을 검증하기 위해 세 가지 아키텍처에 대한 학습 loss와 테스트 정확도를 비교하였다.
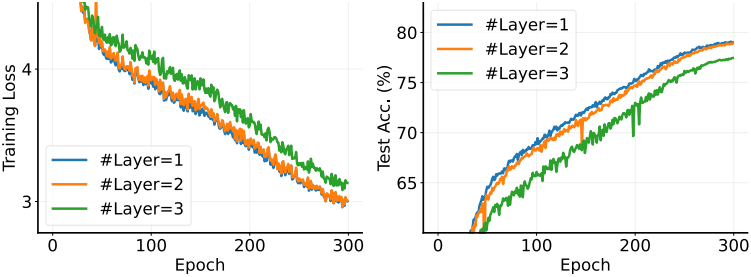
내부 모듈이 깊은 모델일수록 학습 loss가 크고, 따라서 테스트 정확도가 낮다. 즉, 이론적으로 내부 모듈이 깊을수록 표현력이 풍부하고 학습 데이터에 맞추기 쉽지만, 실제로는 underfitting으로 인해 성능이 저하된다.
또한, 출력 linear layer가 항등 함수로 고정된 2-layer MLP로 볼 수 있는 $\textrm{SiLU}(\textrm{FC}(x))$를 내부 모델로 사용하면 정확도가 78.9%에서 79.4%로 향상되었다. SwiGLU에서도 유사한 효과가 관찰되었다. SwiGLU의 출력 layer를 제거하면 정확도가 79.0%에서 79.7%로 향상되었다. 이러한 제약 조건이 있는 특수한 경우들은 원래 설계보다 훨씬 더 나은 결과를 보여주며, 최적화 문제의 타당성을 입증한다.
Insight 6: Convolution 아키텍처는 내부 모델로 특히 적합하다.
TTT 프레임워크의 유연성 덕분에 내부 모델 \(\mathcal{F}_W (\cdot)\)은 linear layer 기반 모듈에 국한되지 않고, 간결한 convolution 네트워크로 구현될 수 있다. 저자들은 표준 3$\times$3 convolution과 3$\times$3 depth-wise convolution을 평가했다.
위 표에서 볼 수 있듯이, 두 경우 모두 정확도가 크게 향상되었다. Convolution 기반의 내부 모듈을 사용하면 글로벌 정보와 로컬 정보를 자연스럽고 효율적으로 통합할 수 있다. TTT는 글로벌 컨텍스트 $K$, $V$를 \(\mathcal{F}_W (\cdot)\)의 파라미터로 압축한다. \(\mathcal{F}_W (\cdot)\)가 convolution으로 구현되면 글로벌 정보가 로컬 convolution 커널 가중치에 효과적으로 인코딩된다.
결과적으로 출력 \(O = \mathcal{F}_W (Q)\)를 계산하면 업데이트된 커널 가중치를 통한 글로벌 상호 작용과 convolution의 receptive field를 통한 로컬 상호 작용이 모두 실현되어, 글로벌 feature와 로컬 feature이 자연스럽게 통합되고 성능이 향상된다.
3. ViT³: A Test-Time Training Architecture
이러한 결과를 바탕으로, 저자들은 다양한 비전 task에서 TTT 방법의 벤치마킹을 위한 Vision Test-Time Training (ViT³) 모델을 도입하였다.
- learning rate: $\eta = 1.0$
- full-batch gradient descent, 1 epoch
- 내부 모듈: \(\mathcal{F}_1 = \textrm{FC}(x) \odot \textrm{SiLU}(\textrm{FC}(x))\), \(\mathcal{F}_2 = \textrm{DWConv}(x)\)
- 각 TTT block 내에서, 하나의 attention head에는 \(\mathcal{F}_2\)를 사용하고 나머지 head들에는 \(\mathcal{F}_1\)을 사용 인스턴스를
- 아키텍처: ViT³ (비계층적), H-ViT³ (계층적 4단계), DiT³ (생성용)
Experiments
1. Image Classification
다음은 비계층적 아키텍처들과의 ImageNet 이미지 분류 성능을 비교한 결과이다.
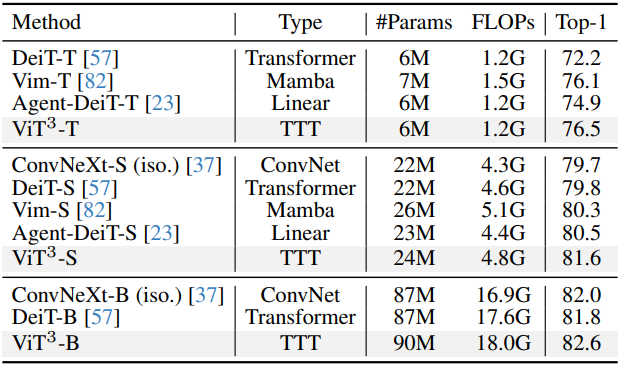
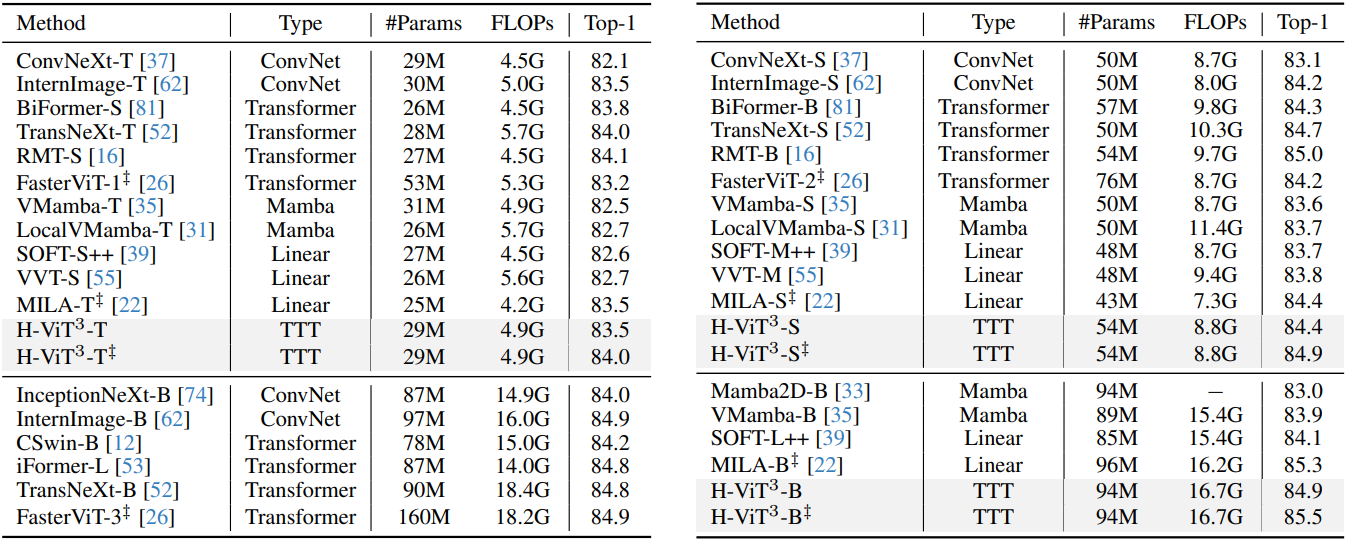
다음은 계층적 아키텍처들과의 ImageNet 이미지 분류 성능을 비교한 결과이다.
2. Object Detection
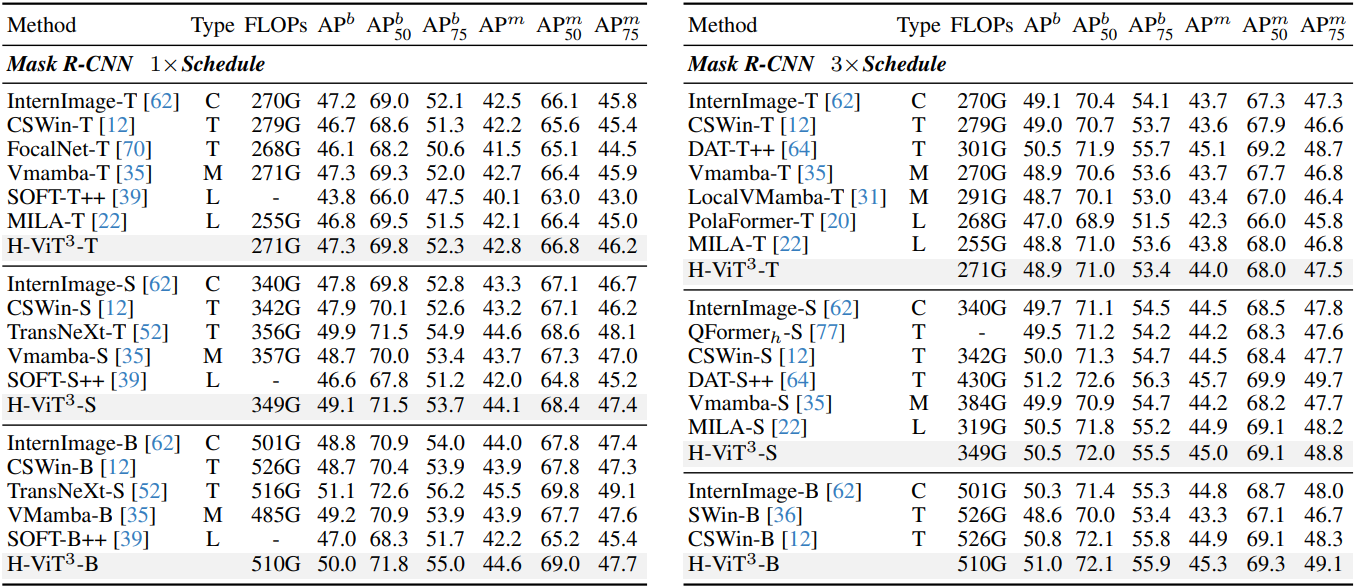
다음은 COCO 데이터셋에서 object detection을 비교한 결과이다. (C는 ConvNet, T는 Transformer, M은 Mamaba, L은 Linear attention)
3. Semantic Segmentation
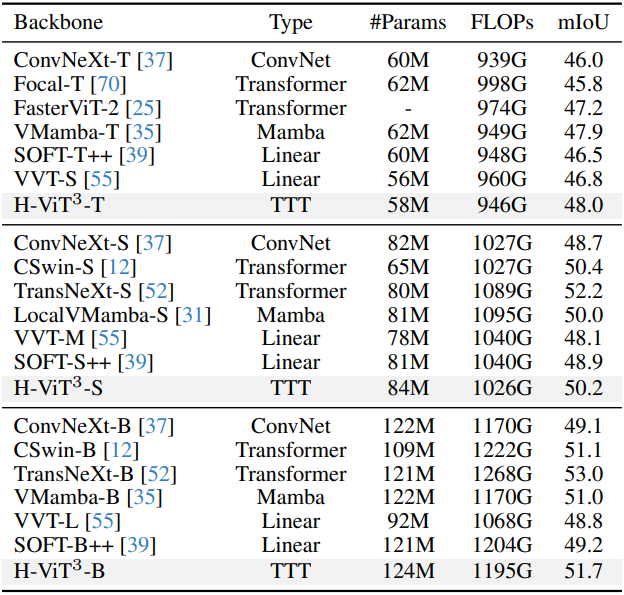
다음은 ADE20K 데이터셋에서 semantic segmentation을 비교한 결과이다.
4. Image Generation
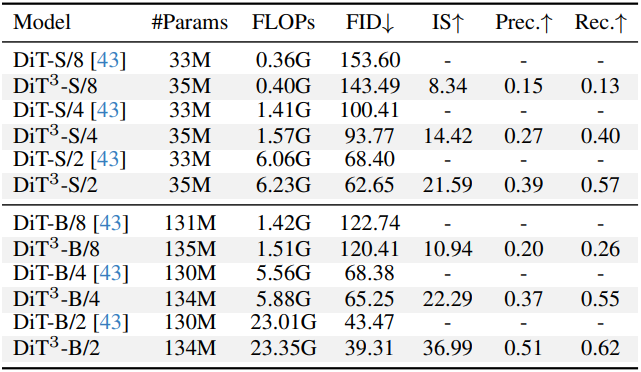
다음은 ImageNet-1K에서 클래스 조건부 이미지 생성을 비교한 결과이다.
5. Efficiency Analysis
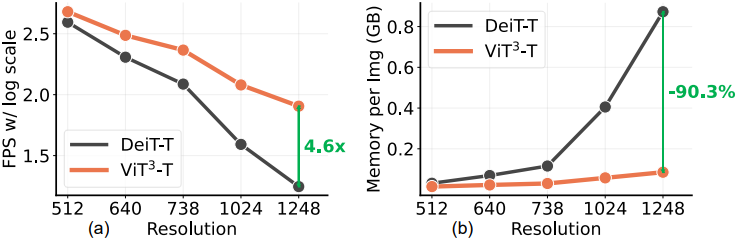
다음은 DeiT와 FPS (RTX3090), GPU 메모리 사용량을 비교한 결과이다.