[논문리뷰] WorldMirror: Universal 3D World Reconstruction with Any-Prior Prompting
ICML 2026. [Paper] [Page] [Github]
Yifan Liu, Zhiyuan Min, Zhenwei Wang, Junta Wu, Tengfei Wang, Yixuan Yuan, Yawei Luo, Chunchao Guo
ZJU | CUHK | Tencent
12 Oct 2025
Introduction
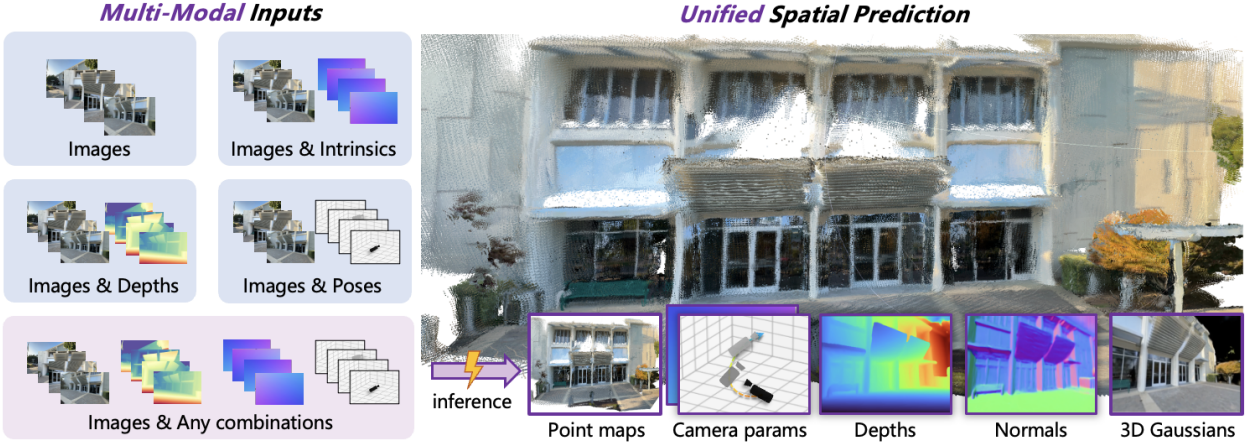
본 논문에서는 3D geometry를 위한 foundation model이 두 가지 핵심 속성을 가져야 한다고 주장한다.
- 보조 단서가 사용 가능할 때만 활용할 수 있는 유연한 입력을 수용해야 한다.
- 단일 아키텍처 내에서 포괄적인 geometry 출력을 생성해야 한다.
그러나 이 두 가지 속성을 모두 통합하는 것은 쉽지 않다. 유연한 입력 컨디셔닝은 다양한 보조 모달리티에 걸쳐 일반화되어야 하며, 여러 출력을 위해서는 입력의 종류가 많아질수록 더욱 복잡해지는 신중한 학습 전략이 필요하다.
이러한 문제들을 해결하기 위해, 본 논문에서는 사용 가능한 모든 geometry 모달리티를 유연하게 활용하면서 포괄적인 3D task를 수행하는 통합 end-to-end 프레임워크인 WorldMirror를 소개한다. 기존 접근 방식들이 prior 주입 또는 다중 task 예측 중 하나에만 초점을 맞추는 것과 달리, WorldMirror는 두 가지 핵심 설계를 통해 두 가지 문제를 동시에 해결하였다.
- Multi-modal Tokenization: 이미지, 카메라 intrinsic, 포즈, depth map을 포함한 모든 입력 모달리티를 통합된 시퀀스 내의 토큰으로 인코딩하여 아키텍처 수정 없이 사용 가능한 모든 prior를 원활하게 통합할 수 있도록 한다. 모든 토큰은 트랜스포머 backbone에 함께 입력되어 모델이 다양한 종류의 입력에 대해 통합된 방식으로 추론할 수 있도록 한다.
- Unified Spatial Prediction: 커리큘럼 학습을 통해 카메라 및 깊이 추정부터 point map, normal, novel view synthesis까지 모든 task를 처리하는 통합 디코더 head를 갖춘 Transformer 기반 아키텍처이다.
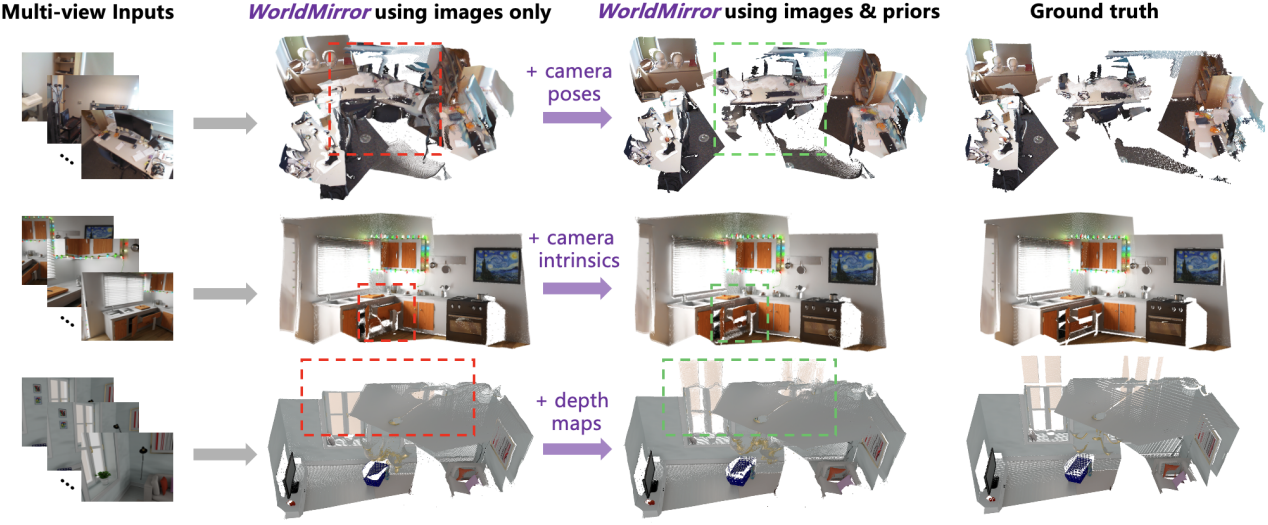
임의의 모달리티에 대한 prior 주입은 재구성뿐만 아니라 모든 출력 예측 성능을 전반적으로 향상시킨다. 이러한 새로운 시너지 효과는 입력 유연성과 다중 task 예측을 하나의 아키텍처 내에 통합하는 것의 이점을 강조하며, 공유된 표현을 통해 서로 다른 모달리티와 task가 서로의 이점을 활용할 수 있도록 한다.
Method
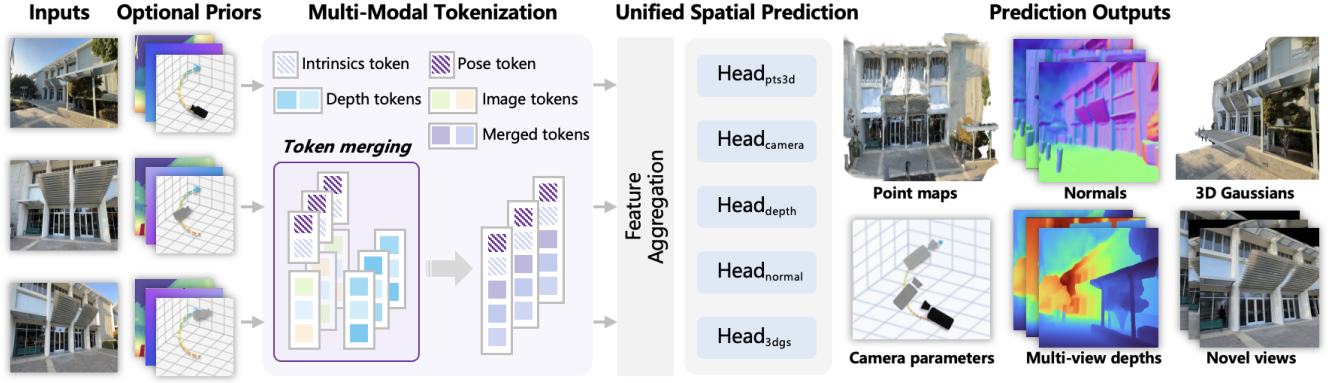
$N$개의 멀티뷰 이미지 \(\{\textbf{I}_i\}_{i=1}^N\)가 주어졌을 때, 본 논문의 목표는 임의의 사용 가능한 geometric prior를 활용하여 통합된 3D 예측을 수행하는 것이다.
1. Multi-modal Tokenization
Geometric prior를 활용하는 데 있어 핵심적인 과제는 task별 설계에 얽매이지 않고 다양한 모달리티에 걸쳐 유연한 컨디셔닝을 구현하는 것이다. Prior는 다양한 형식을 갖는다. Intrinsic은 행렬이고, 포즈는 SE(3) transformation이며, 깊이는 픽셀 단위의 dense한 측정값이다. 모달리티별 융합 모듈을 설계하는 대신, 모든 입력을 토큰으로 통합한다.
Modality-Specific Tokenization
카메라 포즈 \(\{[\textbf{R}_i \vert \textbf{t}_i]\}_{i=1}^N\)이 주어지면, 먼저 장면을 단위 정육면체로 정규화한다.
\[\begin{equation} \textbf{t}_i^\textrm{norm} = \frac{\textbf{t}_i - \textbf{c}}{\alpha} \end{equation}\]($\textbf{c}$는 장면 중심점, $\alpha$는 카메라와 중심점 사이의 최대 거리)
각 rotation \(\textbf{R}_i\)는 quaternion \(\textbf{q}_i \in \mathbb{R}^4\)로 변환되고, \(\textbf{t}_i^\textrm{norm}\)와 concat된 후, 2-layer MLP를 통해 각 뷰에 대한 포즈 토큰 \(\textbf{T}_i^\textrm{cam} \in \mathbb{R}^{1 \times D}\)로 projection된다.
카메라 intrinsic \(\textbf{K}_i \in \mathbb{R}^{3 \times 3}\)의 경우, 초점 거리와 주점 $(f_x, f_y, c_x, c_y)$를 추출하고 이미지 너비 $W$와 높이 $H$로 정규화한다. 이는 다양한 해상도에서 학습 안정성을 보장한다. 정규화된 4D 벡터는 2-layer MLP를 통해 intrinsic 토큰 \(\textbf{T}_i^\textrm{intr} \in \mathbb{R}^{1 \times D}\)로 projection된다.
Depth map은 다른 전략이 필요한 dense한 신호이다. Depth map \(\textbf{D}_i \in \mathbb{R}^{H \times W}\)가 주어졌을 때, 이를 [0, 1]로 정규화하고 patch embedding layer를 적용하여 이미지 토큰과 공간적으로 정렬된 깊이 토큰 \(\textbf{T}_i^\textrm{depth} \in \mathbb{R}^{(H_p \times W_p) \times D}\)를 생성한다. Concat하는 대신 깊이 토큰을 이미지 토큰에 바로 더하여 공간 구조를 유지하면서 외형과 geometry를 융합한다.
유연한 토큰 병합
모든 모달리티 토큰을 하나의 통합된 시퀀스로 병합한다. 포즈 토큰과 intrinsic 토큰은 이미지 토큰 \(\textbf{T}_i^\textrm{img} \in \mathbb{R}^{(H_p \times W_p) \times D}\)와 concat되고, 깊이 토큰은 이미지 토큰과 element-wise로 더해진다.
\[\begin{equation} \textbf{T}_i^\textrm{prompt} = [\textbf{T}_i^\textrm{cam}, \textbf{T}_i^\textrm{intr}, \textbf{T}_i^\textrm{img} + \textbf{T}_i^\textrm{depth}] \end{equation}\]학습 과정에서 \(\textbf{T}_i^\textrm{cam}\), \(\textbf{T}_i^\textrm{intr}\), \(\textbf{T}_i^\textrm{depth}\)의 각 토큰을 0.5의 확률로 독립적으로 랜덤하게 제거하고, 제거된 토큰의 값을 0으로 설정한다. 이를 통해 inference 시 입력 방식에 대한 유연한 제어가 가능하다.
저자들은 모달리티의 특성에 따라 각 모달리티를 다르게 처리하였다. 포즈와 intrinsic은 글로벌한 속성이므로 concat이 자연스럽다. 하지만 depth map은 공간적으로 dense하여, 이를 concat하면 토큰 수가 두 배로 늘어나고 attention 비용이 제곱으로 증가한다. 또한, 동일한 병합된 시퀀스가 모달리티별 branch 없이 모든 예측 head에 입력된다. 이러한 특성 덕분에 새로운 모달리티는 아키텍처를 수정하지 않고 해당 tokenizer를 추가하는 것만으로 간단하게 통합할 수 있다.
2. Unified Spatial Prediction
저자들은 진정한 의미의 통합 멀티태스킹 프레임워크를 구현하기 위해, 한 번의 feed-forward pass 내에서 point map, 카메라 파라미터, depth map, 표면 normal 벡터, 3D Gaussian을 동시에 예측하는 포괄적인 아키텍처를 설계했다. 그러나 이러한 task들을 동시에 최적화하는 것은 상당한 어려움을 수반한다. Geometry와 외형 학습의 상호 연관성으로 인해 개별 task 성능이 제한되는 경우가 많기 때문이다. 이러한 문제를 해결하기 위해, geometry 예측과 외형 재구성을 분리하는 모델링 전략과, 학습 과정에서 task 난이도를 점진적으로 균형 있게 조절하는 커리큘럼 학습 방식을 도입했다.
Geometry 모델링
VGGT에서 사용된 아키텍처에서 영감을 받아, 저자들은 global-local attention 메커니즘과 multi-head 디코더를 갖춘 Transformer backbone을 구축하였다. 입력 이미지는 선택적 prior와 함께 tokenize되고, 생성된 토큰 \(\textbf{T}_i\)는 backbone에 입력되어 멀티뷰 feature \(\textbf{F}_i\)를 추출한다. 이러한 feature는 이후 DPT 디코더를 거쳐 3D point map \(\hat{\textbf{P}}_i\), 멀티뷰 depth map \(\hat{\textbf{D}}_i\), 표면 normal map \(\hat{\textbf{N}}_i\)를 포함한 dense한 예측값을 생성한다. 또한, \(\textbf{F}_i\)는 MLP 디코더를 통해 카메라 파라미터 \(\hat{\textbf{E}}_i\)를 추정하는 데 사용된다.
VGGT에 포함되지 않은 표면 normal 추정 task의 경우, 단위 길이 벡터 출력을 보장하기 위해 L2 정규화를 적용한다.
\[\begin{equation} \hat{\textbf{N}}_i = \frac{\textrm{DPT}_n (\hat{\textbf{T}}_i^\textrm{img})}{\| \textrm{DPT}_n (\hat{\textbf{T}}_i^\textrm{img}) \|_2} \end{equation}\]GT normal 데이터가 부족하기 때문에, 주석이 있는 normal 레이블과 plane fitting을 통해 GT depth map에서 추출한 pseudo normal을 모두 활용한다. 이 전략을 통해 다양한 데이터셋을 효과적으로 활용하여 일반화 성능을 향상시킬 수 있다.
외형 모델링
본 논문에서는 3D Gaussian Splatting (3DGS)을 사용하여 새로운 시점에서의 고품질 이미지를 렌더링한다. 특수 DPT 디코더인 \(\textrm{DPT}_g (\cdot)\)를 사용하여 위치 $x_g$, 색상 $c_g$, 불투명도 \(\sigma_g\), scale $s_g$, rotation $r_g$를 포함한 픽셀 단위의 3DGS 속성을 예측한다. Gaussian 위치는 예측된 깊이 \(\hat{\textbf{D}}_g\)와 GT 카메라 파라미터 $[\textbf{R} \vert \textbf{t}]$로부터 계산된다. Gaussian 색상은 원본 이미지의 RGB 값과 예측된 RGB residual을 결합하여 얻는다. 여러 시점에 걸쳐 겹치는 영역으로 인해 발생하는 Gaussian 중복을 줄이기 위해 AnySplat과 유사하게 voxelization을 통해 픽셀 단위의 Gaussian을 클러스터링하고 pruning한다.
Gaussian 속성, 포인트 클라우드 위치, 카메라 파라미터를 동시에 예측하는 것은 본질적으로 어려운 문제이다. 저자들은 geometry와 외형 정보 간의 얽힘을 완화하기 위해 \(\textrm{DPT}_g (\cdot)\)와 새로운 시점 학습 전략을 신중하게 설계했다. 구체적으로, 입력 시점과 새로운 시점 모두에 dual rendering supervision을 적용하여 모델이 시점 간에 기하학적으로 일관된 3D 표현을 학습하고 floater 아티팩트를 효과적으로 억제하도록 했다.
카메라 오차가 누적되어 외형 supervision을 손상시키는 것을 방지하기 위해 3DGS 렌더링은 예측된 카메라 파라미터가 아닌 GT 카메라 파라미터를 사용한다. 또한, GS head는 depth head 또는 point map head의 출력을 재사용하는 대신 Gaussian 위치를 독립적으로 예측하여 렌더링 task가 다른 task를 저하시키지 않고 geometry 정확도와 외형 품질의 균형을 자율적으로 유지할 수 있도록 한다.
분리형 순차 학습
저자들은 학습 효율성을 최적화하고 성능을 향상시키기 위해 task 순서를 단순한 task에서 복잡한 task로 점진적으로 진행하는 체계적인 분리형 순차 학습 방식을 채택했다.
- Multi-modal Tokenization 모듈은 VGGT의 사전 학습된 가중치를 기반으로 초기화된 다른 파라미터들과 함께 공동 학습을 수행하여 prior를 고려한 예측의 기초를 다진다.
- Normal 예측을 공동 학습 체계에 통합한다.
- 모든 모델 파라미터를 고정하고 3DGS 속성 예측을 위한 3DGS head만 단독으로 학습한다.
이러한 점진적인 task 순서 전략은 어떤 prior 조합에서도 범용적인 geometry 예측을 위한 효과적인 학습을 보장한다. 모든 task를 공동으로 학습할 경우 모델이 geometry와 외형 정보를 구분하기 어려워 최적의 성능을 달성하지 못한다.
3. Model Training
모델은 모든 예측 task에 대한 supervision을 통합하는 복합 loss function $\mathcal{L}$을 최소화하는 방식으로 end-to-end 학습된다.
\[\begin{equation} \mathcal{L} = \lambda_1 \mathcal{L}_\textrm{points} + \lambda_2 \mathcal{L}_\textrm{depth} + \lambda_3 \mathcal{L}_\textrm{cam} + \lambda_4 \mathcal{L}_\textrm{normal} + \lambda_5 \mathcal{L}_\textrm{3dgs} \end{equation}\]Experiments
1. Evaluation on Different Tasks
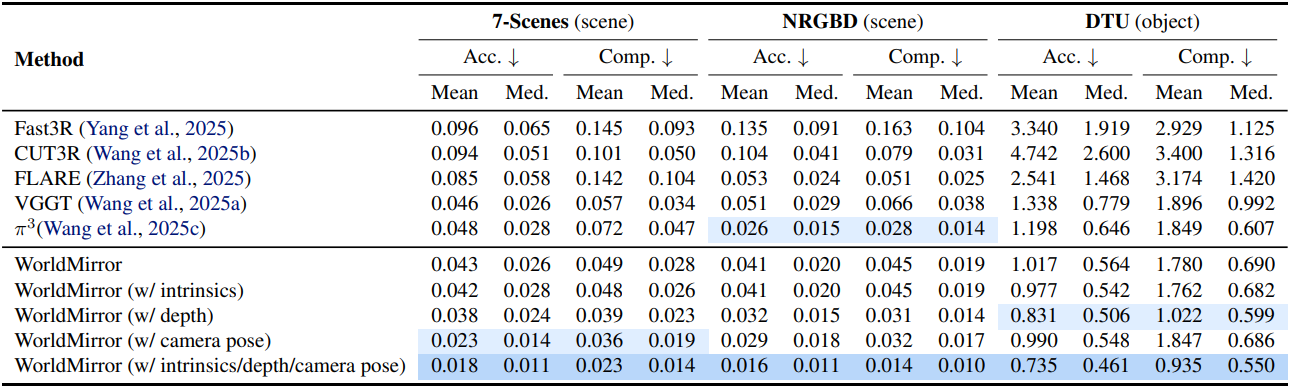
다음은 point map 재구성에 대한 비교 결과이다.
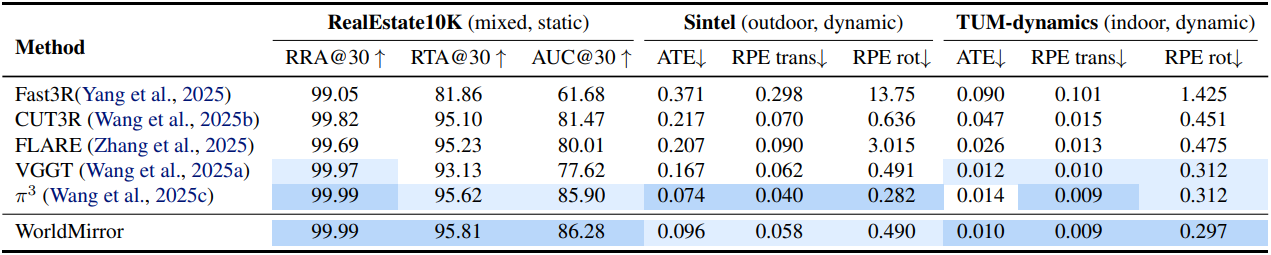
다음은 카메라 포즈 추정에 대한 비교 결과이다.
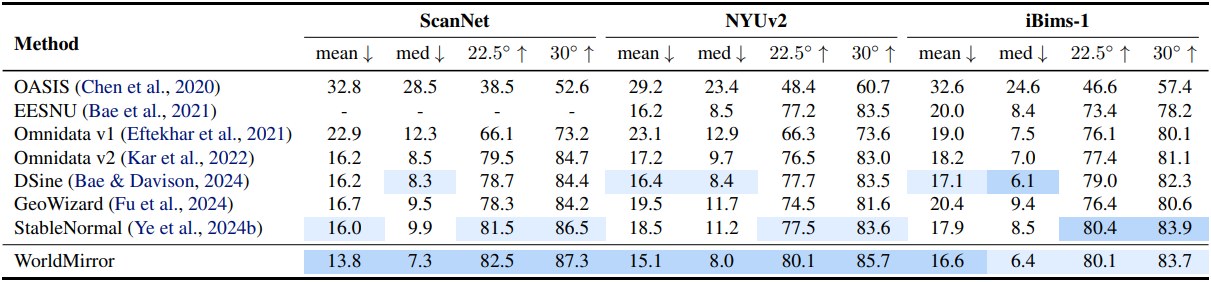
다음은 표면 normal 추정에 대한 비교 결과이다.
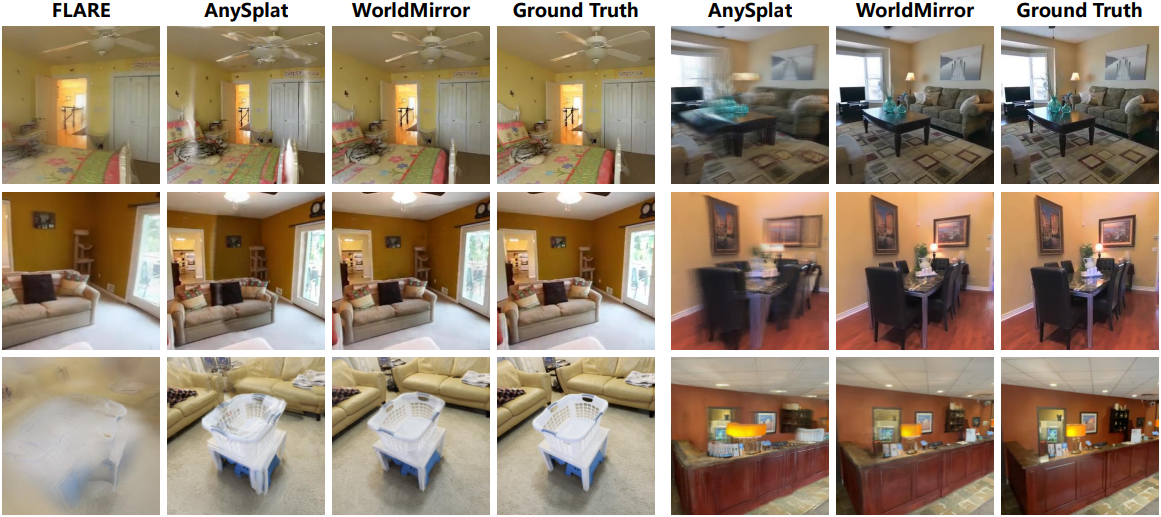
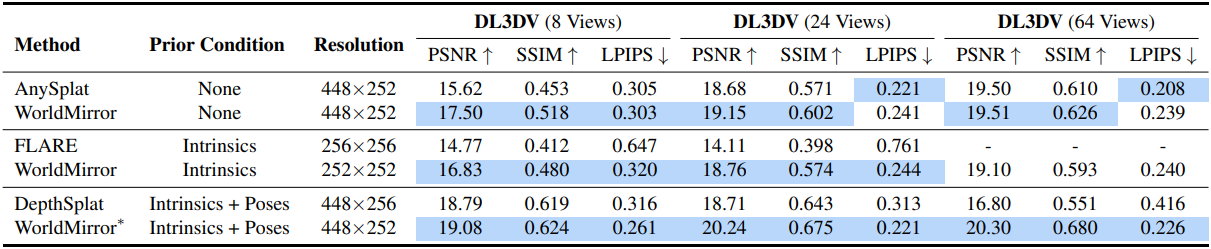
다음은 novel view synthesis에 대한 비교 결과이다.
2. Evaluation on Different Input Configurations
다음은 다양한 입력 구성에 따른 결과를 비교한 것이다.
3. Comparison with Prior-guided Methods
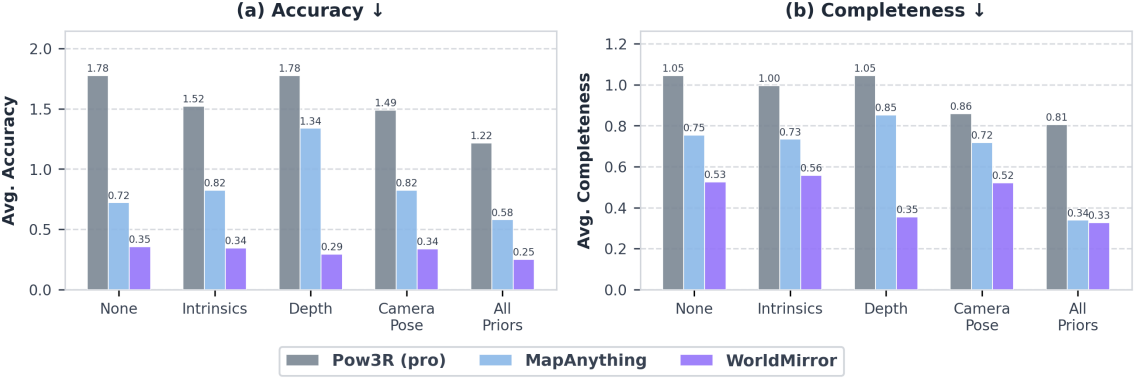
다음은 다양한 prior 조건에 대하여 Pow3R, MapAnything과 비교한 결과이다.
4. Ablation Study
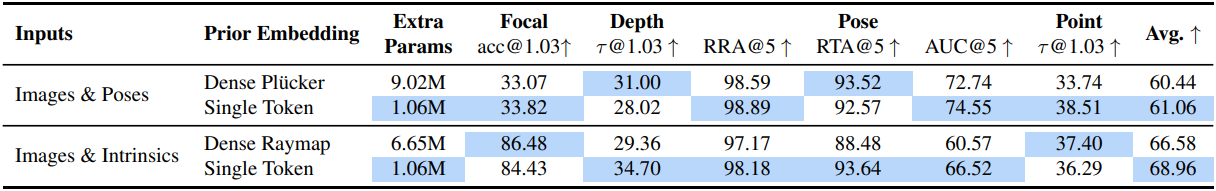
다음은 prior 임베딩에 대한 ablation 결과이다.
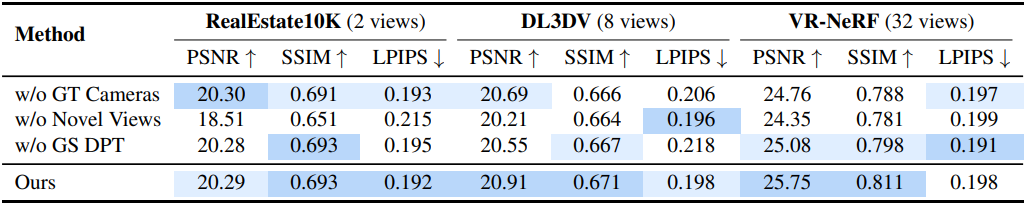
다음은 novel view synthesis에 대한 ablation 결과이다.