[논문리뷰] Latent Reasoning VLA: Latent Thinking and Prediction for Vision-Language-Action Models
ICML 2026. [Paper] [Page] [Github]
Shuanghao Bai, Jing Lyu, Wanqi Zhou, Zhe Li, Dakai Wang, Lei Xing, Xiaoguang Zhao, Pengwei Wang, Zhongyuan Wang, Cheng Chi, Badong Chen, Shanghang Zhang
Xi’an Jiaotong University. 2 Beijing Academy of Artificial Intelligence. 3 Institute of Automation, University of Chinese Academy of Sciences. 4 School of Artificial Intelligence, University of Chinese Academy of Sciences. 5 Peking University.
1 Feb 2026
Introduction
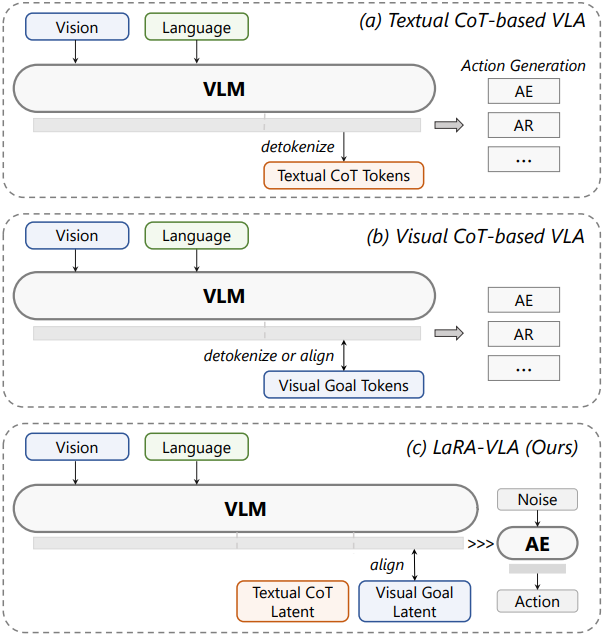
VLA 모델을 위한 기존의 CoT 접근 방식은 모달리티에 따라 크게 분류할 수 있다. Textual CoT 기반 방법은 중간 추론을 자연어로 명시적으로 표현하며, 시각적 관찰에서 얻은 정보를 추가적으로 언어화할 수도 있다. Visual CoT 기반 방법은 일반적으로 미래 관찰 또는 중간 visual state를 모델링하여 시각적 재구성 또는 예측을 통해 추론을 표현한다.
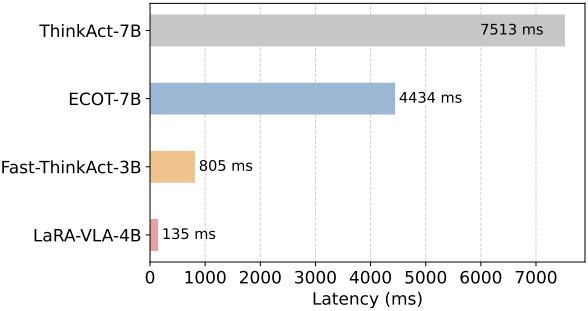
기존의 CoT 기반 방법들은 효과적임에도 불구하고 두 가지 근본적인 문제에 직면해 있다. 첫째, 텍스트 기반 CoT는 추론 과정에서 광범위한 텍스트 추론을 필요로 하여 상당한 계산 오버헤드를 발생시킨다. 긴 추론 과정은 토큰 길이를 급격히 증가시켜 KV 캐시 사용량 과다, 메모리 소비 증가, inference 시간 증가를 초래한다. 이는 실시간 로봇 제어에는 부적합하다.
둘째, 대부분의 CoT는 discrete한 표현에 의존한다. Textual CoT는 언어 토큰으로 제한되는 반면, visual CoT는 일반적으로 VQ 기반 tokenizer에서 생성된 discrete한 visual token과 정렬한다. 본 논문에서는 CoT가 자연어로 표현되기 때문이 아니라 구조화된 중간 추론을 드러내기 때문에 효과적이라고 주장한다. 지각과 행동이 continuous space에서 진화하는 실제 환경에서 추론을 discrete한 토큰으로 제한하면 추론과 제어 간의 표현 불일치가 발생한다.
이러한 문제들을 해결하기 위해, 본 논문에서는 로봇 action에 대한 추론과 예측을 모두 latent space에서 수행하는 Latent Reasoning VLA (LaRA-VLA)를 제안하였다. 본 논문에서는 latent 추론을 VLA 모델에 적용하여 구조화된 추론을 continuous한 latent로 내재화할 수 있도록 하며, textual CoT와 미래 지향적인 visual CoT를 모두 continuous한 latent로 내재화한다. Visual goal latent는 textual latent 추론에 대한 implicit supervision 역할을 하여, 학습된 latent 역학을 action 생성에 직접적으로 활용할 수 있도록 한다.
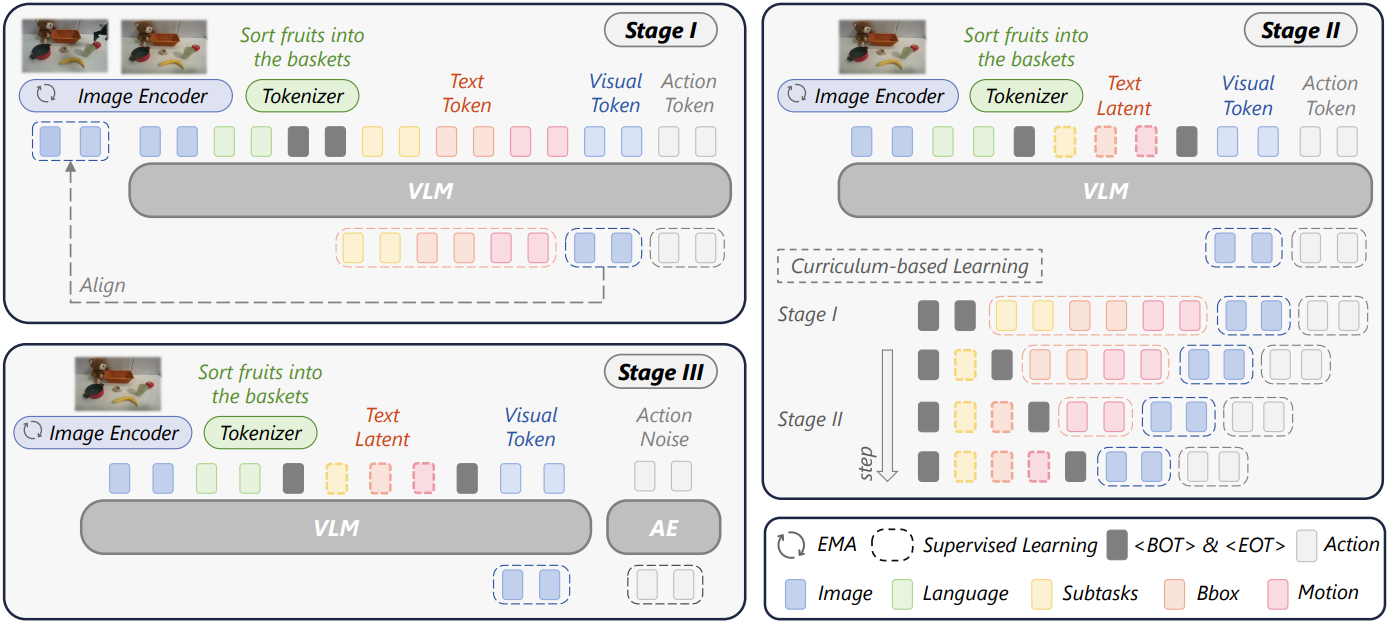
저자들은 명시적 멀티모달 추론에서 latent embodied reasoning으로 전환하는 3단계 학습 패러다임을 제안하였다. 학습은 textual CoT와 visual CoT를 통합해 학습시키는 단계로 시작하며, 이때 텍스트 추론 단계와 미래 비전 예측을 각각의 주석에 명시적으로 정렬한다. 이후 embodied reasoning을 continuous latent state의 시퀀스로 모델링하는 커리큘럼 기반 전략을 적용한다. 명시적인 textual CoT를 적은 수의 압축된 latent로 점진적으로 대체하고, visual prediction loss를 implicit supervision으로 사용함으로써 추론 구조를 모델 내부에 내재화한다.
Textual CoT가 latent 추론에 완전히 흡수된 뒤에는, latent 추론 역학이 continuous한 제어 출력을 직접 컨디셔닝하도록 모델을 action 생성에 추가로 적응시킨다. 학습 전반에서 supervision에 사용되는 visual latent는 입력 관측을 인코딩하는 것과 동일한 비전 인코더로부터 얻는다. 또한 latent 표현 학습을 안정화하고 표현 붕괴를 방지하기 위해 EMA 기반 인코더를 target network로 사용한다.
본 논문의 접근 방식은 latent CoT 추론을 언어 전용 세팅에서 VLA 모델로 확장하여, inference 시에 명시적인 CoT 생성 없이 효율적이고 action 지향적인 추론을 가능하게 한다. LaRA-VLA는 latent 추론 역학을 action 생성과 직접 연결함으로써, 장황한 텍스트 추론 대신 간결한 latent CoT에 연산을 할당하여 실시간 로봇 제어에 매우 적합하다. 또한, 추론을 continuous한 latent 역학으로 표현함으로써 표현 불일치를 방지한다.
Method
1. Data Collection
효율적인 로봇 조작에는 장기적인 subtask 구조 모델링, 타겟 object의 spatial grounding, 그리고 action 실행을 위한 모션 수준 추론이 모두 필요하다. 그러나 기존의 데이터 수집 파이프라인은 일반적으로 이러한 구성 요소를 개별적으로 캡처하여, 중복되거나 불완전한 supervision을 야기한다.
이러한 한계를 해결하기 위해, 저자들은 semantic anchor와 temporal anchor를 기반으로 하는 anchor-first, generate-later 패러다임을 따르는 완전 자동화된 어노테이션 파이프라인을 개발했다. Semantic anchor는 Qwen3-VL을 사용하여 초기 프레임과 task instruction으로부터 조작할 타겟 object를 식별하여 추출하고, temporal anchor는 gripper 상태 변화에 따라 로봇 궤적을 세부적인 조작 단계로 분할하여 얻는다. 이러한 앵커를 기반으로 Qwen3-VL은 간결한 subtask 설명을 생성하고, GroundingDINO와 SAM3를 사용한 open-vocabulary grounding을 통해 시간적으로 일관된 타겟 object bounding box를 생성한다. 모션 추론은 end-effector 궤적에서 도출되며, 이러한 모션들은 directional descriptor들로 discretize되어 CoT 주석에 통합된다.
본 파이프라인을 기반으로 시뮬레이션 환경에서 LIBERO, SimplerEnv라는 두 가지 벤치마크 데이터셋을 구축하여 LIBERO-LaRA 및 Bridge-LaRA를 생성하고, 동일한 프레임워크를 물리적 하드웨어에서 수집한 실제 로봇 조작 데이터셋에 적용하였다.
2. Model Architecture
본 논문에서는 Qwen3-VL을 backbone VLM으로 채택하고, 이미지 인코더를 직접 계승하여 학습 전반에 걸쳐 일관된 시각적 표현을 보장하였다. Visual goal 정보를 예측하기 위해, 예측된 visual latent를 나타내는 전용 <img_next> 토큰을 도입하여 초기 latent 추론 학습 단계에서 명시적인 supervision과 정렬을 가능하게 한다.
Stage I과 II의 action 예측에는 FAST와 유사한 autoregressive action token 디자인을 적용하여 모델이 안정적이고 효율적인 방식으로 latent 추론과 action 생성을 동시에 학습할 수 있도록 하였다.
Stage III에서는 명시적인 action 토큰 예측을 제거하고 전용 action expert를 활성화하여 토큰 수준의 autoregressive 디코딩에서 action 생성을 분리하였다. 구체적으로, action 생성은 self-attention layer와 cross-attention layer가 교대로 배열된 16-layer DiT를 통해 수행되며, 학습된 latent 표현을 조건으로 하여 continuous한 action 궤적을 생성한다.
3. Training Procedures
Stage I: Explicit CoT Fine-Tuning
Stage I에서는 명시적인 CoT 주석이 포함된 데이터셋을 사용하여 VLM을 fine-tuning한다. 이러한 주석은 task 분해, 동작 추론, 타겟 object 정보 등을 포함한 구조화된 추론 supervision을 제공하여 모델이 명시적인 중간 추론을 통해 실제 조작 task에 적응할 수 있도록 한다.
입력 이미지(observation)와 언어 명령이 주어지면, observation은 이미지 인코더를 통해 visual token 시퀀스 $\textbf{v}$로 매핑되고, 명령 텍스트는 텍스트 토큰 시퀀스 $\textbf{x}$로 tokenize된다. VLM은 $\textbf{v}$와 $\textbf{x}$ 모두에 동시에 attention하며, CoT 토큰 시퀀스를 autoregressive하게 생성하도록 학습된다. 이 단계에서는 discrete한 GT 텍스트 토큰을 사용하여 teacher forcing을 통해 CoT 생성을 명시적으로 학습시킨다. 학습 loss는 GT CoT 시퀀스의 negative log-likelihood로 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{cot} = - \sum_{t=1}^{T_\textrm{cot}} \log p_\theta (c_t \mid c_{< t}, \textbf{v}, \textbf{x}) \end{equation}\]텍스트 supervision 외에도, 미래의 visual latent를 예측하여 시각적 추론을 정렬한다. 다음 observation의 visual latent를 \(\textbf{z}_{t+1}\)라 하자. \(\textbf{z}_{t+1}\)는 입력 observation에 사용된 것과 동일한 이미지 인코더로 인코딩된다. VLM은 현재 컨텍스트에서 이 latent를 \(\hat{\textbf{z}}_{t+1}\)로 예측하며, 다음과 같은 정렬 loss를 사용한다.
\[\begin{equation} \mathcal{L}_\textrm{vis} = \| \hat{\textbf{z}}_{t+1} - \textbf{z}_{t+1} \|_1 \end{equation}\]Visual latent 학습을 안정화하고 표현 붕괴를 방지하기 위해, 온라인 인코더 파라미터 \(\theta_v\)에 대한 exponential moving average (EMA)를 사용하여 타겟 visual latent를 계산하는 데 사용되는 파라미터 \(\bar{\theta}_v\)를 업데이트한다.
\[\begin{equation} \bar{\theta}_v^t = \tau_v \bar{\theta}_v^{t-1} + (1 - \tau_v) \theta_v^t \end{equation}\]Action은 inverse dynamics 모델을 통해 추론된다.
\[\begin{equation} f(\textbf{v}_t, \textbf{v}_{t+1} \mid \textbf{x}, c) = \textbf{a}_t \end{equation}\]Latent 추론 단계 전반에 걸쳐 action 정보를 효율적으로 전파하기 위해, 모든 latent 표현에 대략적인 action semantics를 할당하는 FAST 프레임워크를 채택하였다. 구체적으로, action 토큰은 \(\mathcal{L}_\textrm{cot}\)과 유사한 autoregressive loss인 \(\mathcal{L}_\textrm{act-dis}\)를 사용하여 학습된다.
Stage II: Curriculum-based Replacement of Discrete CoT Tokens
Stage II에서는 커리큘럼 기반 학습 전략을 통해 명시적인 텍스트 추론을 latent space에 내재화한다. Embodied reasoning은 continuous한 latent state의 시퀀스로 모델링되며, 학습 과정에서 discrete한 CoT 토큰이 점진적으로 latent 표현으로 대체된다.
학습 loss는 Stage I과 동일한 학습 loss를 사용한다. 그러나 모든 추론 단계를 discrete한 GT CoT 토큰과 비교하는 대신, CoT 토큰의 부분집합을 점진적으로 제거하고 학습 가능한 latent 표현으로 대체한다. Discrete한 CoT 토큰의 비율은 미리 정의된 커리큘럼 일정에 따라 학습이 진행됨에 따라 감소하여, 전체 CoT가 latent space에 완전히 내재화될 때까지 계속된다.
Stage III: Action Generation via Flow Matching
Continuous한 제어에 latent 추론을 적용하기 위해 flow matching loss를 사용하여 action 예측 모듈을 학습시킨다. Flow matching 공식에 따라 noise와 action 사이의 linear interpolation을 다음과 같이 정의한다.
\[\begin{equation} \textbf{a}_\tau = (1 - \tau) \epsilon + \tau \textbf{a}_t, \quad \textrm{where} \; \epsilon \sim \mathcal{N}(\textbf{0},\textbf{I}), \; \tau \sim \mathcal{U}(0, 1) \end{equation}\](\(\textbf{a}_t\)는 timestep $t$에서의 GT action)
Action expert는 멀티모달 latent 컨텍스트 \(\textbf{h}_t\)를 조건으로 velocity field \(v_\theta (\textbf{a}_\tau, \tau \mid \textbf{h}_t)\)를 예측한다. 구체적으로, \(\textbf{h}_t\)는 현재 observation과 언어 명령의 latent, 중간 텍스트 기반 추론 latent, 그리고 VLM이 예측한 미래 visual latent를 통합한다.
이전 단계에서 적용된 inverse dynamics supervision을 통해 이 latent 컨텍스트는 이미 action 관련 정보를 대략적으로 인코딩하고 있다. 결과적으로 추가적인 action latent 표현을 도입하지 않고, 공유 멀티모달 latent 표현에서 직접 action을 생성한다. Flow matching loss는 다음과 같이 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{act-con} = \mathbb{E}_{\textbf{a}_t, \epsilon, \tau} \left[ \| v_{\theta_a} (\textbf{a}_\tau, \tau \mid \textbf{h}_t) - (\textbf{a}_t - \epsilon) \|_2^2 \right] \end{equation}\]LaRA Attention Mechanism
본 논문에서는 3단계 학습 패러다임에 맞춘 attention 메커니즘을 도입하였다. 모델은 텍스트, 현재 이미지, 미래 이미지, action 토큰을 포함한 멀티모달 토큰을 처리하며, attention 제약을 통해 토큰 간 정보 흐름을 명시적으로 조절한다.
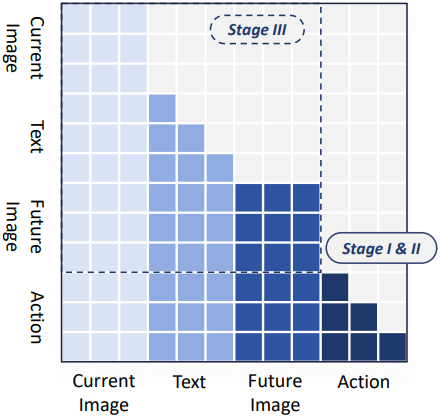
텍스트 토큰은 Stage I과 II에서는 언어 명령 및 textual CoT에, Stage II와 III에서는 텍스트 latent에 대응하는 통합된 추상화 역할을 한다. Stage I과 II에서 미래 이미지 토큰은 텍스트 및 현재 이미지 토큰에 인과적으로 attention하는 동시에, 토큰 간에 양방향으로 상호작용한다. Action 토큰은 autoregressive하게 생성되며, 각 action 토큰은 이전의 모든 텍스트, 현재 이미지, 미래 이미지 토큰뿐만 아니라 이전에 생성된 action 토큰에도 attention한다. Stage III에서는 action 토큰이 attention 계산에서 제외되고, 모델은 동일한 attention 제약 하에서 텍스트 및 비전 토큰만을 사용하여 학습된다.
Loss Function
학습 loss는 단계별로 설정되며 커리큘럼 방식의 설계를 따른다.
- Stage I: \(\mathcal{L}_\textrm{cot} + 0.1 \mathcal{L}_\textrm{vis} + \mathcal{L}_\textrm{act-dis}\)
- Stage II: \(\mathcal{L}_\textrm{cot}\)를 점진적으로 0으로 어닐링. 마지막에 \(0.2 \mathcal{L}_\textrm{vis} + \mathcal{L}_\textrm{act-dis}\)으로 최적화
- Stage III: Continuous한 action supervision으로 변경. \(\mathcal{L}_\textrm{act-dis}\)를 \(\mathcal{L}_\textrm{act-con}\)으로 대체
Experiments
1. Simulation Experiments
다음은 LIBERO에서 SOTA 방법들과 비교한 결과이다.
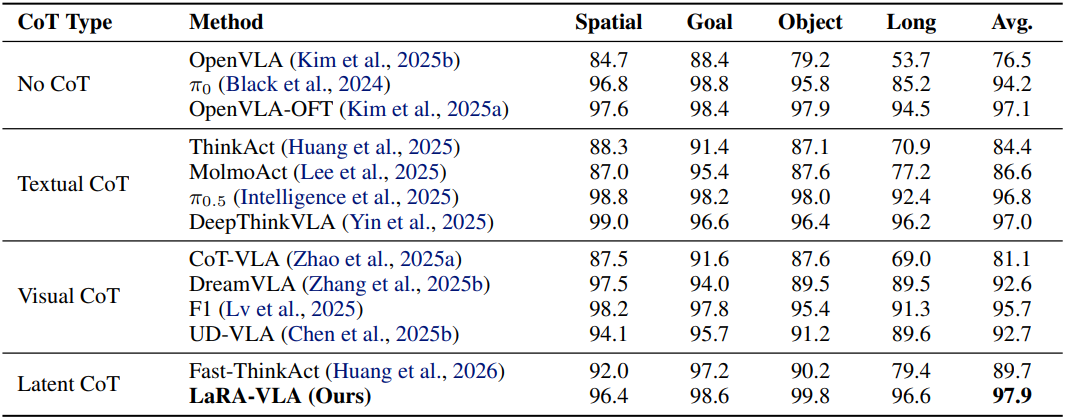
다음은 SimplerEnv-WindowX에서 SOTA 방법들과 비교한 결과이다.
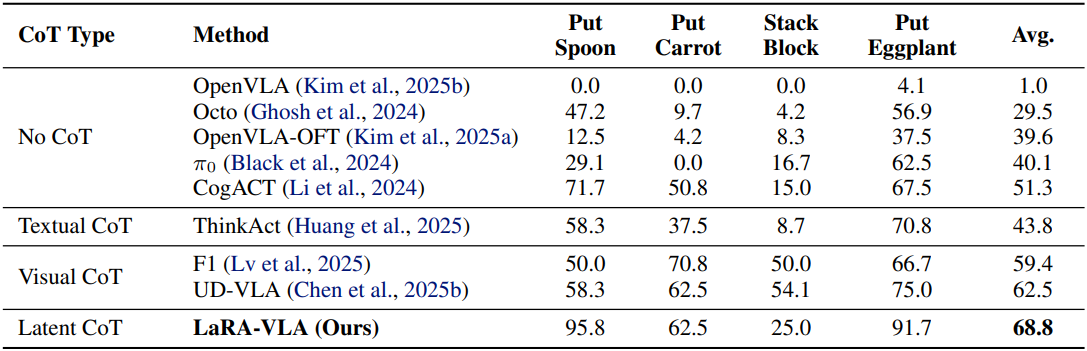
2. Real-World Experiments
다음은 4가지 long-horizon task에 대한 real-world 실험 결과이다.
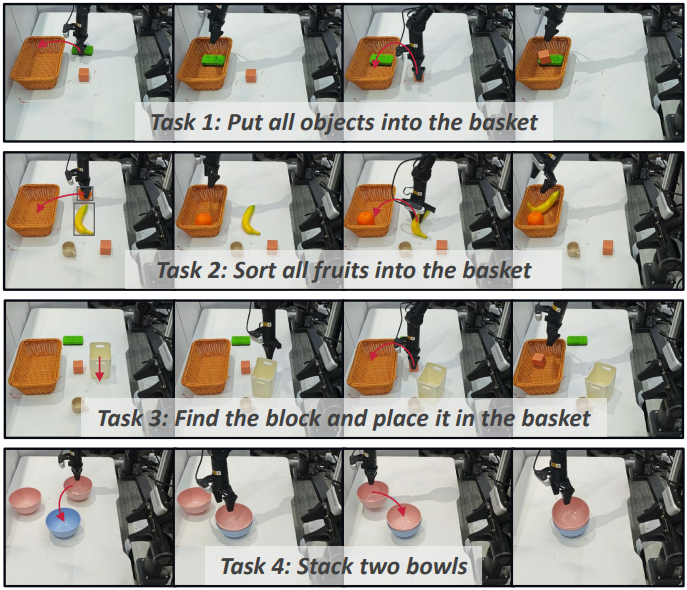
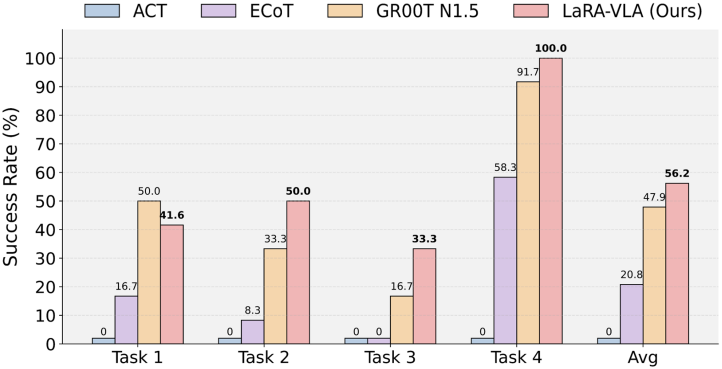
3. Analysis
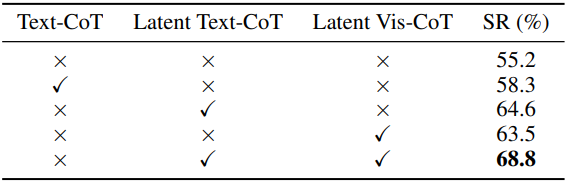
다음은 다양한 형태의 CoT supervision에 대한 ablation 결과이다.
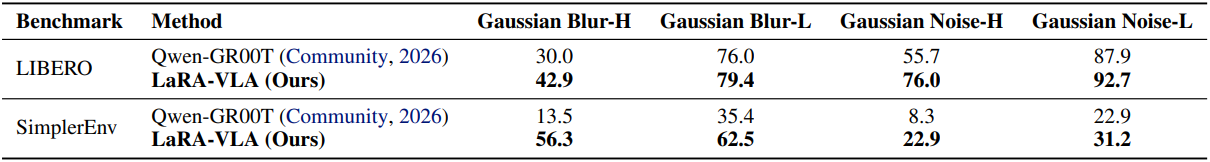
다음은 visual perturbation에 대한 (위) task 성공률과 (아래) latent space 분포이다.
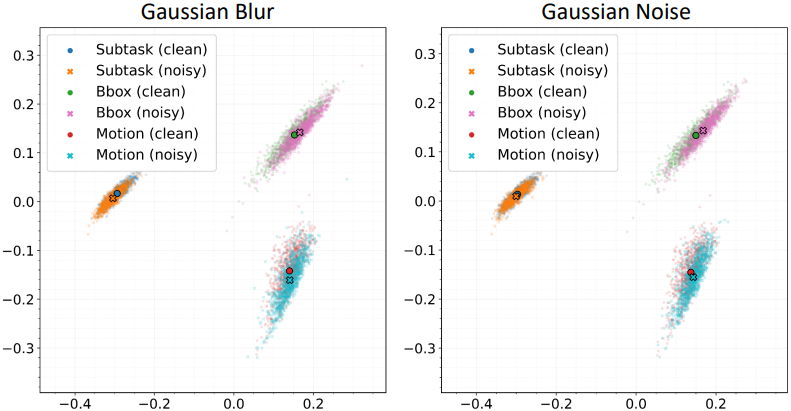
다음은 각 추론 성분에 연관된 latent 토큰을 나타낸 것이다.
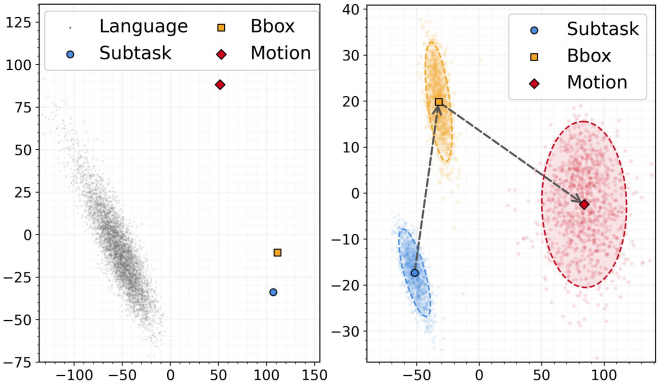
서로 다른 추론 성분과 연관된 latent들은 잘 분리되어 있고 일관된 군집을 형성한다. 이는 각 latent가 명확히 기능적으로 분화했음을 보여준다. 또한 CoT latent가 단순히 언어 임베딩을 그대로 재활용하는 것이 아님을 보여준다.
다음은 inference 속도를 비교한 결과이다.