[논문리뷰] VoMP: Predicting Volumetric Mechanical Property Fields
ICLR 2026. [Paper] [Page] [Github]
Rishit Dagli, Donglai Xiang, Vismay Modi, Charles Loop, Clement Fuji Tsang, Anka He Chen, Anita Hu, Gavriel State, David I.W. Levin, Maria Shugrina
NVIDIA | University of Toronto
27 Oct 2025
Introduction
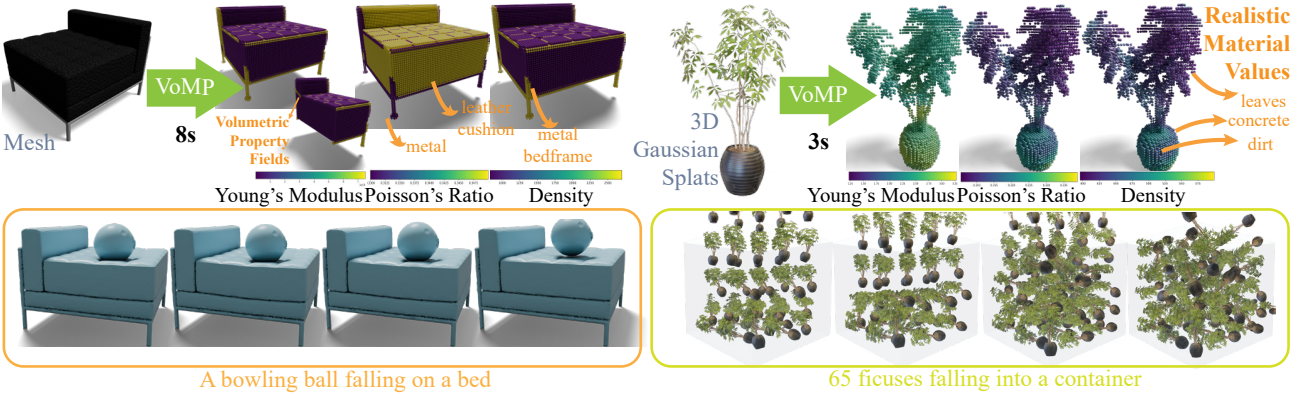
본 논문에서는 3D object의 부피 내에서 시뮬레이션에 바로 적용 가능한 mechanical property field $(E, \nu, \rho)$를 추정하도록 학습된 최초의 feed-forward 모델인 VoMP를 제안하였다. VoMP는 메쉬, Gaussian Splats, NeRF, SDF 등 voxelization 및 회전 뷰 렌더링이 가능한 모든 geometry에 적용 가능하다. VoMP는 완전한 feed-forward 방식으로 작동하며, object별 feature field 최적화나 VLM의 런타임 집계가 필요하지 않다. 특히 VoMP는 실제 측정값과 같은 정확한 mechanical property를 출력한다는 점에서 차별화된다. 또한 VoMP의 결과는 모든 시뮬레이터와 직접 호환되며, 시뮬레이션 정확도에 매우 중요한 object volume 전체에 material을 할당하도록 설계되었다.
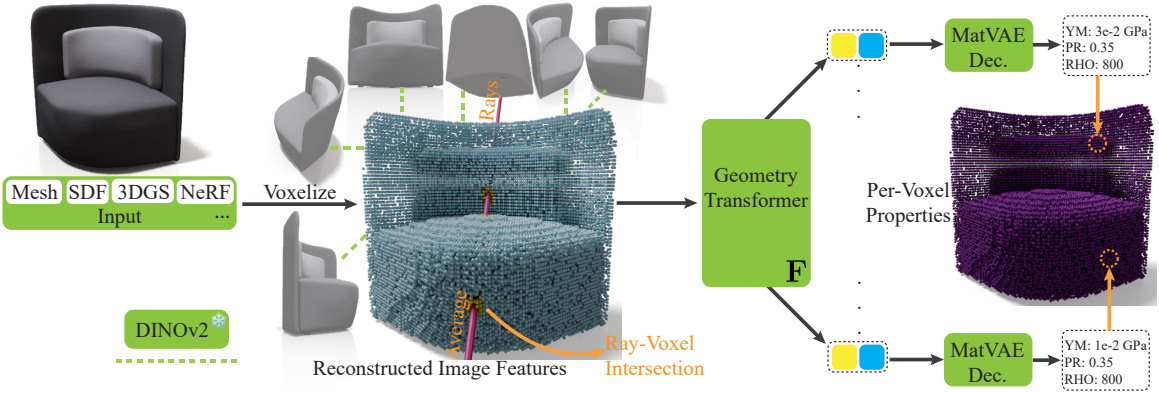
물리적으로 유효한 mechanical property 학습을 가능하게 하기 위해, 먼저 MatVAE를 사용하여 실제 값 $(E, \nu, \rho)$ 데이터베이스에 대한 latent space를 학습시킨다. 3D object의 mechanical property field를 예측하기 위해, 먼저 입력 geometry를 voxelize하고 voxel 전체에 걸쳐 멀티뷰 이미지 feature를 집계한다. 이 과정은 다양한 표현을 허용하며 빠르다. Voxel feature는 voxel별 material latent를 출력하도록 학습된 Geometry Transformer를 통과한다. MatVAE latent space는 object의 material 할당 학습과 유효한 material 학습을 분리하여, interpolation이 필요한 경우에도 MatVAE로 디코딩된 최종 property $(E, \nu, \rho)$이 물리적으로 유효하도록 보장한다.
Mechanical Properties Latent Space
유효한 Young’s modulus $E$, 푸아송 비(Poisson’s ratio $\nu$, 밀도 $\rho$의 triplet $(E, \nu, \rho)$으로 구성된 latent space를 학습시키기 위해, 본 논문에서는 실제 값 데이터셋 \(\{m_i := (E_i, \nu_i, \rho_i)\}\)으로 학습된 VAE인 MatVAE를 제안하였다. 이 모델의 목표는 이러한 triplet $m$을 2D latent space $z \in \mathbb{R}^2$로 매핑하여, 해당 공간에서 원래의 material property를 정확하게 복원할 수 있도록 하는 것이다. 비록 차원 축소의 폭은 크지 않지만, 이 2D latent space는 시각화, 샘플링, interpolation이 용이하며, 단위가 서로 다른 material 간의 거리를 일관되게 표현할 수 있게 해준다. MatVAE는 일종의 continuous tokenizer 역할을 하여, VoMP의 출력 material property가 항상 실제 존재하는 특정 material들의 범위 내에 속하도록 보장한다.
Loss의 reconstruction 요소는 입력값 $(E_i, \nu_i, \rho_i)$과 재구성된 material 값 \((\hat{E}_i, \hat{\nu}_i, \hat{\rho}_i)\) 간의 MSE로 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{Recon} = \frac{1}{N} \sum_{i=1}^N \| ((E_i, \nu_i, \rho_i)^N)^\top - ((\hat{E}_i, \hat{\nu}_i, \hat{\rho}_i)^N)^\top \|_2^2 \end{equation}\]여기서 \((\cdot)^N\)은 per-property normalization이다. $E$와 $\rho$는 먼저 log-transform \(\log_{10} (E)\), \(\log_{10}(\rho)\)을 거친 후 $[0, 1]$로 정규화되며, $ν$는 바로 $[0, 1]$로 정규화된다. 다른 정규화 방식을 사용할 경우, 학습에 불리한 조건인 heavy-tailed 형태의 feature 분포가 형성된다.
저자들은 표준 VAE를 기반으로 몇 가지 수정을 가했다.
- 단순한 Gaussian 분포를 넘어선 복잡한 posterior를 포착하기 위해 인코더의 출력을 Normalizing Flow로 변환했다. 이는 더 유연한 \(q_\phi (z \vert m)\)를 얻기 위함이다.
- $\beta$-TCVAE를 따라 ELBO의 KL-divergence 항을 분해했다. 이를 통해 총 Total Correlation $\textrm{TC}(z)$에 직접적으로 페널티를 부여할 수 있게 되었다. 이를 통해, MatVAE가 밀도 정보를 두 차원 모두에 인코딩하게 만들었던 latent 좌표 간의 높은 의존성을 줄일 수 있다.
- latent space가 특정 속성 하나로 붕괴하는 것을 막고 두 개의 latent 차원이 활발히 활용되도록 보장하기 위해, capacity constraint \(\delta \times z_\textrm{dim}\)을 도입하였다.
최종 loss는 다음과 같다.
\[\begin{equation} \mathcal{L}_\textrm{MatVAE} = \underbrace{\mathcal{L}_\textrm{Recon}}_{\textrm{MSE}} + \overbrace{\underbrace{\gamma \cdot \textrm{MI}(z)}_{\textrm{Mutual Information}} + \underbrace{\beta \cdot \textrm{TC}(z)}_{\textrm{Total Correlation}}}^{\textrm{Latent Space Regularization}} + \alpha \cdot \sum_{j=1}^2 \underbrace{\max \left(\delta, \textrm{KL} (q_\phi (z_j) \, \| \, p(z_j)) \right)}_{\textrm{Dimension-wise KL}} \end{equation}\]($\gamma = 1.0$, $\beta = 2.0$, $\alpha = 1.0$, $\delta = 0.1$)
Predicting Mechanical Property Fields
1. Aggregating Features
VoMP는 voxelization이 가능하고 여러 시점에서 렌더링할 수 있는 모든 형태의 3D 표현을 입력으로 수용한다. 다양한 3D 시점에 걸쳐 풍부한 DINOv2 이미지 feature를 계산한다. 그런 다음, 카메라 파라미터를 사용하여 각 voxel의 중심을 모든 시점으로 projection함으로써 해당 위치의 이미지 feature를 추출하고, 이를 3D 공간으로 lifting한다. 추출된 이미지 feature들은 평균화되어 각 voxel에 대한 feature는로 변환된다. 단순히 object의 표면뿐만 아니라 내부까지 voxelize하여 처리하며, 이를 통해 object 내부의 material property를 학습하고 예측할 수 있다.
크기가 $N^3$인 3D 그리드 내의 모든 활성 voxel 중심 위치를 \(\{\textbf{p}_i\}_{i=1}^L\), 렌더링 시점 $j$에 대한 카메라 projection 함수를 \(\Pi_j : \mathbb{R}^3 \rightarrow [-1, 1]^2\)라고 하자. DINOv2 patch-token map을 \(T_j \in \mathbb{R}^{1024 \times n \times n}\)라 하고, 이를 bilinear sampling하여 feature map \(F_j : [-1, 1]^2 \rightarrow \mathbb{R}^{1024}\)를 얻는다고 가정하자. 그러면 각 voxel \(i \in \{1, 2, \ldots, L\}\)에 대해 다음과 같이 feature $f_i$를 얻게 된다.
\[\begin{equation} \textbf{f}_i = \textrm{Average} (\mathcal{C}_i = \{ \mathcal{F}_j (\Pi_j (\textbf{p}_i)) \mid j \in J \}) \in \mathbb{R}^{1024} \end{equation}\]이는 멀티뷰 정보를 object 내부의 voxel로 전파하여 유용한 정보를 인코딩하며, 모델은 내부 material 구성을 예측하기 위해 이 정보를 처리하는 법을 학습한다.
2. Geometry Transformer
VoMP의 핵심 구성 요소는 voxelize된 이미지 feature를 학습된 material latent 표현으로 매핑하는 Transformer $\textbf{F}$이다. 모델의 backbone은 TRELLIS의 인코더/디코더 구조를 따르며, 해당 layer들은 TRELLIS의 가중치로 초기화된다.
인코더는 위치와 feature의 쌍 \(\textbf{X} = \{(\textbf{p}_i, \textbf{f}_i)\}_{i=1}^L\)로 표현되는 가변 길이의 활성 voxel 집합을 처리한다. 이 데이터를 Transformer에 적합한 형태로 만들기 위해, 먼저 voxel feature를 시퀀스 형태로 나열한 다음, 각 voxel의 3D 좌표에서 유도된 sinusoidal positional encoding을 추가하여 공간 정보를 부여한다. TRELLIS와 마찬가지로 3D shifted window attention 메커니즘을 채택한다.
TRELLIS와 달리 다양한 크기의 에셋을 처리하기 위해 최대 시퀀스 길이 $L_N$을 설정한다. Voxel 개수 $L$이 $L_N$ 이하인 에셋의 경우 전체 집합을 사용한다. 반면 $L > L_N$인 에셋의 경우 확률적 샘플링 전략을 사용하여, 각 학습 epoch 시작 시 $L_N$개의 voxel로 구성된 랜덤 부분 집합을 선택한다. 이러한 동적 resampling을 통해 모델은 에셋의 다양한 부분을 학습하게 되며, 결과적으로 더 많은 수의 유효 최대 voxel을 처리하는 효과를 얻게 된다.
각 학습 에셋에 대해, 먼저 현재 iteration에서 처리할 voxel 인덱스들의 집합을 $\mathcal{S}$로 정의한다. Voxel feature로부터 얻은 이미지 feature 시퀀스 \(\textbf{X}_\mathcal{S}\)를 Transformer $\textbf{F}$에 입력한다. 그 결과로 생성된 latent 표현은 사전 학습된 MatVAE의 고정된 디코더로 전달되어 material 속성을 예측한다. MatVAE는 $L$회, 즉 voxel당 한 번씩 실행되며, 이를 통해 각 voxel에 대한 material triplet $(E, \nu, \rho)$을 얻는다. 예측된 material과 GT material 간의 MSE를 사용하여 이 Transformer를 학습시키는데, 이때 MSE는 집합 $\mathcal{S}$ 내의 모든 voxel에 대해 평균을 낸 값이다.
\[\begin{equation} \mathcal{L}_\textbf{F} = \frac{1}{\vert \mathcal{S} \vert} \sum_{i \in \mathcal{S}} \| \mu_\theta (\textbf{F} (\textbf{X}_\mathcal{S})_i) - ((E, \nu_i, \rho_i)^N)^\top \|_2^2 \end{equation}\]Voxel 재료를 원래의 표현 방식으로 변환하기 위해, nearest neighbour interpolation을 사용한다. Voxel별 latent 벡터는 MatVAE의 디코더 모델로 전달되며, 이를 통해 voxel별 material triplet이 산출된다.
Training Data Generation
1. Material Triplets Dataset (MTD)
MatVAE를 학습시키기 위해, 저자들은 실제 material에 대한 100,562개의 triplet $(E, \nu, \rho)$을 포함하는 Material Triplet Dataset (MTD)을 구축하였다. 먼저 MatWeb, Wikipedia, The Engineering Toolbox 등 여러 온라인 데이터베이스에서 실험적으로 측정된 material property 데이터셋을 수집하였다. 이 데이터셋은 모든 material의 세 가지 property 모두에 대해 유효한 범위를 포함하는 값들로 구성된다. 각 material에 대해 해당 범위의 크기에 비례하는 수만큼의 triplet을 샘플링한다. 마지막으로, 일부 material에서 범위가 중복되어 발생하는 중복 데이터를 제거한다.
2. Geometry WITH Volumetric Materials (GVM) Dataset
Geometry Transformer를 학습시키기 위해, 저자들은 자동 annotation 파이프라인을 개발했다. 사전 학습된 VLM을 활용하되, 3D 데이터셋과 MTD에 포함된 추가 지식을 도입함으로써 VLM의 한계를 극복했다. 저자들은 다양한 NVIDIA 상업용 에셋에서 고품질 3D 메쉬를 수집했다. 이 데이터셋은 총 8,089개의 part로 구성된 1,624개의 3D 모델을 포함하며, 각 part는 하나의 material을 가진 것으로 간주된다. 각 part는 material 명칭과 사실적인 PBR 텍스처를 포함하고 있어, 이를 VLM에 대한 추가적인 단서로 활용할 수 있다.
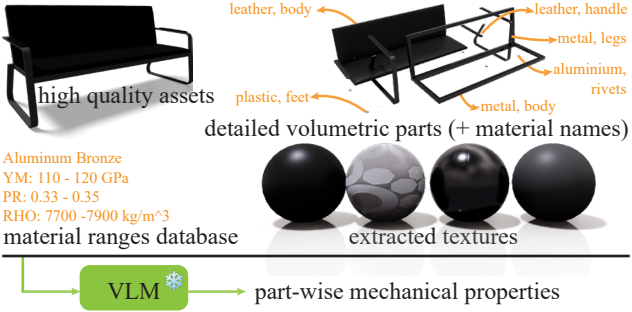
각 object의 개별 part에 대해 저자들은 다음과 같은 정보를 VLM에 입력하였다.
- Object 렌더링 이미지
- 구에 매핑된 material 렌더링
- Material 명칭
- Material 명칭을 기반으로 MTD에서 찾은 가장 유사한 실제 material 3가지의 범위 정보
그러면 VLM은 각 part에 대한 material triplet을 출력하고, 이를 해당 part 내부의 모든 voxel에 매핑한다. 그 결과 총 3,700만 개의 voxel에 $(E, \nu, \rho)$ 값이 annotation된다. 실제 material 값과 추가적인 단서로 VLM을 유도함으로써, 부정확하거나 비현실적인 material 값이 생성되는 것을 방지하였다.
Experiments
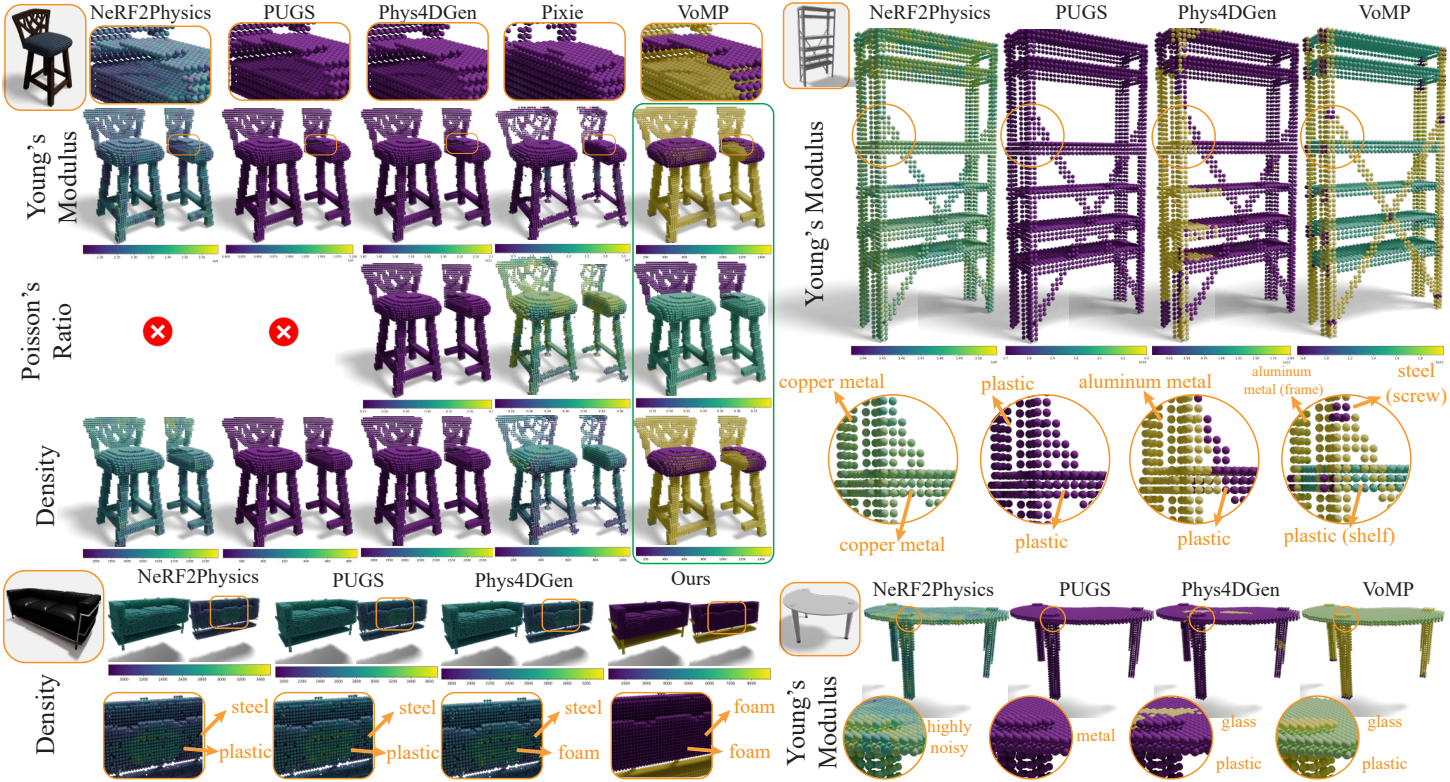
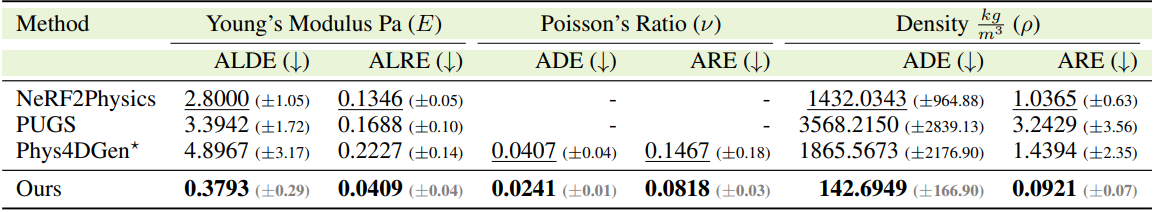
다음은 mechanical property 추정 결과이다.
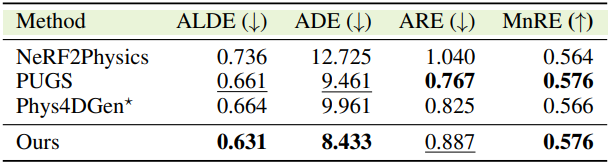
다음은 질량 추정 결과이다. (ABO-500)
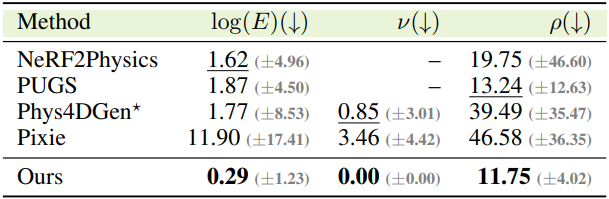
다음은 MTD에서 가장 가까운 material과의 상대 오차(%)로 material의 유효성을 측정한 결과이다.
다음은 실제 material들을 MatVAE로 인코딩한 결과이다.
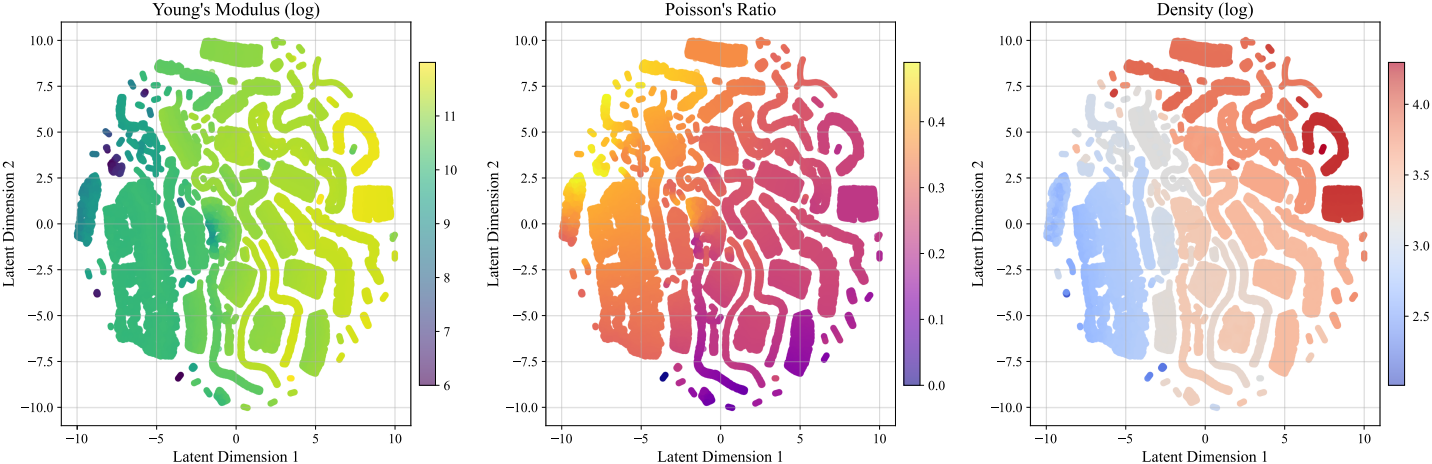
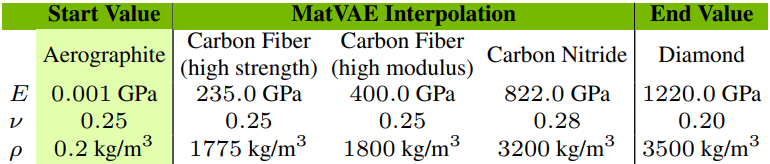
다음은 latent space에서 interpolation한 예시이다.