[논문리뷰] ChronoEdit: Towards Temporal Reasoning for Image Editing and World Simulation
ICLR 2026. [Paper] [Page] [Github]
Jay Zhangjie Wu, Xuanchi Ren, Tianchang Shen, Tianshi Cao, Kai He, Yifan Lu, Ruiyuan Gao, Enze Xie, Shiyi Lan, Jose M. Alvarez, Jun Gao, Sanja Fidler, Zian Wang, Huan Ling
NVIDIA | University of Toronto
5 Oct 2025
Introduction
최근 대규모 동영상 생성 모델은 연속된 프레임 간에 object의 구조와 일관성을 유지하는 뛰어난 능력을 보여주었다. 내재된 시간적 prior는 물리적 일관성이 요구되는 이미지 편집에 이 모델들을 특히 적합하게 만든다. 이러한 통찰을 바탕으로, 본 논문에서는 물리적 일관성을 유지하도록 명시적으로 설계된 이미지 편집용 foundation model인 ChronoEdit을 제안하였다.
ChronoEdit은 입력 이미지와 편집된 이미지를 연속된 프레임으로 모델링하여 이미지 편집을 2-프레임 동영상 생성 문제로 재구성함으로써, 사전 학습된 동영상 생성 모델을 편집 용도로 활용한다. 엄선된 이미지 편집 데이터로 fine-tuning을 거치면, 이러한 2-프레임 방식은 동영상 모델에 편집 기능을 부여하는 동시에 사전 학습된 시간적 prior를 활용하여 object의 충실도를 유지할 수 있게 한다.
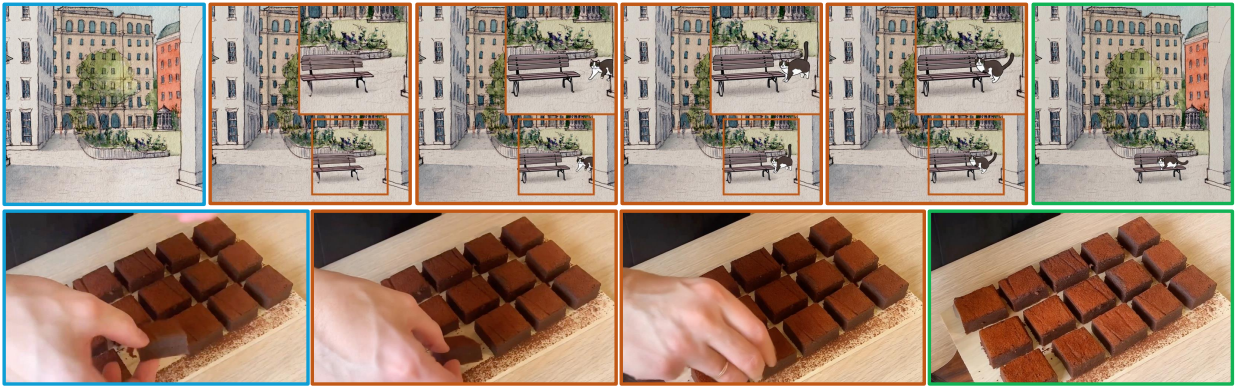
더 강력한 시간적 일관성이 요구되는 월드 시뮬레이션을 위해, 본 논문은 시간적 추론을 통한 명시적인 가이드 기반 편집 방식을 추가로 도입하였다. 입력 이미지와 편집 instruction이 주어지면, 모델은 입력 프레임과의 시간적 정렬을 유지하면서 해당 편집을 구현하는 짧은 동영상 궤적을 상상하고 denoising한다. 이 궤적 내의 중간 동영상 프레임들은 추론 토큰 역할을 하여 편집이 어떻게 전개될지 계획하고, 이를 통해 물리적으로 더 타당한 결과를 생성한다.
이러한 중간 프레임을 시뮬레이션하는 것은 결과의 타당성을 높일 뿐만 아니라 편집 모델의 ‘사고 과정’을 드러내어, 편집이 어떻게 구성되는지에 대해 더 높은 해석 가능성을 제공한다. 이러한 이점과 효율성 사이의 균형을 맞추기 위해, ChronoEdit은 noise level이 높은 초기 몇 denoising step에서만 시간적 추론을 수행한다. 해당 step이 지나면 중간 프레임들은 폐기되고, 궤적의 최종 프레임만이 정교화되어 최종 편집 이미지로 완성된다.
Method
1. Re-purposing Video Generative Models for Editing
이미지 편집 task는 레퍼런스 이미지 $\textbf{c}$를 자연어 instruction $\textbf{y}$를 충족하는 출력 이미지 $\textbf{p}$로 변환하는 것을 목표로 한다. 본 논문의 핵심 통찰은 사전 학습된 image-to-video 모델을 재활용하여 모델이 지닌 시간적 prior를 활용하는 것이다.
편집 쌍 인코딩
사전 학습된 동영상 모델의 시간적 prior를 활용하기 위해, 편집 쌍 \(\{\textbf{c}, \textbf{p}\}\)를 짧은 동영상 시퀀스로 재해석한다. 구체적으로, 입력 이미지 $\textbf{c}$는 첫 번째 latent 프레임으로 인코딩되는 반면, 출력 이미지 $\textbf{p}$는 video VAE의 4배 시간 압축 비율에 맞춰 4번 반복된 후 인코딩된다.
\[\begin{equation} \textbf{z}_\textbf{c} = \mathcal{E}(\textbf{c}), \quad \textbf{z}_\textbf{p} = \mathcal{E}(\textrm{repeat}(\textbf{p}, 4)) \end{equation}\]이를 통해 동영상 모델의 아키텍처와 정렬된 두 개의 시간적 latent가 생성된다. 또한, 입력 이미지 $\textbf{c}$를 timestep 0에, 출력 이미지 $\textbf{p}$를 timestep $T$에 고정함으로써 모델의 RoPE를 조정하고, 이들 간의 시간적 간격을 명시적으로 인코딩한다. 편의상 $\textbf{T}$는 공동 학습 video latent의 길이로 고정한다.
시간적 추론 토큰
단순한 입력-출력 매핑을 넘어, 입력 이미지 $\textbf{c}$와 출력 이미지 $\textbf{p}$ 간의 변화 과정을 명시적으로 모델링한다. 이 접근 방식의 목표는 급격한 변화를 초래하기 쉬운 single step 이미지 생성 대신, 모델이 그럴듯한 변화 경로를 상상하도록 유도하는 것이다. 중간 state를 거쳐 추론함으로써 모델은 object의 identity, geometry, 물리적 일관성을 더 잘 유지할 수 있다. 구체적으로는 \(\textbf{z}_\textbf{c}\)와 \(\textbf{z}_\textbf{p}\) 사이에 중간 latent 프레임들을 삽입한다. 이 프레임들은 초기에는 랜덤 noise로 설정되지만, 이후 출력 프레임의 latent들과 함께 공동으로 denoising process를 거친다. 이 프레임들은 모델이 그럴듯한 변화 과정을 생각하도록 돕는 중간 가이드 역할을 하기 때문에, 시간적 추론 토큰 $\textbf{r}$이라고 부른다.
이미지 쌍과 동영상의 통합
이미지 편집용 denoiser를 \(\textbf{F}_\theta (\textbf{z}_{\textbf{p},t}, t; \textbf{y}, \textbf{z}_\textbf{c})\)로 정의한다. 이렇게 정의하면 통합된 프레임워크 내에서 이미지 편집 쌍과 전체 동영상 시퀀스 모두를 활용한 학습을 자연스럽게 지원한다.
이미지 편집 데이터셋의 경우, 각 쌍 $(\textbf{c}, \textbf{p}, \textbf{y})$은 2프레임 동영상으로 해석된다. 이때 $\textbf{c}$는 첫 번째 프레임, $\textbf{p}$는 마지막 프레임이 되어 instruction 기반 편집을 직접적으로 학습시킨다. 동영상의 경우, 데이터 구조가 추론 토큰 설계와 일치한다. 즉, 첫 번째 프레임은 $\textbf{c}$에, 마지막 프레임은 $\textbf{p}$에 대응하며, 그 사이의 모든 프레임은 추론 토큰 역할을 한다.
입력 프레임과 추론 프레임은 video VAE에 의해 일반적인 동영상 프레임처럼 latent로 인코딩되는 반면, 타겟 프레임은 별도로 인코딩된 후 VAE의 시간 압축 비율에 맞춰 4번 반복된다. 이러한 설계 덕분에 추론 토큰은 inference 단계에서 선택 사항이 되며, 추론 토큰이 존재할 경우 일관된 변환을 위한 강력한 supervision을 제공한다.
동영상 데이터 큐레이션
추론 토큰을 활용한 학습에는 시간이 지남에 따라 장면이 어떻게 변화하는지를 보여주는 다양한 예시가 필요하다. 이를 위해, 저자들은 SOTA 동영상 생성 모델로 제작된 140만 개의 동영상으로 구성된 대규모 합성 데이터셋을 구축했다. 특히 장면의 역학과 카메라 움직임을 분리하는 데 중점을 두었는데, 이는 첫 번째 프레임과 마지막 프레임 사이에서 의도치 않은 시점 변화가 발생할 경우 학습 과정에서 이를 편집으로 오인할 수 있기 때문이다.
데이터셋은 상호 보완적인 세 가지 카테고리를 포괄한다.
- 고정 카메라, 동적 객체: Text-to-video 모델(Wan, Cosmos)로 생성된 동영상 클립이다. 프롬프트에 “The camera remains stationary throughout the video.”라는 문구를 추가하고 ViPE를 사용하여 불안정한 클립을 필터링했다.
- 1인칭 주행 장면: Cosmos-Drive-Dreams에 HDMap을 조건으로 생성한 동영상이다. 카메라를 고정하는 동시에 bounding box를 통해 차량의 움직임을 명시적으로 제어하는 중요한 월드 시뮬레이션 시나리오이다.
- 동적 카메라, 정적 장면: GEN3C로 생성한 동영상 클립이다. 장면의 내용은 고정된 상태에서 카메라의 궤적을 정밀하게 제어할 수 있다.
저자들은 instruction $\textbf{y}$를 생성하기 위해 VLM을 활용하여 각 동영상에 편집 instruction을 캡션으로 달았다. 이 instruction은 입력 프레임에서 출력 프레임으로의 변화 과정을 요약한다.
2. Inference with Temporal Reasoning
저자들은 inference 시에 효율적인 이미지 편집을 수행하기 위해, 완전한 동영상 생성에 필요한 모든 계산 비용을 들이지 않고도 동영상 추론 토큰을 활용할 수 있는 2단계 방법을 제안하였다. Diffusion 궤적의 처음 몇 step이 전체적인 구조를 결정하므로, 토큰은 시퀀스의 여러 프레임에 걸쳐 더 자주 attention된다. 따라서, 이러한 초기 denoising step에 동영상 추론 토큰을 포함시키고, 이후 denoising step에서는 토큰을 제외하여 품질과 계산 비용 사이의 최적의 균형을 얻는다.
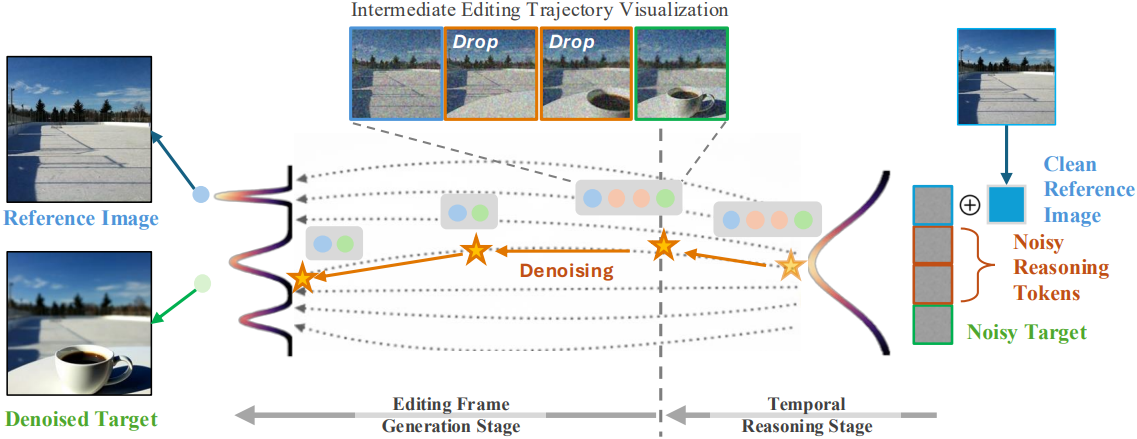
첫 번째 단계에서는 깨끗한 입력 토큰 \(\textbf{z}_\textbf{c}\), 샘플링된 추론 토큰 $\textbf{r}$, 그리고 noise가 포함된 샘플링된 출력 토큰 \(\textbf{z}_\textbf{p}\)를 하나의 시간 시퀀스로 concat한다. Image-to-video 생성과 유사하게, 모델은 \(\textbf{z}_\textbf{c}\) 토큰을 수정하지 않고 concat된 시퀀스에 대해 denoising을 수행한다. 깨끗한 latent 토큰이 나올 때까지 완전히 denoising하는 대신, $N_r$ step의 denoising을 수행하고, \(\textbf{z}_\textbf{p}\)에 해당하는 시간 시퀀스의 마지막 부분에서 부분적으로 denoise된 latent를 다음 step으로 전달힌다.
두 번째 단계에서는 부분적으로 denoise된 출력 latent를 깨끗한 입력 latent 뒤에 concat하고, 나머지 $N-N_r$ step 동안 완전히 denoising한다. 학습 시와 마찬가지로, 출력 latent는 video VAE의 시간 압축에 맞춰 4개의 반복 프레임에 해당한다. RGB로 디코딩하면 4개의 프레임은 일반적으로 동일한 이미지로 합쳐지며, 마지막 프레임을 최종 편집 결과로 사용한다.
3. Few-Step Distillation for Fast Inference
저자들은 inference 속도를 더욱 높이기 위해, inference에 필요한 step 수를 줄이는 distillation 기법을 사용했다. 구체적으로, DMD loss를 이용하여 8-step student 모델을 학습시켰다. Distillation loss의 gradient는 다음과 같다.
\[\begin{equation} \nabla \mathcal{L}_\textrm{DMD} = - \mathbb{E}_t \left( \left( s_\textrm{real} (f (\textbf{F}_\theta, t), t) - s_\textrm{fake} (f (\textbf{F}_\theta, t), t) \right) \frac{d \textbf{F}_\theta}{d \theta} dz \right) \end{equation}\](\(s_\textrm{real}\)과 \(s_\textrm{fake}\)는 각각 teacher 모델과 student 모델의 score 추정치, $f(\cdot)$는 forward diffusion, 컨디셔닝 생략)
이러한 학습 과정을 통해, 본 모델은 프롬프트 준수 능력과 이미지 편집 품질을 유지하면서도 inference 속도를 획기적으로 향상시킬 수 있다.
Experiments
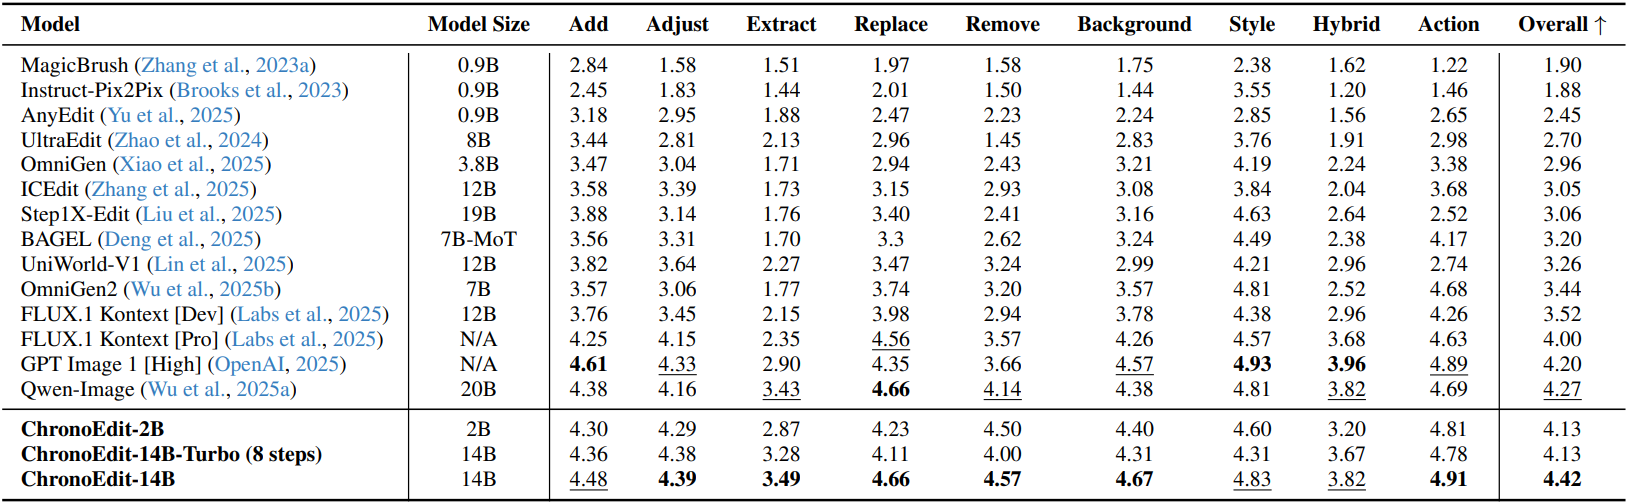
다음은 ImgEdit Basic-Edit Suite에 대한 비교 결과이다.
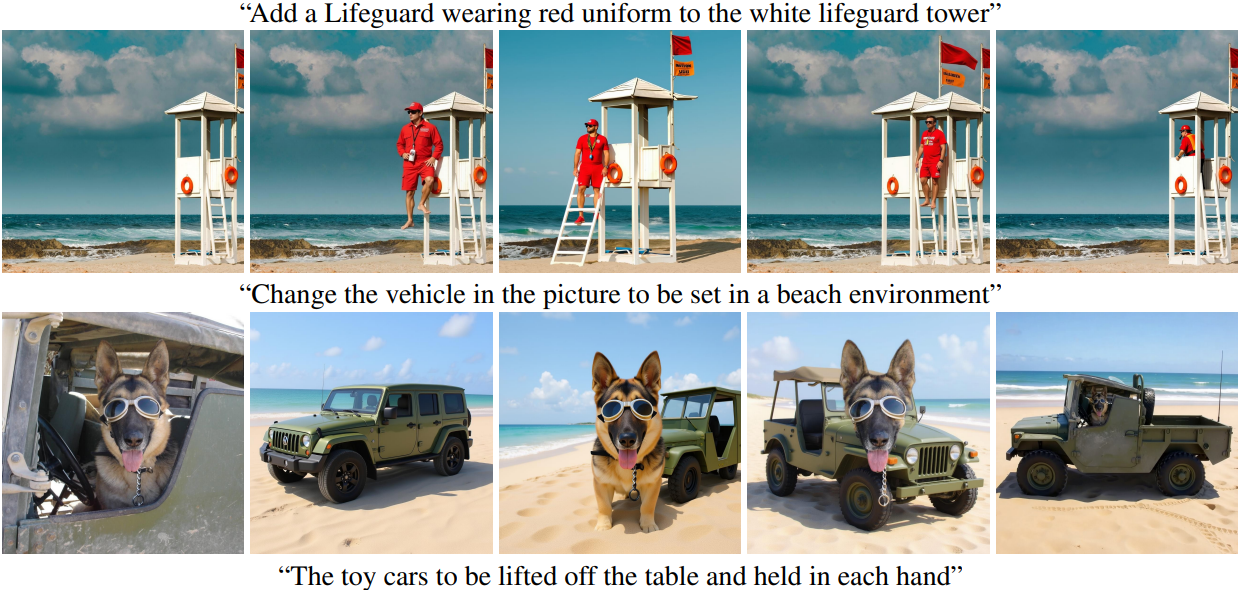
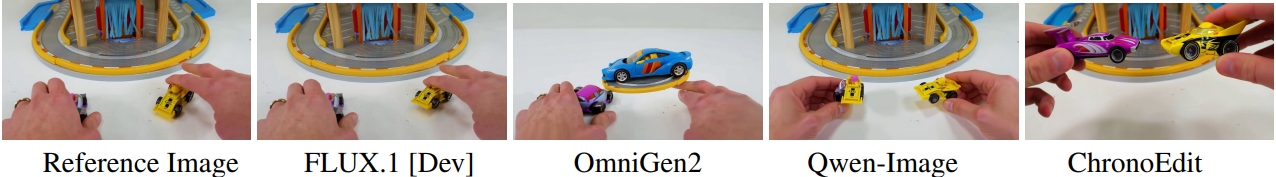
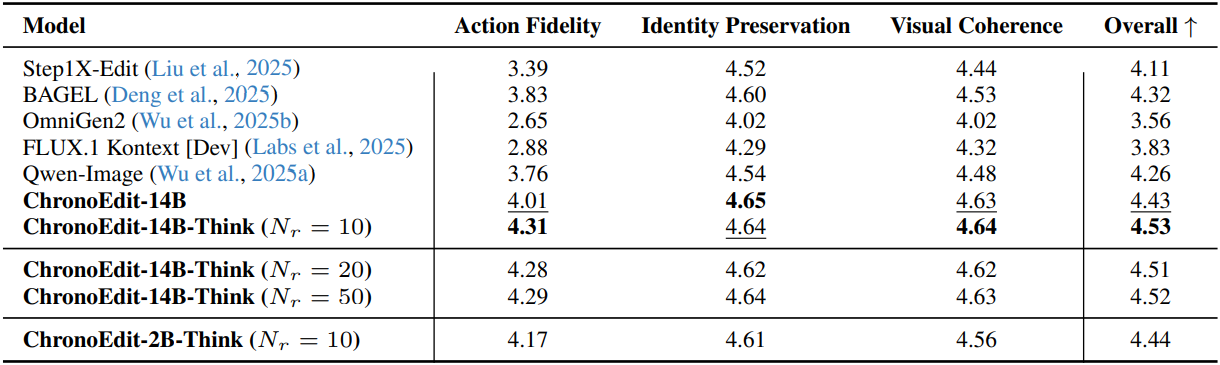
다음은 PBench-Edit에 대한 비교 결과이다. (GPT-4.1이 평가)
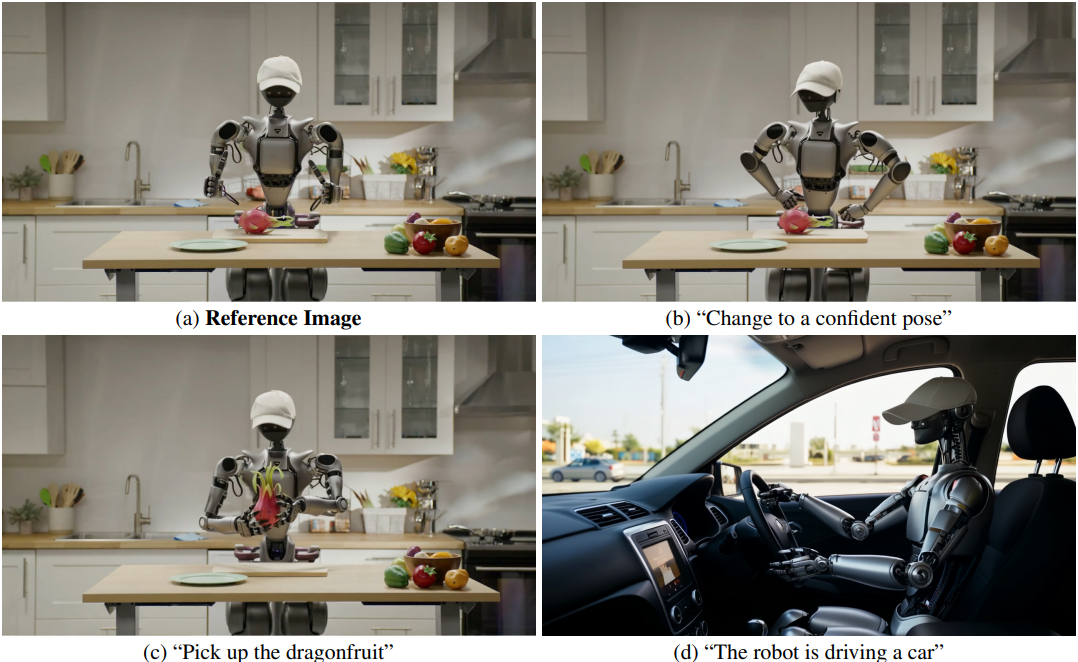
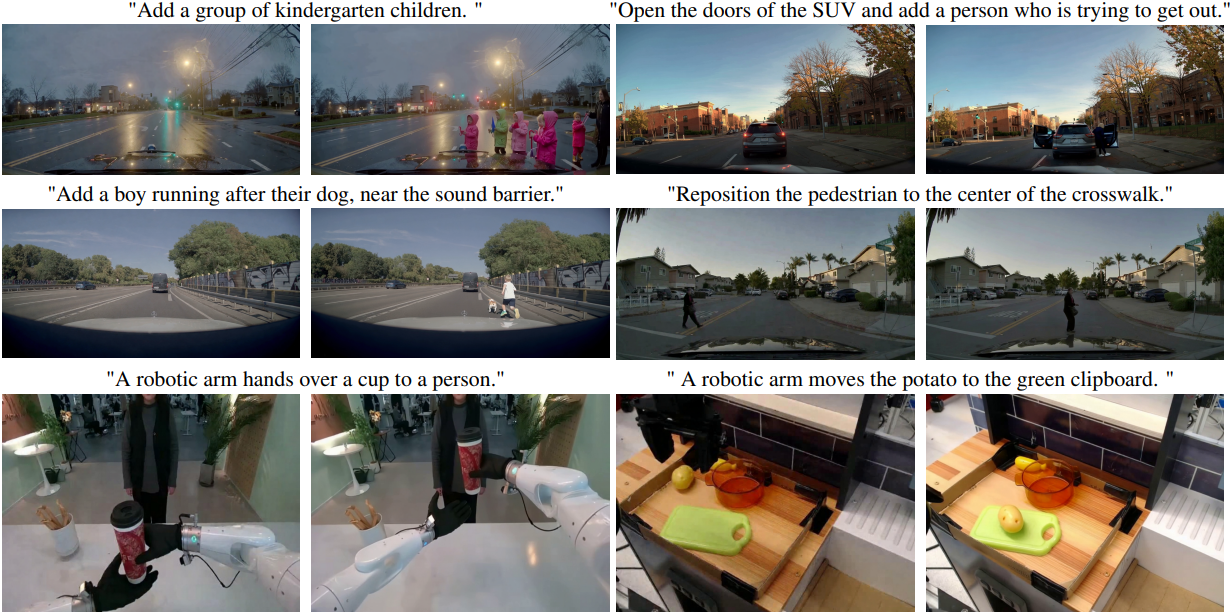
다음은 다양한 피지컬 AI 월드 시뮬레이션 task에 대해 ChronoEdit-14B-Think로 생성한 결과들이다.
다음은 중간 추론 프레임을 디코딩하여 시간적 추론 궤적을 시각화한 것이다.
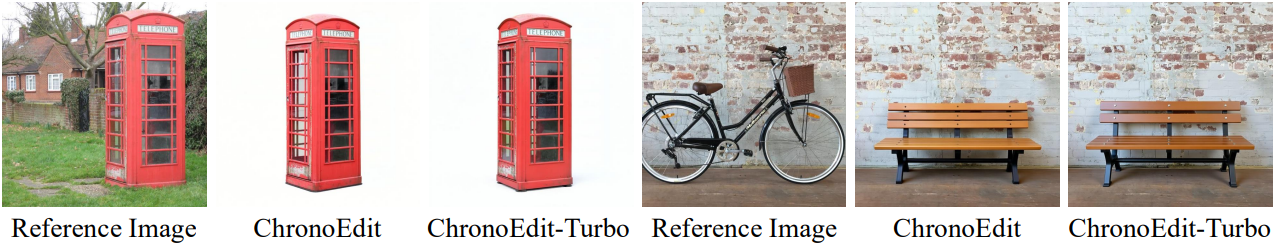
다음은 ChronoEdit-Turbo로 생성한 결과들이다.
다음은 동영상 추론 step $N$에 대한 ablation study 결과이다.