[논문리뷰] TokenGS: Decoupling 3D Gaussian Prediction from Pixels with Learnable Tokens
CVPR 2026. [Paper] [Page] [Github]
Jiawei Ren, Michal Jan Tyszkiewicz, Jiahui Huang, Zan Gojcic
NVIDIA
16 Apr 2026
Introduction
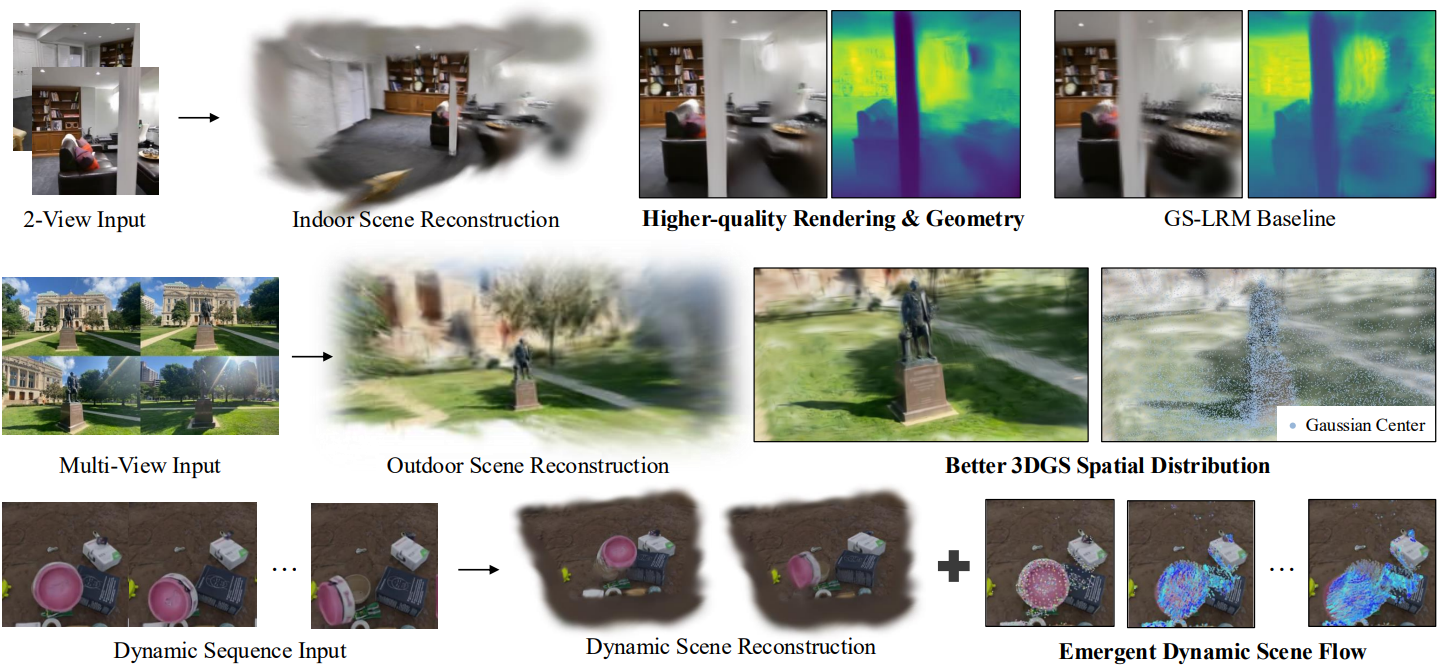
픽셀 단위로 정렬된 3D Gaussian primitive를 예측하기 위해 encoder-only Transformer backbone을 사용하는 기존 패러다임은 여전히 몇 가지 근본적인 한계에 직면해 있다.
- 카메라 광선을 따라 깊이로 Gaussian 평균을 예측하는 방식은 노이즈가 있는 카메라 포즈와 멀티뷰 불일치를 내부적으로 보정하는 모델의 능력을 제한하고, 시간이 지남에 따라 점/픽셀이 변형되는 동적 장면에서 어려움을 야기한다.
- 예측되는 Gaussian 개수를 해상도 및 이미지 개수에 연결하는 일반적인 전략은 과도한 수의 Gaussian을 생성한다. 이러한 연결로 인해 표현 규모는 장면의 내재적 복잡성과 관계없이 입력 뷰 개수에 비례하여 커진다.
- Feed-forward 재구성은 자연스럽게 self-supervision 기반의 test-time 개선을 가능하게 하지만, Gaussian 파라미터를 직접 최적화하는 것은 네트워크의 학습된 prior를 저하시키는 경향이 있다.
이러한 문제들을 해결하기 위해, 본 논문에서는 표준 공식을 재검토하고 몇 가지 핵심적인 수정 사항을 통합한 TokenGS를 제시하였다. 카메라 광선을 따라 깊이로 Gaussian 평균/중심을 예측하는 대신, 3D 좌표를 직접 예측한다. 이는 VGGT와 같은 feed-forward SfM 모델에서의 point map 예측과 유사하지만, 중요한 점은 명시적인 GT point map 없이 self-supervised 렌더링 loss만을 통해 학습된다는 것이다. 이를 통해 일반적으로 사용되는 encoder-only backbone을 새로운 encoder–decoder 아키텍처로 대체할 수 있으며, 이 아키텍처에서는 학습 가능한 3DGS 토큰들이 압축된 이미지 feature에 cross-attention하고 해당 3DGS 파라미터를 예측한다.
결과적으로, 예측된 Gaussian의 개수는 입력 해상도 및 이미지 개수와 무관한 hyperparameter가 된다. Gaussian 예측을 입력 이미지와 분리함으로써, TokenGS는 장면 복잡성이 높은 위치에 Gaussian을 자유롭게 할당할 수 있다. 이러한 접근 방식은 입력 뷰를 넘어 장면 완성을 가능하게 하고, 노이즈가 있는 카메라 입력에 대한 robustness를 향상시키며, 동적 콘텐츠로 자연스럽게 확장된다. 또한, 토큰 기반 공식은 토큰 임베딩만 개선함으로써 self-supervision 기반의 test-time 최적화를 지원하여 모델에 인코딩된 prior를 보존한다.
Method
입력 뷰 집합 \(\mathcal{I} = \{\textbf{I}_i \in \mathbb{R}^{H \times W \times 3}\}_{i=1}^N\)과 이에 대응하는 카메라 extrinsic \(\mathcal{T} = \{\textbf{T}_i \in \textrm{SE}(3)\}_{i=1}^N\), intrinsic이 주어졌을 때, 본 논문의 목표는 볼륨 렌더링을 통해 새로운 뷰를 합성할 수 있는 $M$개의 3D Gaussian 집합 \(\mathcal{G} \in \mathbb{R}^{M \times 14}\)를 직접 예측하는 것이다. 각 Gaussian은 평균 $\boldsymbol{\mu} \in \mathbb{R}^3$, 색상 $\textbf{c} \in [0, 1]^3$, scale \(\textbf{s} \in \mathbb{R}_{+}^3\), opacity $\sigma \in [0, 1]$, unit quaternion $\textbf{q} \in \mathbb{H}$로 표현되는 rotation으로 parameterize된다.
1. Directly Regressing Gaussian Means
카메라 광선을 따라 깊이를 예측하는 대신, 본 논문에서는 카메라 extrinsic에 의해 정의되고 모든 뷰에서 공유되는 글로벌 좌표계 내에서 Gaussian 평균 $\boldsymbol{\mu}$의 3D 좌표를 직접 예측한다.
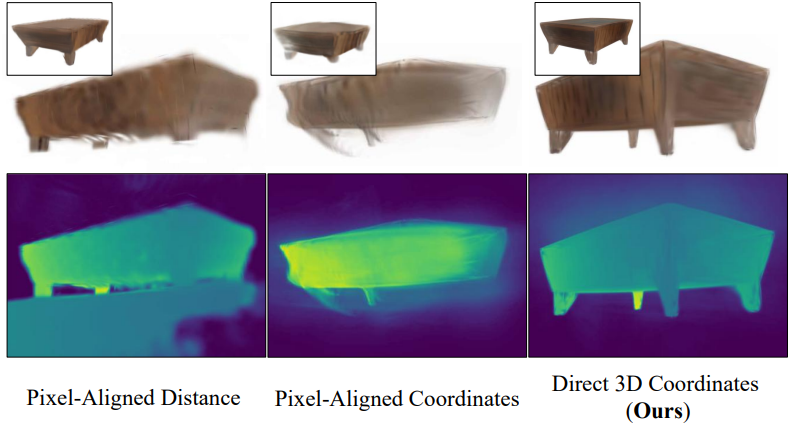
저자들은 그 효과를 입증하기 위해 Objaverse 데이터셋을 대상으로 예비 연구를 수행했다. 위 그림에서 볼 수 있듯이, 단일 뷰를 입력으로 사용할 경우 픽셀 정렬된 방식은 표현력이 제한적이어서 가려진 부분을 복원하지 못한다.
Gaussian 평균 예측을 카메라 광선으로부터 분리하면 다음과 같은 몇 가지 추가적인 이점이 있다.
- Extrapolation과 scene completion이 가능해진다.
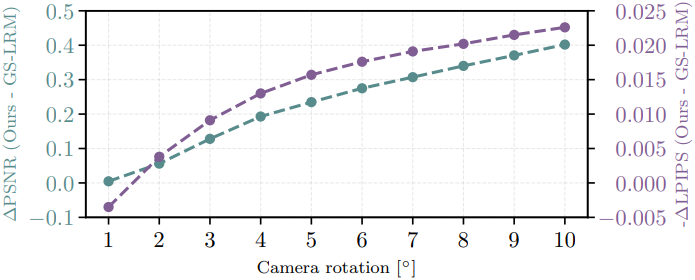
- 카메라 포즈의 노이즈에 대한 robustness가 향상된다.
- 깊이 예측 네트워크에서 흔히 나타나는 뾰족한 형태의 아티팩트가 제거된다.
Zero-Gradient 문제
직접 좌표를 예측하는 모델을 학습시키는 것은 결코 간단하지 않다. 모든 카메라 frustum 바깥에 있는 Gaussian은 렌더링된 이미지에 기여하지 않으므로 렌더링 loss로부터 0의 gradient를 받는다. 이러한 비활성 Gaussian은 학습 안정성을 저하시키고, 모델 용량을 낭비하며, 장면 주변에 떠다니는 노이즈로 나타난다.
최근의 feed-forward SfM 기법들은 GT depth map을 글로벌 좌표계로 변환하여 얻은 명시적인 3D supervision을 이용함으로써 이 문제를 완화하였다. 그러나 이러한 supervision은 실제 환경에서 획득하기 어렵거나 노이즈가 많으며, 예측된 평균값이 카메라 광선을 따라 위치하도록 강제하는 편향을 다시 초래한다.
Visibility Loss
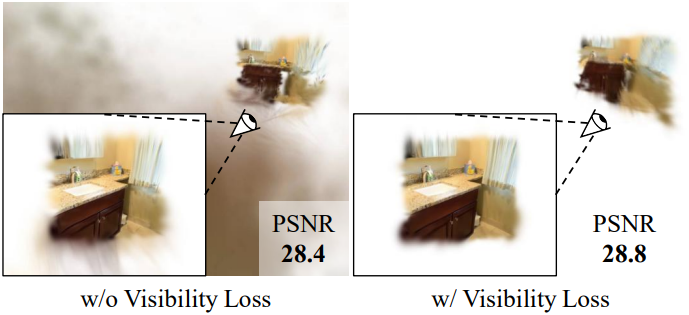
대신, 저자들은 Gaussian들이 적어도 하나의 학습 뷰에서 계속 보이도록 부드럽게 제약하는 visibility loss를 도입하였다. 구체적으로, Gaussian 중심 \(\boldsymbol{\mu}_m = (x_m, y_m, z_m)\)을 모든 학습 뷰 \(\textbf{I}_i\)의 이미지 평면에 projection하여 이미지 좌표 $(u_m^i, v_m^i)$를 구한다. $(u_m^i, v_m^i)$를 이미지 너비 $W$와 높이 $H$로 정규화했을 때, 이미지 평면 내부의 점들은 $\tilde{u}, \tilde{v} \in [-1, 1]$을 만족한다.
\[\begin{equation} \tilde{u}_m^i = 2 (u_m^i / W) - 1, \quad \tilde{v}_m^i = 2 (v_m^i / H) - 1 \end{equation}\]Visibility loss는 각 Gaussian에서 가장 가까운 visible boundary까지의 최소 거리를 측정한다.
\[\begin{equation} \mathcal{L}_\textrm{vis} = \sum_m \min_{\textbf{I}_i} \left[ \textrm{ReLU}(\vert \tilde{u}_m^i \vert - 1) + \textrm{ReLU}(\vert \tilde{v}_m^i \vert - 1) \right] \end{equation}\]Gaussian이 적어도 하나의 뷰 내부로 projection될 때 이 페널티는 0이 되며, 그렇지 않은 경우에는 이 Gaussian을 뷰 안으로 다시 끌어오기 위한 gradient를 제공한다. 실제 구현 시에는 불필요한 gradient가 발생하는 것을 방지하기 위해 loss 값을 상수 1.0으로 clipping한다.
새롭게 제안된 visibility loss 외에도, 픽셀 단위 MSE와 SSIM loss를 결합하여 렌더링 결과에 대한 학습을 수행한다.
\[\begin{equation} \mathcal{L} = \mathcal{L}_\textrm{MSE} + \lambda_\textrm{SSIM} \mathcal{L}_\textrm{SSIM} + \lambda_\textrm{vis} \mathcal{L}_\textrm{vis}. \end{equation}\](\(\lambda_\textrm{SSIM} = 0.2\), \(\lambda_\textrm{vis} = 1.0\))
2. Decoding Learnable Gaussian Tokens
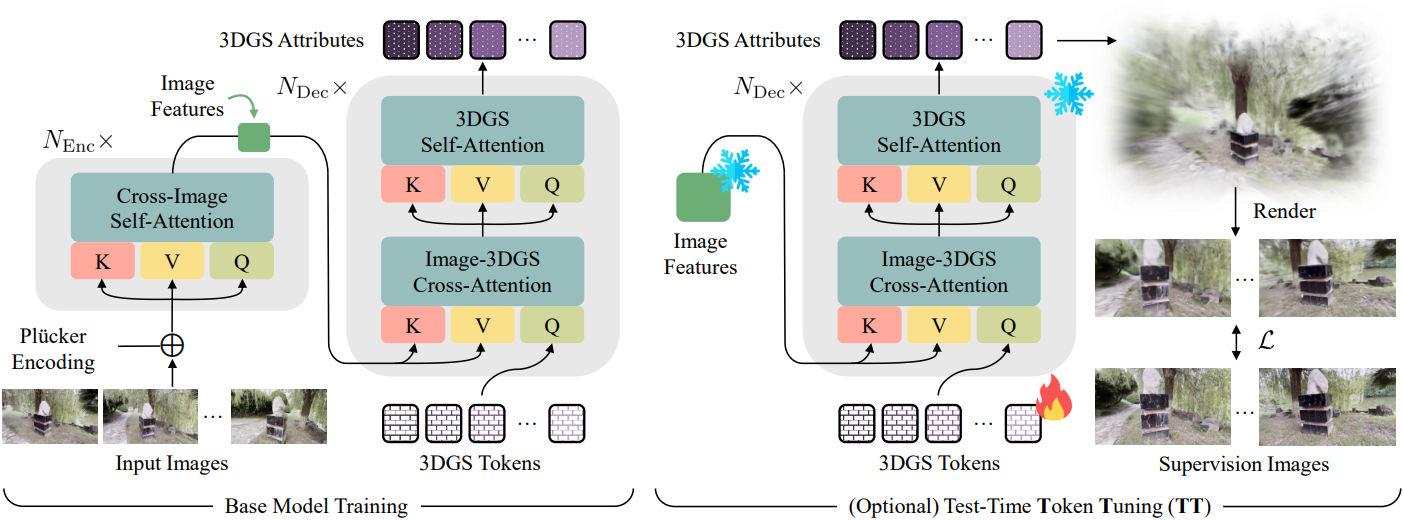
본 논문에서는 encoder-decoder Transformer를 사용한다. 인코더는 입력 이미지와 카메라 파라미터를 이미지 토큰으로 변환하고, 디코더는 cross-attention을 통해 학습 가능한 Gaussian 토큰 세트를 예측한다. 각 Gaussian 토큰은 입력 픽셀 수와 독립적으로 디코딩되므로, 출력 Gaussian 개수가 이미지 해상도와 효과적으로 분리된다.
Model Architecture
ViT 기반 인코더를 사용한다. 구체적으로, 각 입력 뷰 \(\{\textbf{I}_v \in \mathcal{I}_c\}_{v=1}^{N_c}\)은 먼저 패치 집합 \(\{\textbf{I}_{vk} \in \mathbb{R}^{p \times p \times 3}\}_{k=1}^{HW/p^2}\)로 patchify되어 총 \(N_\textbf{I} = N_c HW/p^2\)개의 패치가 생성된다. 이 패치들은 linear layer를 사용하여 $C$차원으로 projection된다. 동시에, 각 뷰와 관련된 플러커 좌표는 패치 집합 \(\{\textbf{P}_{vk} \in \mathbb{R}^{p \times p \times 6}\}_{k=1}^{HW/p^2}\)로 patchify되고 linear layer로 projection된다.
\[\begin{equation} \textbf{x}_{vk} = \textrm{Linear} (\textbf{I}_{vk}), \quad \textbf{s}_{vk} = \textrm{Linear} (\textbf{P}_{vk}) \end{equation}\]두 임베딩은 \(\textbf{a}_{vk} = \textbf{x}_{vk} + \textbf{s}_{vk}\)로 합산되고, 인코더 입력 토큰인 1D 시퀀스 \(\textbf{A} \in \mathbb{R}^{N_\textbf{I} \times C}\)로 flatten된다. 모든 뷰에 걸쳐 attention을 허용하는 표준 ViT layer를 적용하고 마지막으로 layer normalization을 적용하여 이미지 토큰 \(\textbf{B} \in \mathbb{R}^{N_\textbf{I} \times C}\)를 얻는다.
디코더는 DETR의 디자인을 따른다. $N_t$개의 학습 가능한 3DGS 토큰 \(\textbf{T}_\textrm{IN} \in \mathbb{R}^{N_t \times C}\)를 초기화하고, 이미지 토큰 $\textbf{B}$에 대한 cross-attention, 3DGS 토큰 간의 self-attention, per-token MLP로 구성된 Transformer 디코더 block을 적용한다. 이를 통해 출력 임베딩 \(\textbf{T}_\textrm{OUT}\)이 생성된다.
각 출력 임베딩으로부터 linear layer를 사용하여 \(N_\mathcal{G} = 64\)개 Gaussian primitive에 대한 14가지 Gaussian 속성을 예측한다. 이 속성들은 실수 값을 가지므로, 각 속성을 해당 범위에 맞게 매핑해야 한다. XYZ 좌표는 $f(x) = \textrm{sign}(x) \cdot (\exp(x) − 1)$을 사용하여 예측한다. 색상 $\textbf{c}$와 opacity $\sigma$에는 tanh, scale $\textbf{s}$에는 clipped exponential, rotation quaternion $\textbf{q}$에는 unit normalization을 적용한다. 이러한 매핑 과정을 거친 후, 모든 토큰의 Gaussian을 flatten하여 \(\mathcal{G} \in \mathbb{R}^{N_c N_g \times 14}\)를 얻는다.
일반적으로 3DGS 토큰보다 이미지 토큰의 수가 훨씬 많기 때문에, 디코더의 메모리 사용량을 주로 $N_t$에 의존하도록 설계하면 더 깊은 구조로 scaling하는 것이 가능해진다. 따라서 본 논문에서는 모든 디코더 cross-attention layer가 이미지 토큰에 대한 key-value projection을 공유하는 최적화 방식을 사용하였다. 이러한 projection은 디코딩 시작 시 한 번만 계산되므로, 깊이가 \(D_\textrm{dec}\)인 디코더의 경우 \(O(N_\textbf{I} D_\textrm{dec})\) 규모의 메모리 할당을 \(O(N_\textbf{I})\)로 대체할 수 있다.
인코더와 디코더 모두에 대해 안정적인 학습에 필수적인 LayerScale과 QK-normalization을 사용한다. 일반적인 관행과는 달리, 최종 regression head 앞의 layer normalization은 재구성 품질을 저하시키기 때문에 이를 생략한다.
Dynamic Scene Modeling
동적 장면을 처리하기 위해, BTimer를 따라 동적 3DGS 토큰을 도입하여 프레임워크를 확장한다. 각 동적 토큰은 대상 프레임을 나타내는 학습 가능한 시간 임베딩을 입력받는 반면, 정적 토큰은 시간에 따라 변하지 않는 상태를 유지한다. 동적 토큰은 정적 토큰을 대상으로 causal attention을 수행하며, 이를 통해 모델은 시간적 일관성을 유지하면서 장면을 정적 요소와 동적 요소로 분리할 수 있다.
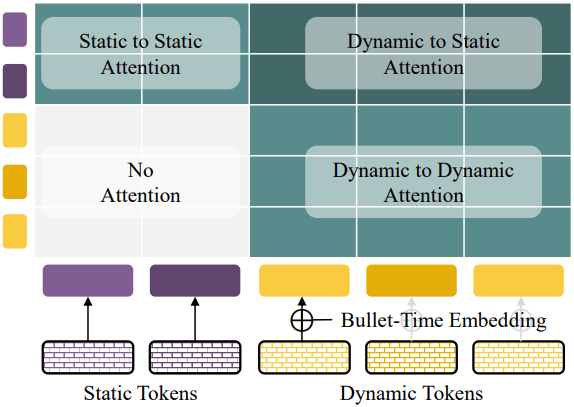
정적 토큰과 동적 토큰
구체적으로, 원래의 3DGS 토큰 집합 $\textbf{T}$를 두 개의 별도 토큰 집합으로 나눈다.
\[\begin{aligned} \textbf{T}^\textrm{S} &= \{ \textbf{T}_1^\textrm{S}, \ldots, \textbf{T}_{N_s}^\textrm{S} \} \in \mathbb{R}^{N_s \times C} \\ \textbf{T}^\textrm{D} &= \{ \textbf{T}_1^\textrm{D}, \ldots, \textbf{T}_{N_d}^\textrm{D} \} \in \mathbb{R}^{N_d \times C} \end{aligned}\]BTimer에서 도입된 공식을 차용하여, 복원하고자 하는 timestamp $t$를 동적 토큰에 추가한다. 구체적으로, 다음과 같이 학습 가능한 시간 임베딩을 더한다.
\[\begin{equation} \tilde{\textbf{T}}_j^\textrm{D} (t) = \textbf{T}_j^\textrm{D} + \textrm{Linear} (\tau (t)) \end{equation}\]($\tau (t)$는 sinusoidal encoding)
Attention Masking
본 논문에서는 Transformer 디코더의 self-attention 부분에서 결합된 토큰 집합 \(\textbf{T}(t) = \textbf{T}^\textrm{S} \cup \tilde{\textbf{T}}^\textrm{D}(t)\)에 구조화된 attention mask를 적용한다. 구체적으로, 동적 토큰이 정적 토큰에 대해서만 단방향으로 attention할 수 있는 인과적 구조를 적용한다. 이는 장면의 동적 부분이 정적 부분에 의존한다는 inductive bias를 제공하여 모델이 장면을 정적 구조와 동적 모션으로 분해할 수 있도록 한다. 동적 토큰은 모든 프레임에 걸쳐 일관된 correspondence를 유지한다.
3. Test-Time Scaling
본 논문의 인코더-디코더 디자인은 네트워크 재학습 없이도 상호 보완적인 두 가지 형태의 test-time scaling을 자연스럽게 지원한다.
- Context extension: inference 단계에서 학습 시 사용된 것보다 더 많은 이미지 토큰을 입력하는 방법. Gaussian의 개수가 고정되어 있어 컨텍스트 길이와 무관하게 Gaussian 개수가 유지된다.
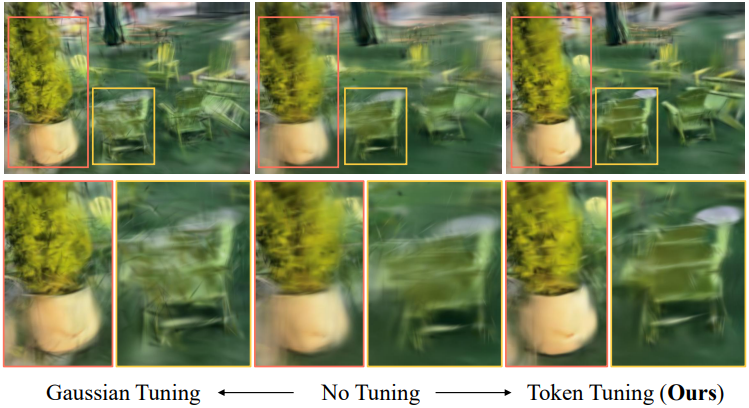
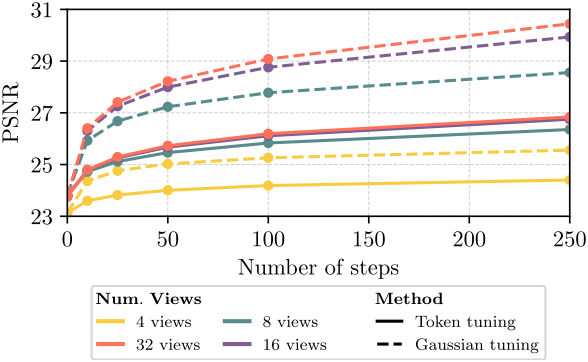
- Token-Tuning (TT)은 네트워크 파라미터와 이미지 feature를 고정한 상태에서 입력 뷰에 대한 self-supervision을 통해 3DGS 토큰만을 fine-tuning하는 가벼운 test-time training 방법. 적은 수의 gradient 업데이트만으로도 attention 패턴이 특정 장면에 최적화되도록 적응하며, 이를 통해 네트워크의 나머지 부분에 인코딩된 학습된 prior를을 보존하면서도 Gaussian 파라미터를 개선할 수 있다.
Experiments
- 구현 디테일
- 인코더 layer 6개, 디코더 layer 24개, $C = 1024$
- 3DGS 토큰 1024개로 15만 iteration 학습 후, 4096개로 1만 iteration fine-tuning
- GPU: NVIDIA A100 8개
- batch size: 64
- optimizer: AdamW (cosine scheduler)
- learning rate
- pre-train: $4 \times 10^{-4}$, 2,000 warmup
- fine-tuning: $4 \times 10^{-5}$, 400 warmup
- Token-Tuning (TT): $10^{-4}$ (50 step)
1. Static Scene Reconstruction
다음은 RealEstate10K (2-view)에서의 재구성 성능을 비교한 결과이다.
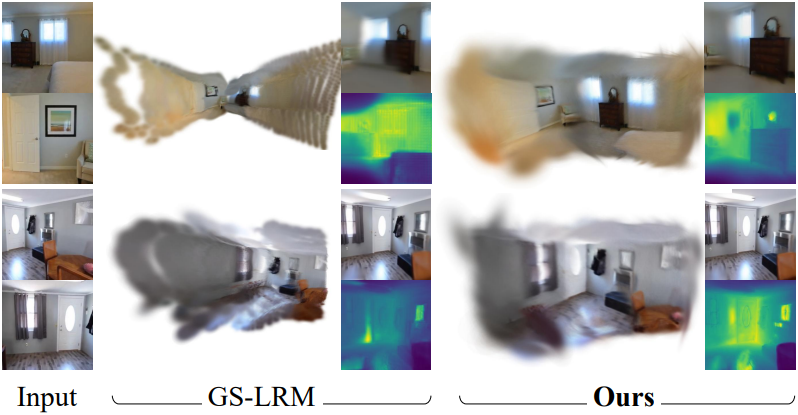
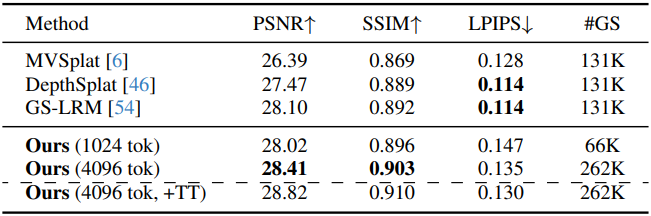
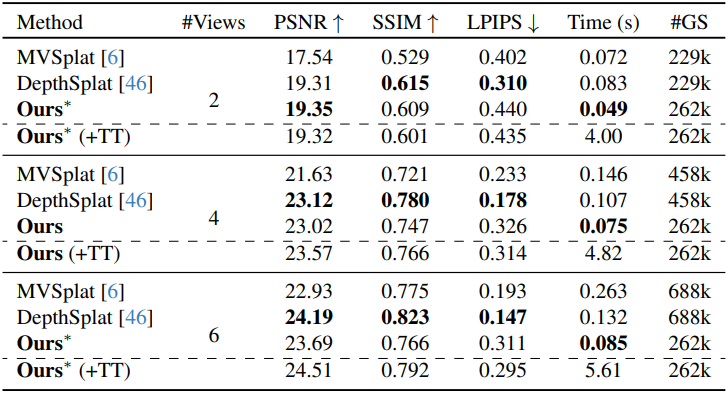
다음은 DL3DV에서의 재구성 성능을 비교한 결과이다.
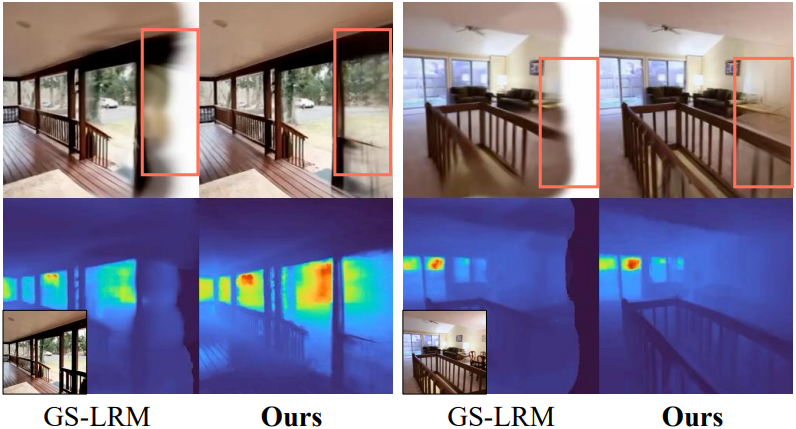
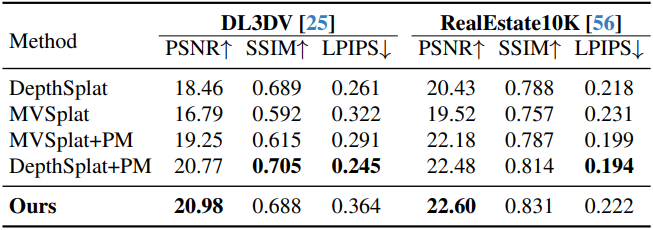
2. View Extrapolation
다음은 extrapolation 성능을 비교한 결과이다.
3. Reconstruction with Camera noise
다음은 카메라 노이즈에 따른 GS-LRM과의 렌더링 품질 차이이다.
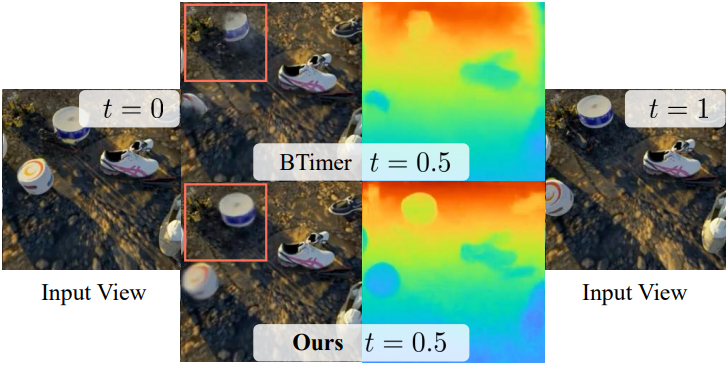
4. Dynamic Reconstruction
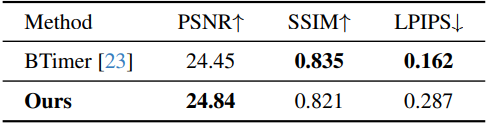
다음은 Kubric에서의 동적 재구성 성능을 비교한 결과이다.
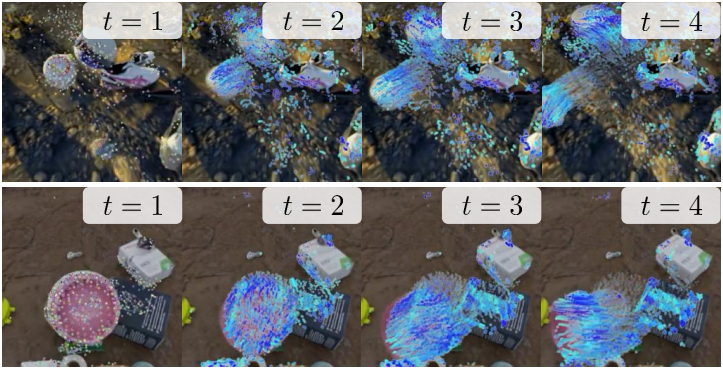
다음은 scene flow를 시각화한 것이다.
5. Ablation Study
다음은 visibility loss에 대한 ablation study 결과이다.
다음은 test-time scaling 결과이다.
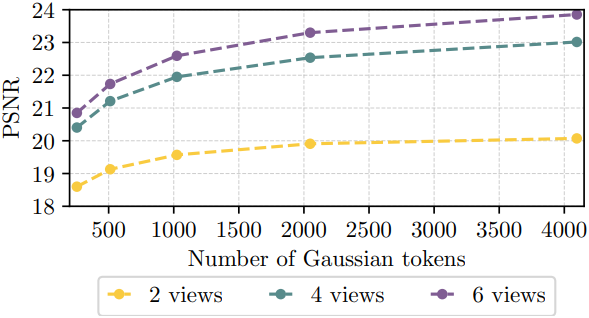
다음은 Gaussian 토큰 개수에 따른 렌더링 품질을 비교한 결과이다.