[논문리뷰] LATTICE: Democratize High-Fidelity 3D Generation at Scale
CVPR 2026. [Paper] [Page]
Zeqiang Lai, Yunfei Zhao, Zibo Zhao, Haolin Liu, Qingxiang Lin, Jingwei Huang, Chunchao Guo, Xiangyu Yue
MMLab, CUHK | Tencent Hunyuan
24 Nov 2025
Introduction
3D 생성이 품질과 scalability 측면에서 여전히 2D 생성에 비해 크게 뒤처지는 근본 원인은 생성이 정의되는 방식의 차이에 있다. 2D 이미지 생성의 경우 공간 그리드가 사전에 정의되어 있어, 모델은 고정된 픽셀 좌표에서의 RGB 값을 추론하기만 하면 된다. 반면, 3D 생성은 공간 내 어디에 콘텐츠를 배치할지, 그리고 그곳에 무엇을 표현할지를 모두 찾아내야 한다. 구조와 콘텐츠를 동시에 고려해야 하는 이러한 복합적인 추론 과정은 탐색 공간을 비약적으로 확장하고 모호성을 초래하여, 최적화를 어렵게 만들고 scaling 특성을 예측하기 어렵게 만든다.
언뜻 보기에 sparse voxel은 그 고유한 공간 구조 덕분에 유망한 선택지로 보일 수 있다. 그러나 저자들은 test-time scaling에 대한 강력한 역량 때문에 VecSet 기반의 표현 방식을 선호하였으며, Localizable Code를 통해 두 방식의 장점을 결합할 수 있음을 보여주었다. 본 논문의 핵심 아이디어는 VecSet latent code에 localizable한 구조를 부여하는 것이다. 즉, 구조와 콘텐츠에 대한 예측을 분리하고, 2D 이미지 생성의 성공 사례를 모방하여 구조 및 위치 정보를 통해 구조가 없는 VecSet의 생성을 유도하고자 하였다.
VecSet 기반 방법들은 dense하게 샘플링된 포인트 클라우드와 object 표면에서 샘플링된 point query들 사이의 cross-attention을 통해 object를 몇 개의 feature 벡터들로 압축한다. 저자들은 point query를 통해 생성된 VecSet latent에 인코딩된 위치 정보를 조사하였다. 각 latent는 해당 point query의 위치 인근 영역과 강한 상관관계를 갖는다. 그러나 테스트 시점에는 point query의 위치를 알 수 없으므로, 이러한 정보는 생성 과정에서 별다른 도움이 되지 않는다.
따라서 저자들은 point query를 완벽하게 대체할 수 있는 voxel query를 도입하였다. 표면상의 포인트 좌표를 사용하는 대신, object 표면과 교차하는 활성 voxel의 중심 좌표를 활용하는 것이다. 이러한 활성 voxel grid는 매우 coarse하게 설정할 수 있어 쉽게 획득 가능하다. 즉, 테스트 시점에 품질이 다소 완벽하지 않더라도 기존의 geometry 생성 모델로 생성된 geometry를 voxelize함으로써 이를 얻을 수 있다.
이렇게 탄생한 VoxSet은 VecSet의 효율성과 단순함을 계승하면서도 latent space에 구조를 도입한 새로운 semi-structured 표현 방식이다. 이러한 설계는 몇 가지 독보적인 이점을 제공한다.
- 임의의 해상도에서 유연한 인코딩과 디코딩이 가능하여 학습 비용이 획기적으로 절감된다. 즉, 매우 작은 토큰 크기로 사전 학습을 수행한 뒤 점진적으로 토큰 크기를 키워나가는 다단계 학습을 할 수 있다.
- VoxSet의 모든 latent는 3D regular voxel grid에 기반하여 구조화되어 있다. 따라서 위치 임베딩을 통해 위치 정보를 DiT에 직접 주입할 수 있으며, 이는 diffusion process에서 강력한 guidance를 제공할 뿐만 아니라 모델 scaling에 필수적이다.
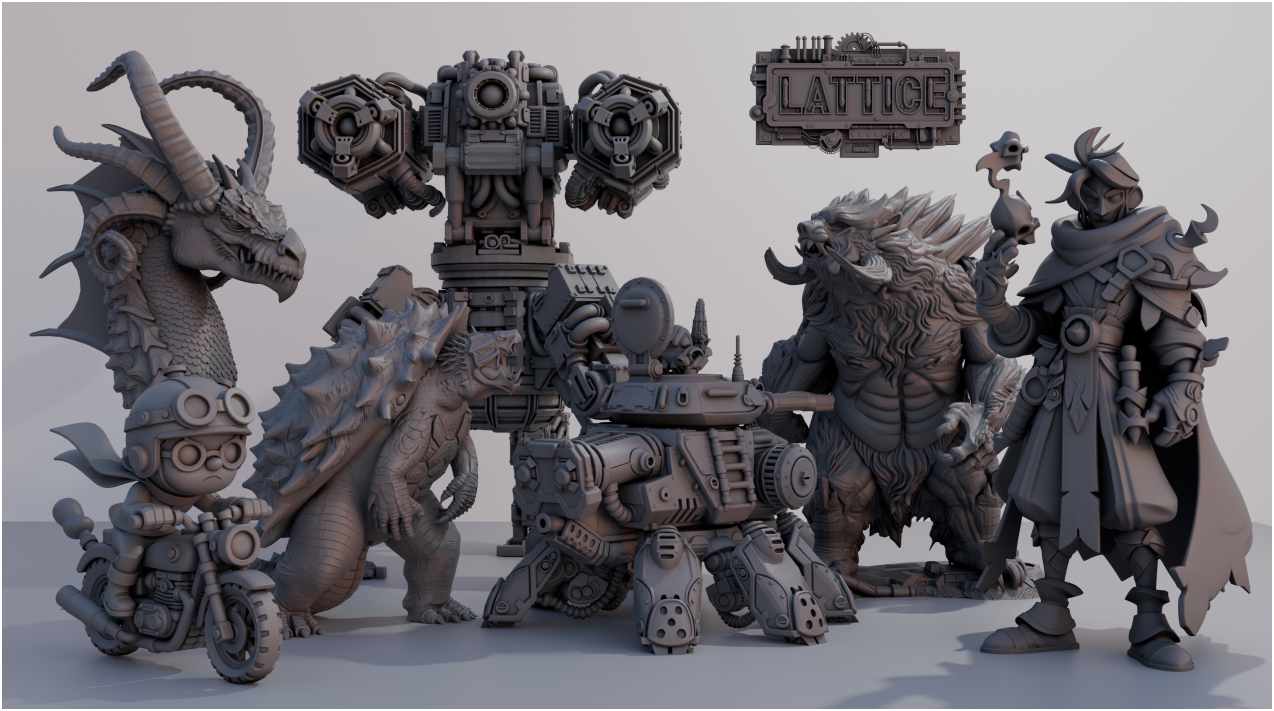
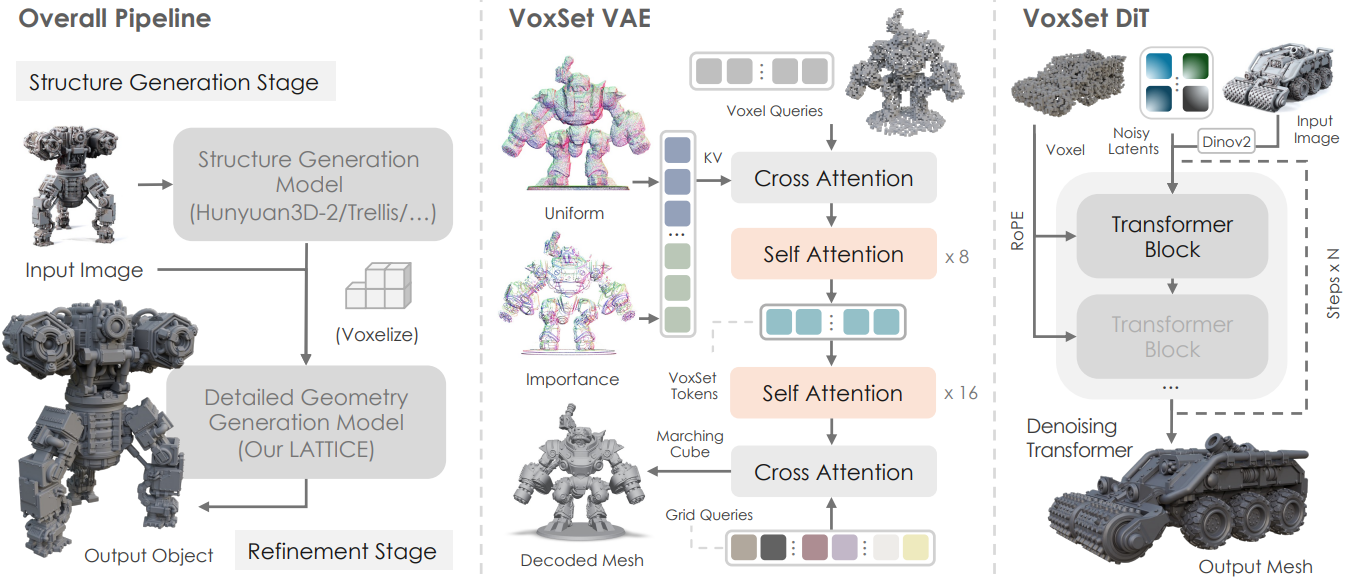
본 논문에서는 VoxSet을 기반으로, 고충실도의 정교한 3D 에셋을 생성하기 위해 설계된 범용 프레임워크인 LATTICE를 제안하였다. LATTICE는 2단계 파이프라인으로 구성된다. 첫 번째 단계에서는 Hunyuan3D-2나 Trellis와 같은 기존 모델로 생성된 coarse한 메쉬를 voxelize하여 sparse voxel grid를 생성한다. 두 번째 단계에서는 선택된 voxel grid 내에서 임의의 토큰 수로 VoxSet을 생성한다.
LATTICE는 test-time scaling이 가능하며, 기존 SOTA 모델들보다 학습 비용이 낮고, 모델이 간단하며, 3D 생성 성능이 뛰어나다.
Method
1. VoxSet Representation
VoxSet은 scalability와 structural latent space라는 두 가지 핵심 원칙을 기반으로 하는 latent 표현 방식이다. Scalability를 지원하기 위해, VoxSet은 3DShape2VecSet의 설계를 따라 cross-attention 메커니즘을 통해 임의의 3D 에셋을 latent 토큰 시퀀스로 압축한다.
구체적으로, 주어진 3D object에 대해 VAE를 사용하여 포인트 클라우드 표현을 인코딩하고 해당 SDF를 재구성하며, 이를 바탕으로 Marching Cubes 알고리즘을 통해 표면 메쉬를 추출한다. 입력 포인트 클라우드 $P \in \mathbb{R}^{N \times 7}$은 각 포인트마다 여러 속성을 포함하는데, 각 포인트는 3D 좌표, 표면 normal, 그리고 날카로운 edge에 위치하는지 여부를 나타내는 binary sharpness indicator를 인코딩한다. Hunyuan3D-2의 전략을 따라, 고주파 디테일을 더 잘 보존하기 위해 표면 전체에 대한 uniform sampling과 날카로운 edge 주변의 importance sampling을 결합하여 포인트 클라우드를 구성하였다.
Sparsity를 활용한 효율적인 scaling
Latent 표현, 즉 토큰 시퀀스는 입력 포인트 클라우드와 query 토큰 집합 간의 cross-attention을 수행한 후, 일련의 self-attention layer를 거쳐 얻어진다. 디코더는 대칭적인 구조로 설계되었으며, SDF grid 좌표를 query로 하여 latent 토큰과 cross-attention을 수행한다. 특히 이 latent 토큰들은 글로벌 신호를 내재적으로 인코딩하고 있어, 임의 길이의 latent 시퀀스로 모든 3D object를 표현할 수 있다. 이는 점진적 토큰 scaling을 통해 학습 비용을 획기적으로 절감할 수 있다는 점에서 매우 유용하다. 예를 들어, 1024개의 토큰으로 사전 학습을 시작하여 점차 토큰 수를 늘려가는 방식이 가능하다.
디테일 모델링을 위한 Voxel Query
Query set의 선택은 VecSet 계열 방법에서 매우 중요한 설계 요소이며, VoxSet을 구별하는 핵심적인 특징이기도 하다. 3DShape2VecSet에서는 learnable query와 point query, 두 가지 유형의 query set을 제안하였다. Learnable query는 글로벌 통계 정보를 인코딩하며 학습이 용이하지만, 재구성 및 생성 성능 향상을 위한 scalability에 한계가 있다. Point query는 farthest point sampling을 통해 다운샘플링된 포인트 클라우드로, query 주변의 로컬 정보를 인코딩하고 임의 해상도에서의 인코딩-디코딩을 지원하여 점진적 scaling에 유리하다.
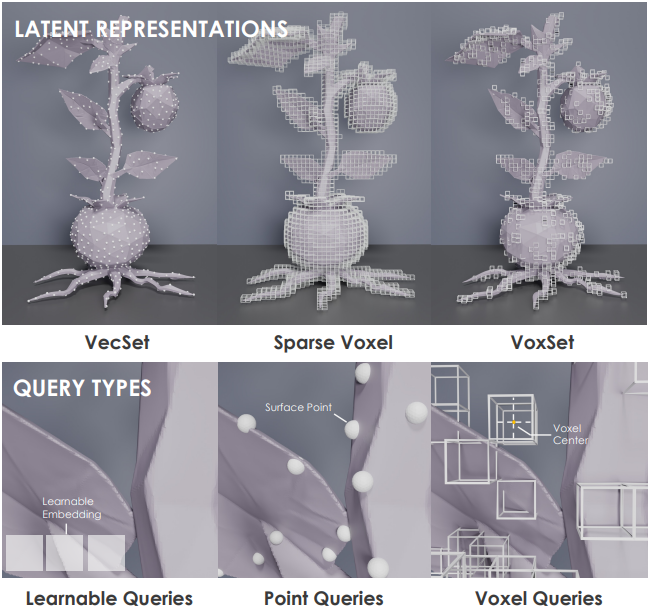
또한, point query로 인코딩된 latent 토큰의 locality는 매우 강하며, 위치와 밀접한 상관관계를 가진다. 즉, point query에서 생성된 latent 집합은 위치 정보가 암묵적으로 인코딩된 상태로 정렬되어 있다. 그러나 기존 모델 중 어느 것도 이 정보를 활용하지 못하고 있다. 가장 큰 걸림돌 중 하나는 point query가 object 표면에서 샘플링되는데, 테스트 시점에는 해당 표면의 위치를 알 수 없다는 점이다.
이 문제를 해결하기 위해, 본 논문에서는 object 표면과 교차하는 활성 voxel의 중심에 고정된 query 집합인 voxel query를 도입하였다. Voxel query는 표면이 아닌 coarse voxel grid 상에서 샘플링되므로, 테스트 시점에 구조 생성 단계를 통해 그 위치를 쉽게 파악할 수 있다. 또한, voxel 중심은 서로 다른 표면들과의 상관관계가 제거되어 있어, 학습과 테스트 간의 격차를 줄이고 테스트 시점의 일반화 성능을 크게 향상시킨다.
2. Detailed Geometry Generation
본 논문은 정교한 디테일을 갖춘 geometry를 생성하기 위해 제안된 VoxSet 표현에 최적화된 2단계 파이프라인을 도입하였다. 첫 번째 단계에서는 기존에 사전 학습된 3D 생성 모델의 출력 결과를 voxelize하여 입력 이미지에 기반한 coarse하고 sparse한 구조를 생성한다. 두 번째 단계에서는 앞서 생성된 구조의 voxel 중심에 위치하는 sparse voxel latent를 생성한다.
Semi-Structured Geometry VAE
Semi-Structured Geometry VAE를 학습시키기 위해 제안된 VoxSet 표현을 사용한다. 다중 해상도 voxel 구조를 지원하기 위해, 다양한 해상도에서 voxel query를 무작위로 샘플링하는 대신 임의의 해상도를 지원하는 더 간단한 접근 방식을 제안하였다. 구체적으로, 학습 중에는 작은 무작위 offset \(\epsilon \sim U[-\frac{1}{2R}, \frac{1}{2R}]\)을 더하여 point query에 jittering을 적용한다 ($R$은 지원하는 최소 해상도). 테스트 시점이나 diffusion model 학습 중에는 $R$보다 큰 임의의 해상도에서 voxel query를 샘플링할 수 있다. 균일하게 샘플링된 포인트 클라우드에서만 query를 샘플링한다는 점을 제외하면, VAE의 다른 모든 사항은 Hunyuan3D-2와 동일하다.
DiT에 구조 정보 추가
Hunyuan3D-2를 따라, VoxSet을 생성하기 위해 rectified-flow transformer를 활용한다. 단순히 입력 이미지만을 조건으로 사용하는 대신, 각 noisy latent 토큰에 rotary positional embedding (RoPE)을 추가하여 VoxSet의 구조적 정보를 활용한다. 이러한 변화는 모델의 수렴을 개선하는 데 결정적인 역할을 한다. 그 이유는 크게 두 가지로 설명할 수 있다.
- 3D 데이터의 양이 2D 이미지나 동영상 데이터에 비해 훨씬 적어 latent space가 대부분 비어 있는 상태가 되기 때문이다.
- 이미지의 모든 픽셀이 RGB 값을 갖는 것과 달리, 3D geometry의 표면은 전체 bounding box 내에서 아주 작은 부분만을 차지하기 때문이다.
결과적으로, 이미지만을 조건으로 사용하던 기존 방식으로는 denoising 궤적을 디테일한 geometry를 형성하는 방향으로 유도하기 어려웠다.
저자들은 학습 비용을 절감하기 위해 두 가지 간단한 전략을 도입했다.
- 모든 구조 토큰을 사용하는 대신 학습 중 고정된 개수의 토큰을 무작위로 샘플링했다.
- 처음에는 1024개의 토큰으로 학습을 시작한 뒤 점차 토큰 수를 6144개까지 늘려가는 점진적 학습 전략을 채택했다.
이미지 컨디셔닝
Hunyuan3D-2를 따라, 이미지 컨디셔닝을 위해 DINOv2-Giant를 사용하며, 클래스 토큰을 제외한 hidden layer의 임베딩을 활용한다. Hunyuan3D-2가 518 해상도를 사용한 것과 달리, 더 정교한 디테일을 위해 1022 해상도를 사용한다. 토큰 길이를 줄이기 위해 종횡비를 유지하면서 binary mask를 사용하여 object를 crop한다. DINO가 이미 충분한 공간 정보를 인코딩하고 있으므로 별도의 위치 임베딩은 추가하지 않는다.
학습 및 test-time scaling
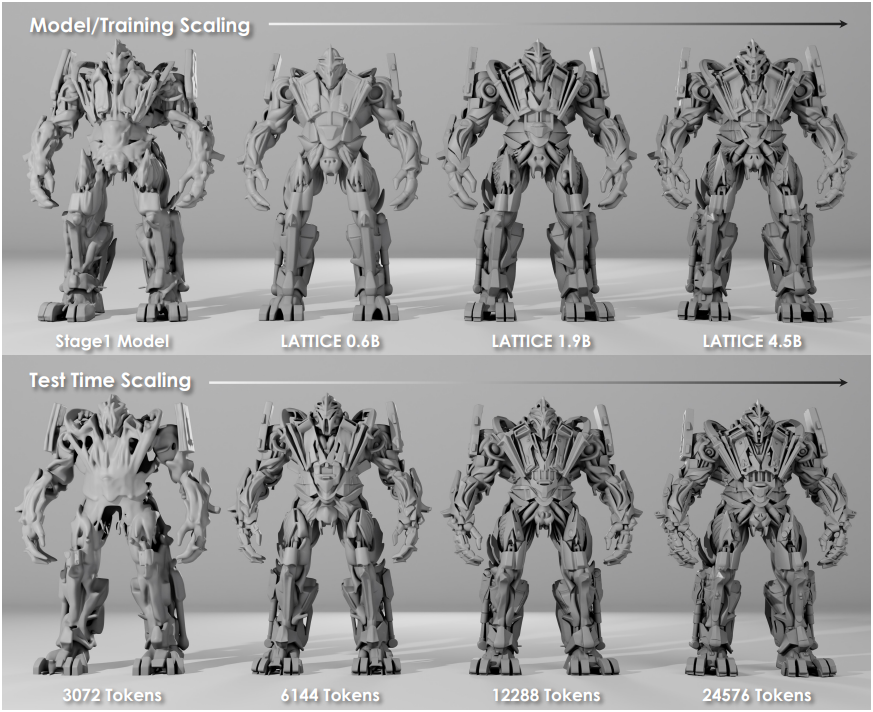
저자들은 0.6B부터 4.5B까지의 다양한 크기의 모델을 학습시켰다. 모델은 안정적인 scaling 효과, 즉 모델이 클수록 성능이 향상됨을 보인다. 또한, 놀랍게도 모델은 토큰 길이에 대한 test-time scaling 효과도 나타난다. 모델은 6144개의 토큰으로 학습되었지만, 더 많은 voxel query를 샘플링함으로써 토큰 수를 12288개, 24576개, 혹은 그 이상으로 늘릴 수 있다.
Experiments
1. Reconstruction
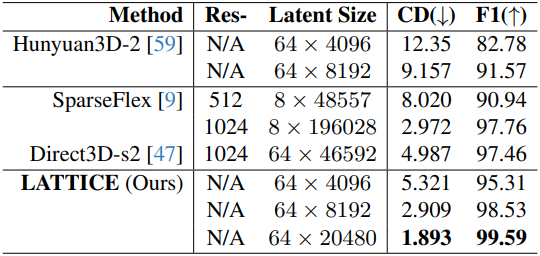
다음은 geometry 재구성에 대한 비교 결과이다.
2. Generation
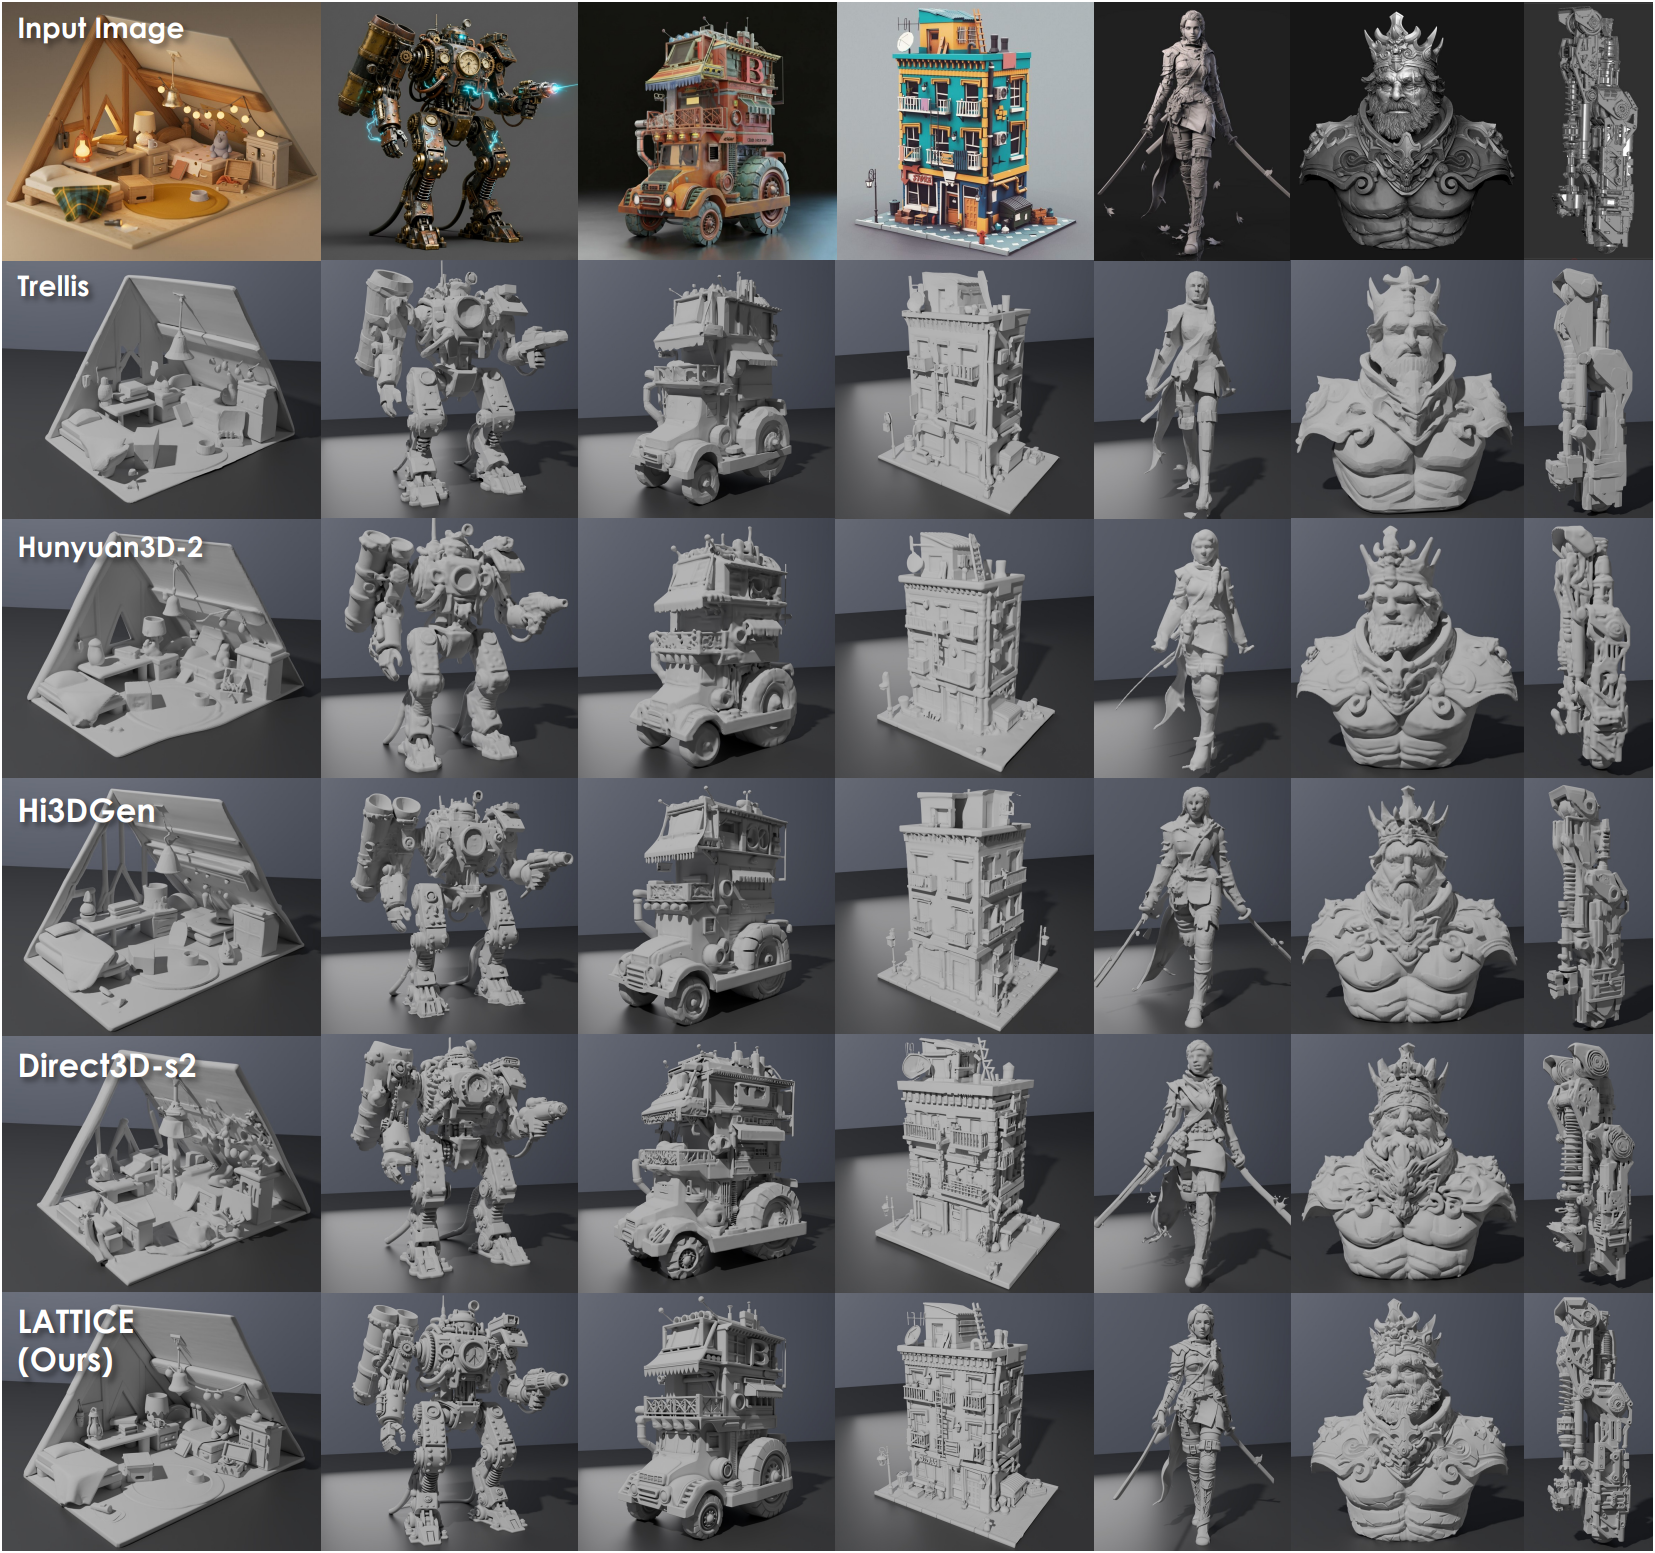
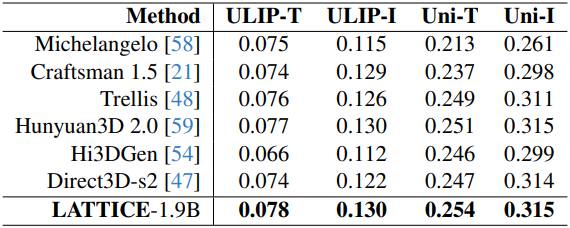
다음은 geometry 생성에 대한 비교 결과이다.
3. Evaluation
다음은 voxel query와 VoxSet에 대한 ablation study 결과이다.
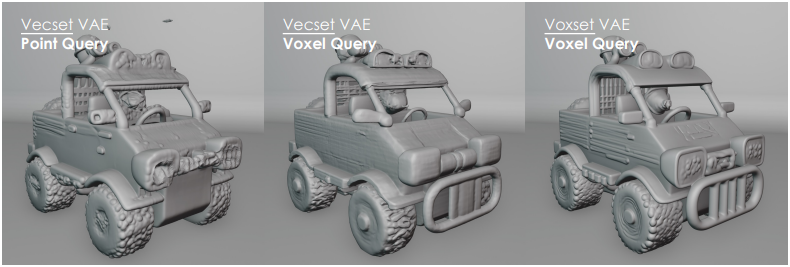
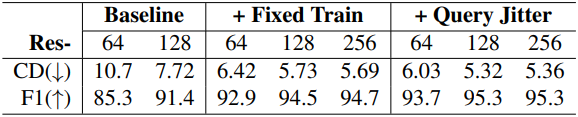
다음은 VAE 학습 전략에 대한 ablation study 결과이다.
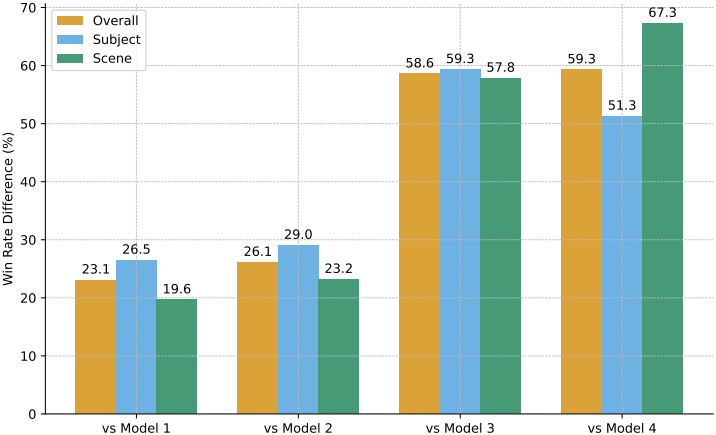
다음은 user study 결과이다.