[논문리뷰] Amodal3R: Amodal 3D Reconstruction from Occluded 2D Images
ICCV 2025. [Paper] [Page] [Github]
Tianhao Wu, Chuanxia Zheng, Frank Guan, Andrea Vedaldi, Tat-Jen Cham
Nanyang Technological University | Visual Geometry Group, University of Oxford | Singapore Institute of Technology
17 Mar 2025
Introduction
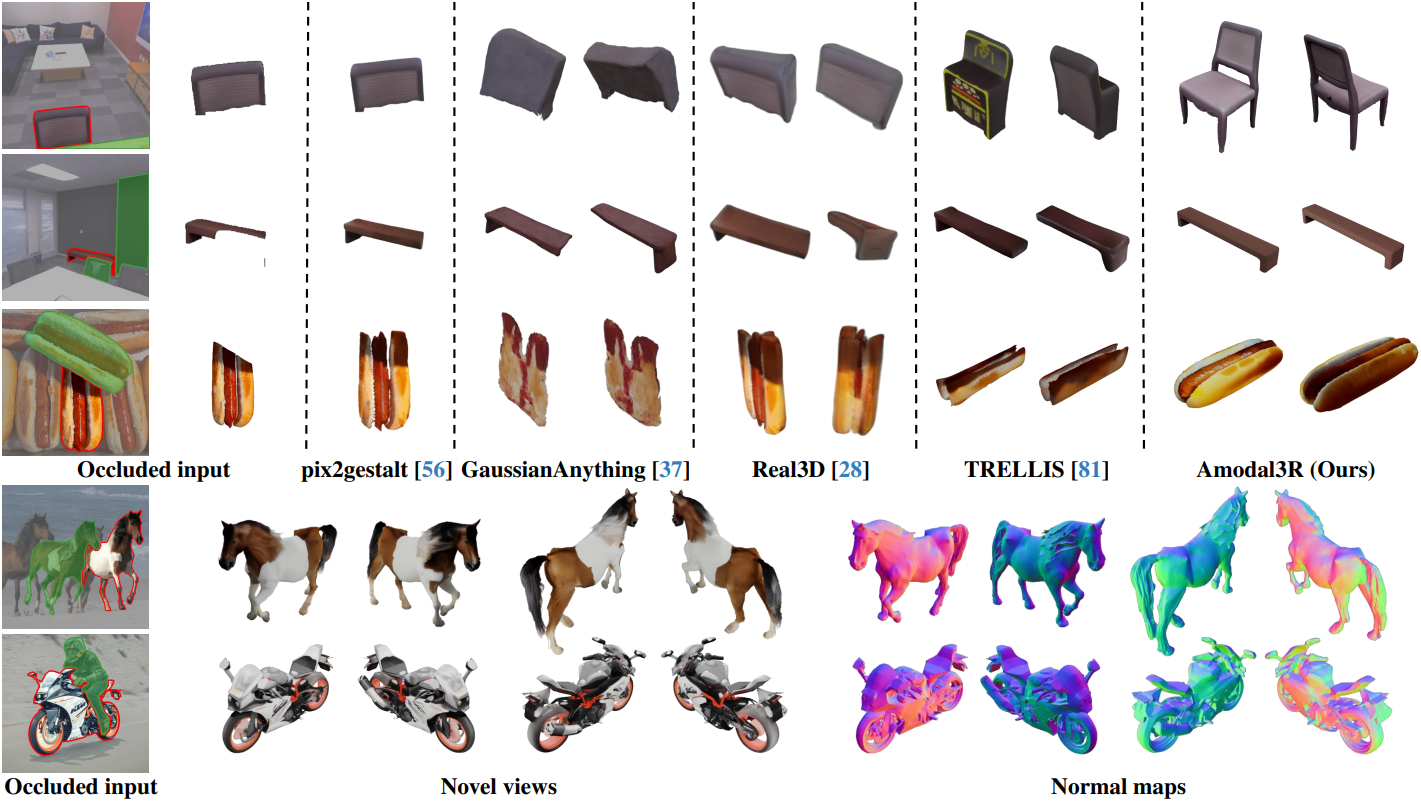
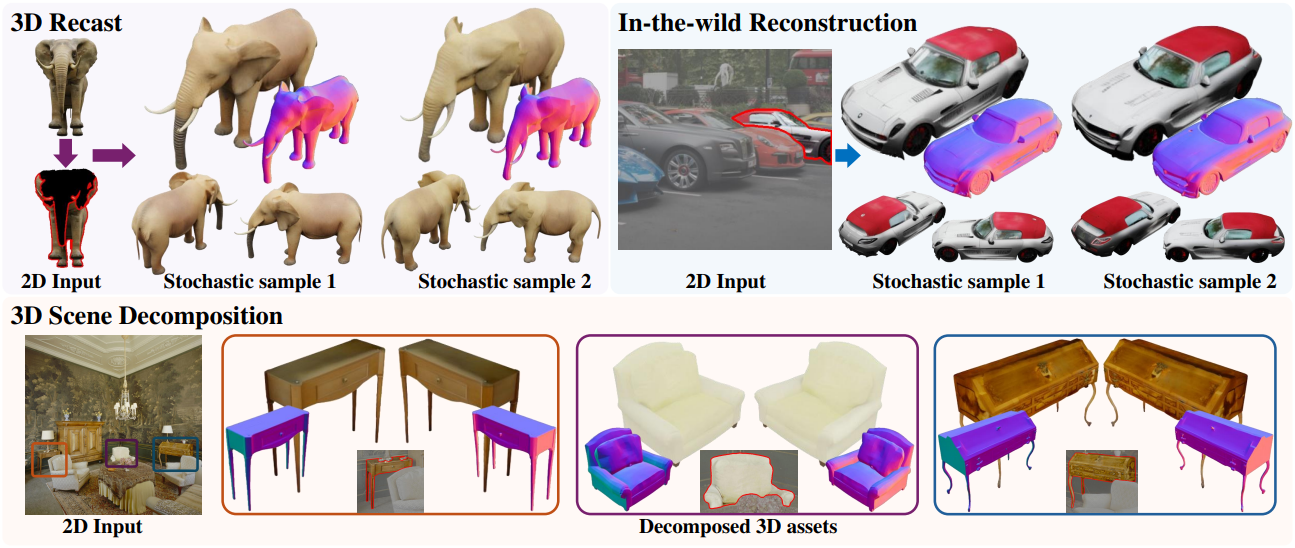
기존의 이미지 기반 3D Reconstruction 모델들은 object가 부분적으로 가려져 있을 경우, 그 전체적인 3D 에셋을 온전히 복원해내지 못한다. 이에 본 논문에서는 부분적으로 가려진 하나 이상의 시점 정보로부터 3D object를 재구성하는 문제를 다루며, 이를 amodal 3D reconstruction이라 부르는 새로운 task로 정의하였다.
본 논문에서는 기존의 SOTA 기법들을 능가하는, amodal 3D reconstruction을 위한 새로운 single-stage 패러다임인 Amodal3R를 제안하였다. Amodal3R은 3D 생성 모델인 TRELLIS에 occlusion 정보를 조건으로 활용하는 추가 branch를 결합한 형태이다. 이 모델의 핵심 장점은 two-stage 방식을 거치지 않고, 3D latent space 내에서 reconstruction, completion, occlusion 추론을 직접 수행한다는 점이다. 이를 통해 모델은 object의 보이는 영역과 가려진 영역을 모두 일관되고 그럴듯하게 재구성할 수 있다.
TRELLIS를 amodal reconstruction에 적용하기 위해, 본 논문에서는 multi-head cross-attention에 mask weighting을 도입하고, occlusion 정보를 고려하는 새로운 layer를 추가하였다. 이러한 요소들은 사전 학습된 모델을 크게 훼손하지 않으면서도, 모델이 object의 보이는 부분에 더 집중하도록 유도한다.
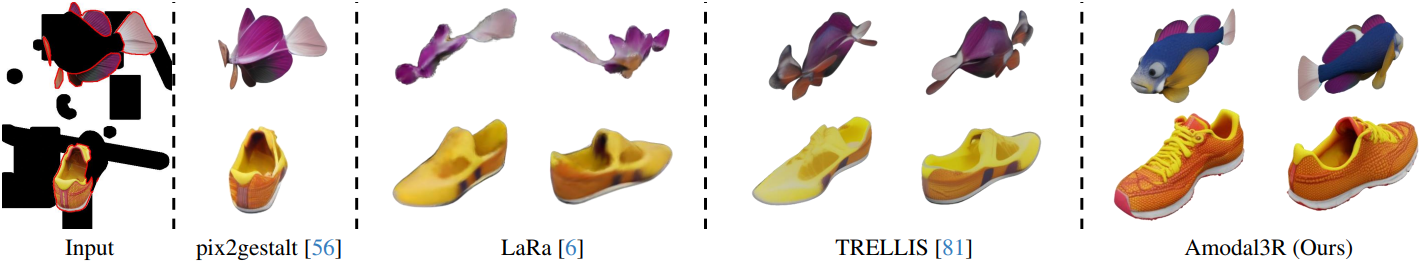
Amodal3R은 별도의 휴리스틱에 의존하지 않고도 기존 SOTA 모델들보다 월등히 뛰어난 성능을 달성했으며, 실제 데이터를 포함한 다양한 데이터셋에 대해서도 우수한 일반화 성능을 보였다.
Method
관심 object $o_i$가 부분적으로 가려진 상태로 포함된 이미지 $x$가 주어졌을 때, 이 $o_i$의 완전한 3D shape과 외형 $y$를 복원하는 것이 목표이다. Amodal3R은 occlusion을 고려한 end-to-end 3D reconstruction 모델로서, 3D 공간 내에서 직접 완전한 shape과 멀티뷰 geometry를 생성한다.
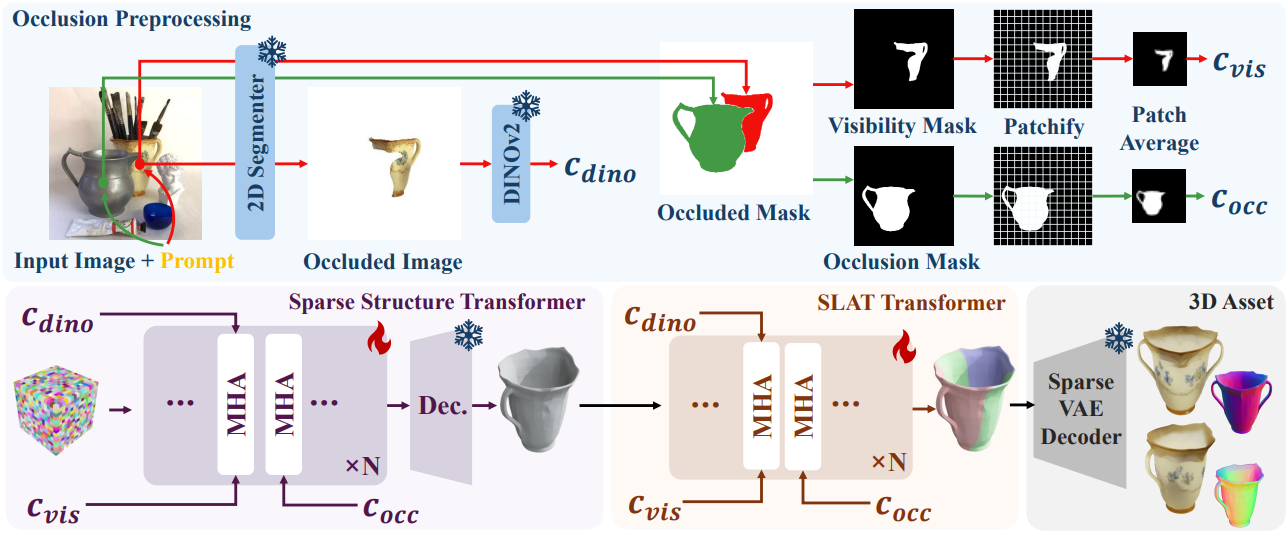
구체적으로, Amodal3R은 $o_i$를 중심으로 하는 이미지 $x$와, visibility mask \(M_\textrm{vis}\), occlusion mask \(M_\textrm{occ}\)를 입력으로 받는 conditional generator \(\upsilon_\theta (y \vert o_i, M_\textrm{vis}, M_\textrm{occ})\)이다. \(M_\textrm{vis}\)는 이미지 $x$ 내에서 $o_i$가 포함된 픽셀들을 나타내며, \(M_\textrm{occ}\)는 $o_i$를 가릴 가능성이 있는 다른 모든 object가 포함된 픽셀들을 나타낸다. 실제 이미지의 경우, SAM과 같은 2D segmentation 모델을 사용하여 이러한 마스크들을 효율적으로 얻을 수 있다.
1. Mask-Conditional Generative Models
부분적으로 가려진 이미지에서도 작동하도록 generator를 fine-tuning하는 데 필요한 핵심적인 변화는 transformer \(\upsilon_\theta\)를 이미지 $x$뿐만 아니라 마스크 \(M_\textrm{vis}\)와 \(M_\textrm{occ}\)에도 컨디셔닝하는 것이다.
단순한 방식은 마스크를 다운샘플링하거나 임베딩하여 토큰 \((c_\textrm{vis}, c_\textrm{occ})\)를 얻고, 이를 이미지 토큰 \(c_\textrm{dino}\)에 연결하여 transformer가 이전처럼 cross-attention을 통해 처리하는 것이다. 그러나 이미지 $x$는 binary mask \(M_\textrm{vis}\)와 \(M_\textrm{occ}\)보다 훨씬 더 많은 정보를 포함하고 있으므로, 초기에는 이미지 $x$만 고려하도록 학습된 transformer는 이 정보를 무시할 수 있다. 또한, 이미지 토큰과 호환되지 않는 새로운 유형의 토큰을 사용하는 이 새로운 정보를 학습하려면 transformer를 적극적으로 fine-tuning해야 할 수도 있다.
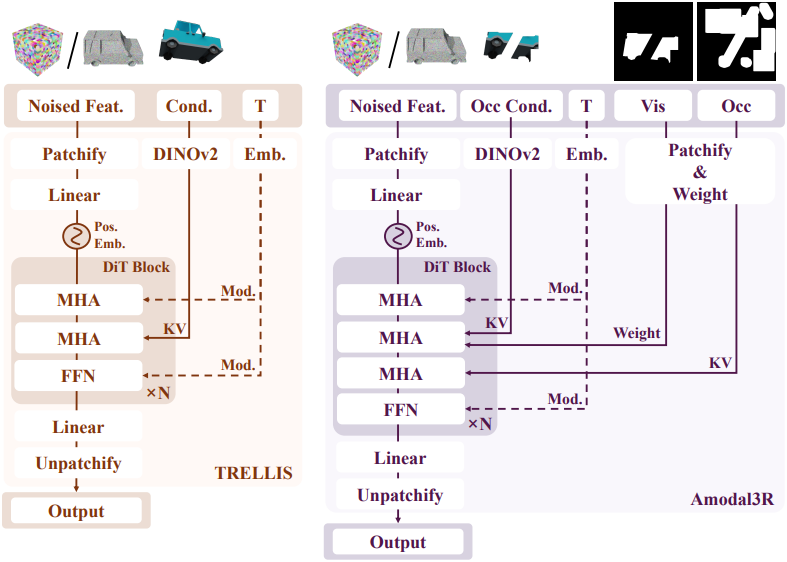
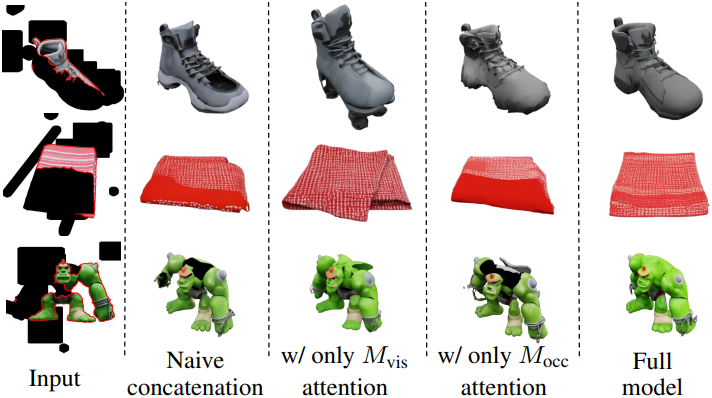
이 문제를 해결하기 위해, 2D completion 방법인 TFill의 masked attention 방식을 참고하여, 사전 학습된 3D generator를 크게 방해하지 않으면서 \(M_\textrm{vis}\)와 \(M_\textrm{occ}\)를 더 잘 활용할 수 있도록 mask-weighted cross-attention과 occlusion-aware attention을 도입하였다.
Mask-weighted Cross-Attention
Mask-weighted cross-attention을 통해 모델은 object의 보이는 부분에 집중할 수 있다. 이 메커니즘은 transformer \(\upsilon_\theta\)에 있는 각 attention block에 구현되어 있다. Cross-attention layer에 입력되는 latent 토큰 $\ell \in \mathbb{R}^{L \times C}$과 부분적으로 보이는 object의 이미지 feature \(c_\textrm{dino} \in \mathbb{R}^{K \times C^\prime}\)가 주어지면, cross-attention은 유사도 점수 행렬 $S \in \mathbb{R}^{L \times K}$를 계산한다.
\[\begin{equation} q = W_q \ell, \quad [k, v] = W_{kv} c_\textrm{dino}, \quad S = \frac{qk^\top}{\sqrt{D}} \end{equation}\]토큰 유사도 행렬 $S$가 object의 보이는 부분들에 더 큰 가중치를 두도록 편향을 줘야 한다. 여기서 $K$는 가려진 이미지 \(x \cdot M_\textrm{vis}\)로부터 DINOv2를 통해 추출된 토큰들의 개수이다. 따라서 각 토큰은 입력 이미지 내의 14$\times$14 크기 패치에 대응된다.
따라서 visibility mask로부터 $j$번째 이미지 패치 \(M_{\textrm{vis}, j}\) 내에서 실제로 보이는 픽셀들의 비율 \(c_{\textrm{vis},j} = \rho(M_{\textrm{vis},j}) \in [0, 1]\)을 계산함으로써, 이에 대응하는 1차원 토큰 \(c_\textrm{vis} = [c_{\textrm{vis},1}, \ldots, c_{\textrm{vis},K}]\)를 추출한다. 그런 다음, 이 값들을 활용하여 broadcasting 방식으로 attention 행렬 $A$를 계산할 때 편향을 적용한다.
\[\begin{aligned} A &= \textrm{softmax} (S + \log c_\textrm{vis}) \in [0, 1]^{L \times K} \\ A_{ij} &= \frac{c_{\textrm{vis}, j} \exp (S_{ij})}{\sum_{k=1}^K c_{\textrm{vis}, k} \exp (S_{ik})} \end{aligned}\]이와 같은 방식으로, visibility flag는 attention 행렬 $A$를 부드럽게 조절한다. 패치 $j$ 내에 보이는 픽셀이 하나도 없다면 $A_{ij} = 0$이 되며, 따라서 cross attention 과정에서 대응하는 이미지 토큰들은 생략된다. 여기서는 single-head를 기준으로 작동 방식을 설명했지만, 실제 Amodal3R은 multi-head transformer를 사용한다.
\[\begin{aligned} A_h &= \textrm{softmax} (S_h + \log c_\textrm{vis}) \\ \textrm{MHA} &= [A_1 v; A_2 v; \ldots; A_H v] \end{aligned}\]Occlusion-aware Attention
네트워크가 object의 보이는 부분에 집중하도록 유도하는 것 외에도, 본 논문에서는 occlusion-aware attention layer를 도입하였다. Amodal completion을 위해서는 전경의 occluder와 배경을 구분해야 하는데, 이를 통해 보완이 필요한 잠재적 영역을 명확히 식별할 수 있기 때문이다. 마스크 \(M_\textrm{vis}\)에서 특정 픽셀이 보이지 않는다고 표시된 경우, 이는 해당 픽셀 앞에 occluder가 존재하기 때문일 수도 있고, 혹은 해당 픽셀이 object 영역 밖에 완전히 벗어나 있기 때문일 수도 있다. 이러한 정보는 마스크 \(M_\textrm{occ}\)를 통해 인코딩된다.
모델이 보이는 영역, 가려진 영역, 배경 영역을 구분할 수 있도록, mask-weighted cross-attention layer 바로 뒤에 cross-attention layer를 하나 더 추가하고, 이를 통해 \(M_\textrm{occ}\)만 넣는다. 이를 위해, \(M_\textrm{vis}\)와 마찬가지로 \(M_\textrm{occ}\)를 1차원으로 펼쳐진 토큰 집합 \(c_\textrm{occ}\)로 인코딩한 다음, cross-attention layer에 \(c_\textrm{occ}\)를 넣는다.
2. Simulating Occluded 3D Data
모델을 학습시키고 평가하기 위해서는 복잡한 환경이나 occlusion이 존재하는 상황에서 촬영된 3D 에셋 데이터셋이 필요하다. 현실 세계에서 이러한 데이터를 확보하기는 어렵기 때문에, 저자들은 합성 데이터와 시뮬레이션을 활용했다.
Random 2D Occlusions
각 학습 샘플은 \((o, x, M_\textrm{vis}, M_\textrm{occ})\)로 구성된다. 실제 상황에서 occlusion은 장면 내의 다른 object들에 의해 발생한다. 멀티뷰 환경에서는, 이러한 occlusion이 장면의 geometry를 반영하며 여러 시점에 걸쳐 일관성을 유지해야 한다. 하지만 본 모델은 단일 시점에서 reconstruction하는 것을 목표로 학습되므로, object를 2D로 렌더링한 후 그 일부를 무작위로 마스킹하는 방식으로 occlusion을 시뮬레이션할 수 있다. 이 방식은 더 간단할 뿐만 아니라, 학습을 위해 시점을 샘플링할 때마다 새로운 occlusion 패턴을 생성할 수 있게 해준다.
따라서 object $o$와 임의의 시점에서 렌더링된 이미지 $x$가 주어지면, 선, 타원, 직사각형을 무작위로 배치함으로써 다양한 occlusion 패턴을 모사한다. 이러한 무작위 도형들을 모두 합친 것이 \(M_\textrm{occ}\)가 된다. \(M_\textrm{vis}\)는 가려지지 않은 object의 마스크 \(M_\textrm{obj}\)를 사용하여 \(M_\textrm{vis} = M_\textrm{obj} \odot (1 - M_\textrm{occ})\)로 정의된다.
3D-consistent occlusions
여러 시점에서 촬영된 실제 장면에서, occlusion은 무작위로 발생하는 것이 아니라 다른 물체들에 의해 유발되므로 시점 전반에 걸쳐 일관되게 나타난다. 특히 contact occlusion의 경우에 두드러지는데, 이때는 object의 일부가 모든 시점에서 다른 object에 의해 가려진 상태로 남게 된다. 이러한 까다로운 조건에서 모델의 성능을 평가하려면 3D 일관성을 갖춘 마스크가 필요하다.
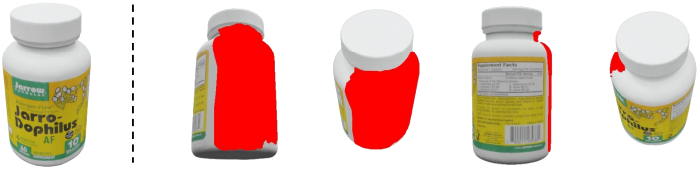
이러한 contact occlusion mask들을 효율적으로 생성하기 위해, 렌더링 과정에서 3D 메쉬를 활용한다. 임의로 선택한 삼각형에서 시작하여, random-walk 전략을 통해 인접한 삼각형들을 반복적으로 선택함으로써, 미리 정의된 마스크 비율을 충족할 때까지 연속적인 occlusion 영역을 형성한다. RGB 이미지와 동일한 카메라 파라미터를 사용하여 이렇게 마스킹된 메쉬를 렌더링함으로써, 생성된 마스크 전반에 걸쳐 멀티뷰 일관성을 보장한다.
3. Reconstruction with Multi-view Input
TRELLIS는 다단계 denoising process를 거치며, 입력 뷰에 대한 카메라 포즈 정보를 필요로 하지 않는다. 따라서 Amodal3R은 각 denoising step에서 멀티뷰 레퍼런스 이미지 집합 \(\mathcal{X} = \{x_i\}_{i=1}^N\)을 컨디셔닝 입력으로 활용할 수 있다.
멀티뷰 컨디셔닝 입력은 reconstruction 성능을 자연스럽게 향상시키지만, 한 가지 잠재적인 문제가 있다. Denoising process의 초기 step에 사용된 이미지가 최종 3D geometry에 더 큰 영향을 미친다는 점이다. 이는 초기 step에서는 대략적인 geometry의 윤곽이 잡히고, 이후 step에서는 더 세밀한 디테일이 다듬어지기 때문이다.
따라서 저자들은 입력 이미지들을 visibility에 따라 우선순위를 정하여 처리하였다. 구체적으로, 멀티뷰 입력을 사용할 경우 visibility \(\vert M_\textrm{vis} \vert\)에 비례하여 이미지들을 정렬함으로써, visibility가 더 높은 이미지들이 주요 입력으로 사용되도록 하였다.
Experiments
1. Main Results
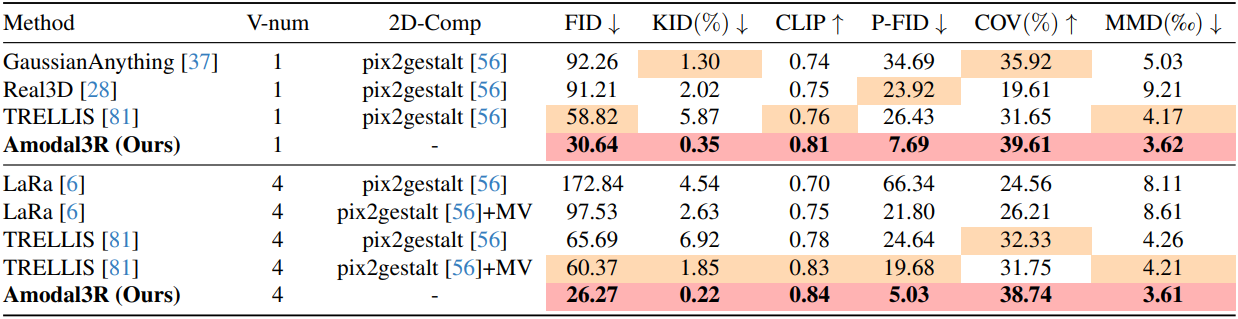
다음은 GSO에서의 비교 결과이다.
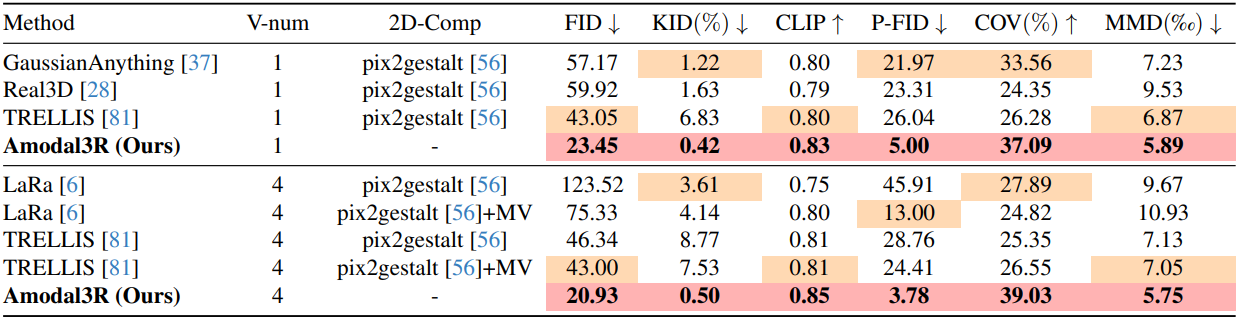
다음은 Toys4K에서의 비교 결과이다.
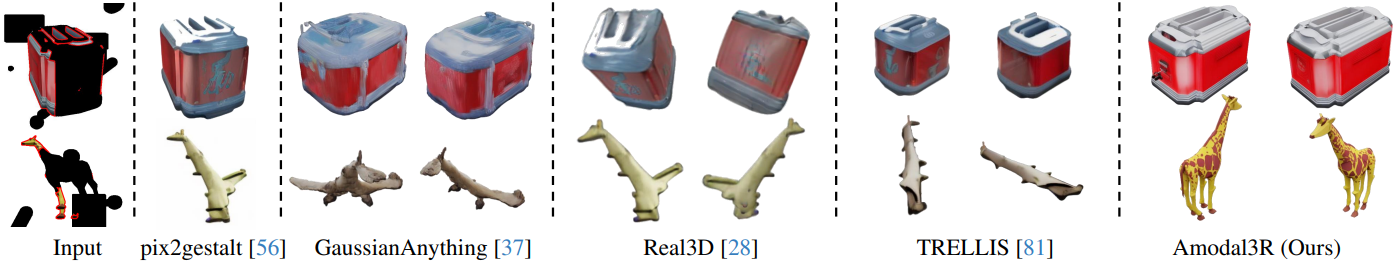
다음은 single-view amodal 3D reconstruction 예시들이다.
다음은 4-view amodal 3D reconstruction 예시들이다.
2. Ablation Study
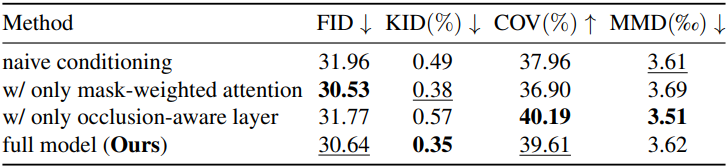
다음은 ablation study 결과이다.
3. Real-World Generation / Completion
다음은 Replica와 실제 이미지들에 대한 결과들이다.