[논문리뷰] OneCAT: Decoder-Only Auto-Regressive Model for Unified Understanding and Generation
CVPR 2026. [Paper] [Page] [Github]
Han Li, Xinyu Peng, Yaoming Wang, Zelin Peng, Xin Chen, Rongxiang Weng, Jingang Wang, Xunliang Cai, Wenrui Dai, Hongkai Xiong
Meituan Inc | Shanghai Jiao Tong University
3 Sep 2025
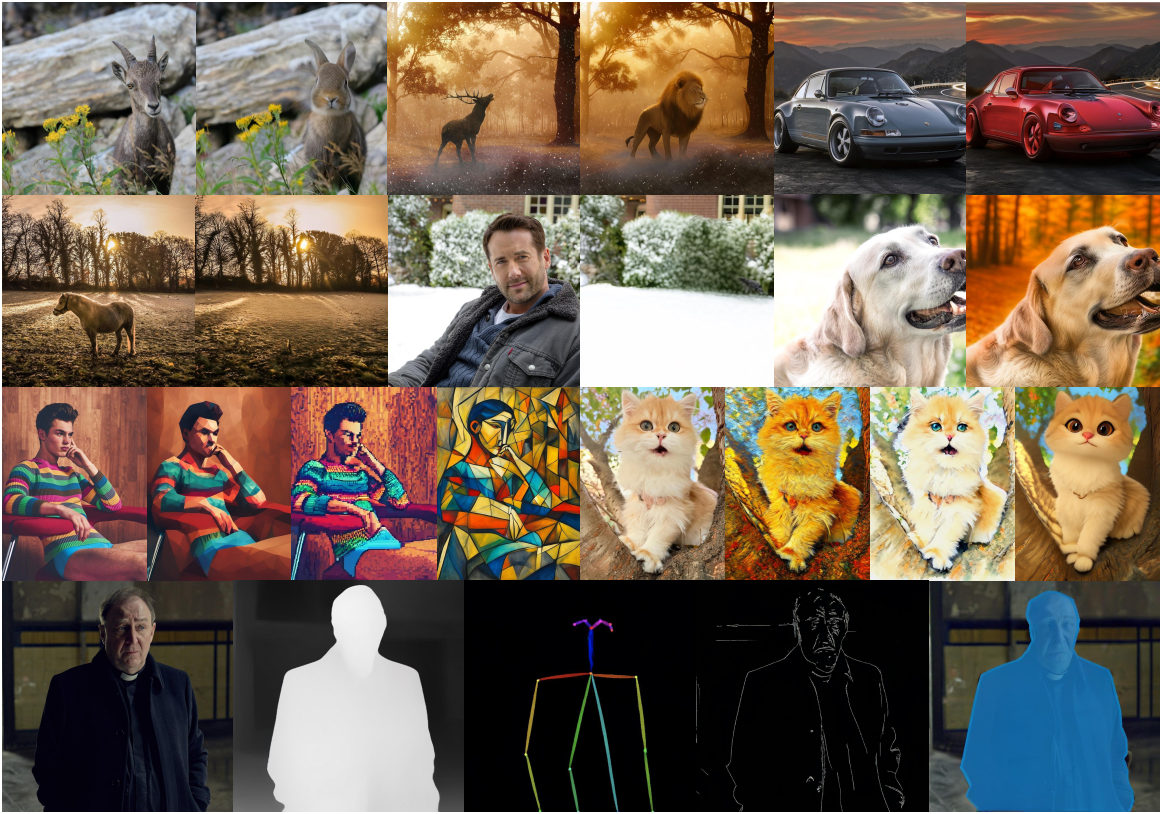
Introduction
본 논문에서는 최초의 인코더 없는 통합 multimodal LLM (MLLM) 프레임워크를 제안하였다. 이 프레임워크에서는 비전 입력이 패치 임베딩으로 직접 tokenize되어 하나의 디코더 모델 내에서 텍스트 토큰과 함께 처리된다. 핵심은 continuous visual token, discrete visual token, 텍스트 토큰을 전문 expert에게 동적으로 라우팅하는 modality-specific MoE layer이다. 이를 통해 정교한 인코더 없이도 초기 단계의 feature 융합이 가능하다.
이미지 생성의 경우, 멀티스케일 autoregressive 메커니즘을 LLM에 내장하고, augmentation을 위해 스케일별 표현을 추출하는 scale-aware adapter (SAA)를 제안하였다. 따라서 이미지 토큰은 저해상도에서 고해상도까지 예측할 수 있으며, 텍스트 토큰에는 next token prediction (NTP) 방식을 적용하였다. 이러한 설계는 diffusion model의 높은 latency를 해결하고 세밀한 생성 프로세스를 학습함으로써 이미지 생성 속도와 품질을 크게 향상시킨다.
인코더 없는 MLLM을 학습시키는 것은 데이터 집약적인 것으로 알려져 있다. 이를 완화하기 위한 distillation 방법들은 teacher 모델의 작은 크기로 인해 LLM의 표현력이 제한되는 문제를 겪는다. 본 논문에서는 강력한 MLLM teacher를 커스터마이징한 다음, 해당 teacher의 포괄적인 인지 능력을 제안된 MLLM으로 효율적으로 전송하는 새로운 distillation 전략을 통해 이 문제를 해결하였다. 이를 기반으로 대규모 멀티모달 데이터를 사용하고, 통합된 expert 사전 학습, mid-training, supervised fine-tuning을 적용하여 공유 디코더가 이해, 생성, 편집 간에 원활하게 전환할 수 있는 일반화된 표현을 달성하도록 하였다.
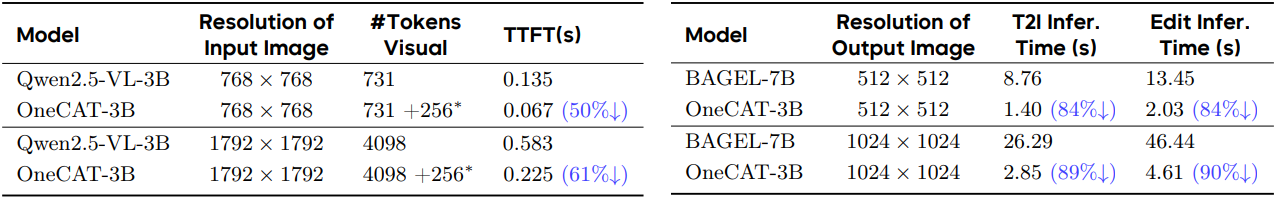
이러한 혁신을 바탕으로, 본 논문은 통합 멀티모달 모델인 OneCAT을 제안하였다. OneCAT은 통합 모델 분야에서 새로운 SOTA를 달성했다. 무엇보다 인코더가 없는 설계 덕분에 inference 속도가 크게 향상되었으며, 이는 특히 고해상도 입력 및 출력 환경에서 두드러진다.
OneCAT
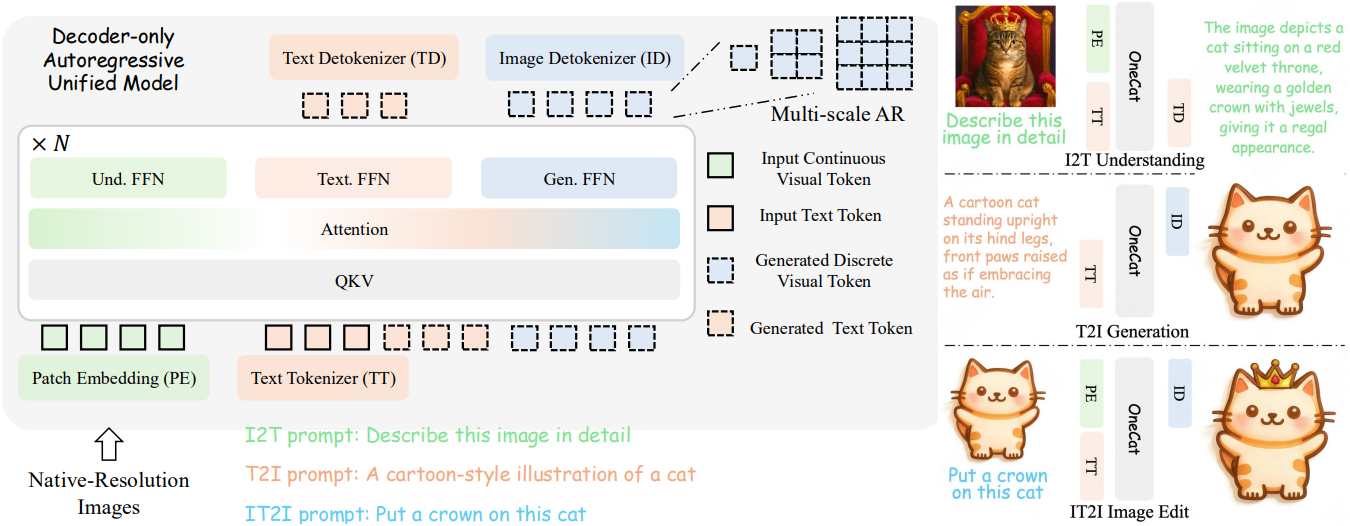
OneCAT은 decoder-only 아키텍처를 채택하여 inference 과정에서 추가적인 비전 인코더나 tokenizer가 필요하지 않다. 이러한 간소화된 설계는 모델 구조를 크게 단순화하고 계산 비용을 절감한다. OneCAT은 가벼운 patch embedding layer를 사용하여 이미지를 연속적인 비전 토큰으로 변환함으로써 효율적이고 손실 없는 처리를 수행한다. 동일한 patch embedding layer는 편집을 위한 레퍼런스 이미지 처리에도 사용되어 별도의 VAE tokenizer를 대체하고 inference 효율성을 더욱 향상시킨다.
텍스트 생성에 있어 OneCAT은 next-token prediction 패러다임을 따른다. 이미지 생성의 경우, next-scale prediction이라는 혁신적인 방식을 도입하였다. 이 방식에서는 이미지가 계층적이고 coarse-to-fine하게 생성되며, 가장 낮은 해상도 스케일에서 가장 높은 해상도 스케일까지 점진적으로 완성된다.
1. Modality-MoE
OneCAT은 세 가지 feed-forward network (FFN) expert를 갖춘 Modality-MoE 아키텍처를 제안하였다.
- Text. FFN: 언어 이해를 위한 텍스트 토큰 처리에 특화
- Und. FFN: 시각적 이해를 위한 continuous visual token 처리에 특화
- Gen. FFN: 이미지 생성을 위한 discrete visual token 처리에 특화
토큰을 모달리티와 주어진 task에 따라 특정 expert에게 할당하는 hard routing 메커니즘을 사용하였다. 다른 QKV layer와 attention layer는 공유되어 파라미터 효율성을 높이고 instruction-following을 위한 cross-modal 정렬을 구현하였다.
OneCAT은 사전 학습된 Qwen2.5 LLM을 기반으로 초기화되며, 이를 통해 해당 모델이 지닌 강력한 언어 모델링 능력을 활용한다. Modality-MoE를 구축하기 위해, Qwen2.5의 각 transformer block에 포함된 FFN layer를 복제하여 세 개의 독립적인 expert를 구성하였다. 각 멀티모달 task에 필요한 핵심 기능은 다음과 같이 처리된다.
멀티모달 이해
원본 이미지를 continuous visual token으로 변환하기 위해 간단하면서도 효과적인 patch embedding layer를 사용한다. 이 layer는 이미지를 패치 단위로 나누기 위한 14$\times$14 convolution 연산, 2$\times$2 pixel unshuffle layer, visual feature를 LLM의 hidden dimension에 맞춰 projection하기 위한 2-layer MLP로 구성된다.
Text-to-Image 생성
본 논문에서는 pixel space와 latent space 간의 이미지 매핑을 위해 Infinity에서 제공하는 사전 학습된 멀티스케일 VAE 모델을 활용하였다. 이 VAE는 다운샘플링 비율이 16, latent 채널 크기가 32이며, vocabulary를 확장하기 위해 bitwise quantizer를 사용한다.
학습 시에 VAE tokenizer는 대상 이미지를 멀티스케일의 discrete visual token으로 인코딩하여 GT 데이터로 활용한다. Inference 시에는 이 tokenizer가 필요하지 않으며, 생성된 멀티스케일 비전 토큰으로부터 이미지를 재구성하기 위해 detokenizer만을 사용한다.
이미지 편집
OneCAT은 레퍼런스 이미지와 instruction 입력을 활용하여 이미지 편집을 지원한다. 레퍼런스 이미지는 patch embedding layer를 거쳐 처리되며, 생성된 continuous visual token은 조건으로서 Und. FFN으로 전달된다. Patch embedding layer는 레퍼런스 이미지에 대한 거의 무손실 표현을 제공한다. 이를 통해 LLM의 초기 layer는 픽셀 단위의 일관성을 위한 저수준 feature를 얻고, 나중 layer는 semantic한 이해를 위한 고수준 feature를 추출할 수 있게 된다.
이러한 계층적 비전 컨텍스트를 바탕으로, LLM은 새로운 discrete visual token을 autoregressive 방식으로 예측한다. 이러한 설계는 별도의 구조적 수정 없이도 강력한 생성을 가능하게 하며, 통합된 decoder-only 설계가 가진 범용성을 잘 보여준다.
2. Scale-Aware Adapter for Hierarchical Generation
멀티스케일 VAE가 생성하는 토큰들은 본질적으로 계층적 구조를 띤다. 구체적으로, 하위 스케일의 토큰은 주로 색상, 조명, 구조와 같은 저주파 글로벌 정보를 인코딩하는 반면, 상위 스케일의 토큰은 미세한 텍스처나 복잡한 패턴을 포함한 고주파 디테일을 포착한다. 이처럼 기능적으로 서로 다른 토큰들을 공유된 Gen. FFN을 통해 동일하게 처리하는 것은 최적의 방식이 아니며, 오히려 표현 능력을 제한할 수 있다.
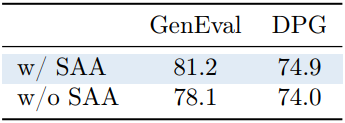
이를 해결하기 위해, 본 연구에서는 Gen. FFN에 통합되는 새로운 아키텍처 구성 요소인 Scale-Aware Adapter (SAA)를 도입하였다. SAA는 Gen. FFN의 각 linear layer에 대해 skip connection 역할을 하는 병렬 모듈들로 구성된다. 각 SAA는 특정 스케일의 토큰을 처리하도록 설계되었으며, Gen. FFN 내 SAA의 총 개수는 VAE 스케일의 개수와 일치한다.
Inference 과정에서, discrete visual token들은 스케일 인덱스에 따라 해당 스케일 전용 어댑터로 전달된다. 파라미터 효율성을 위해, 각 어댑터는 LoRA에서 영감을 받은 low-rank decomposition 방식을 사용하여 구현되었다. 다만, 일반적으로 fine-tuning에 사용되는 LoRA와 달리, SAA 모듈은 LLM의 영구적인 구성 요소로서 전체 학습 과정에서 함께 end-to-end 방식으로 학습된다.
3. Multimodal versatile attention mechanism
본 논문에서는 FlexAttention 기반의 multimodal versatile attention 메커니즘을 활용하여 하나의 LLM 내에서 다양한 모달리티와 task를 유연하게 처리할 수 있도록 하였다.
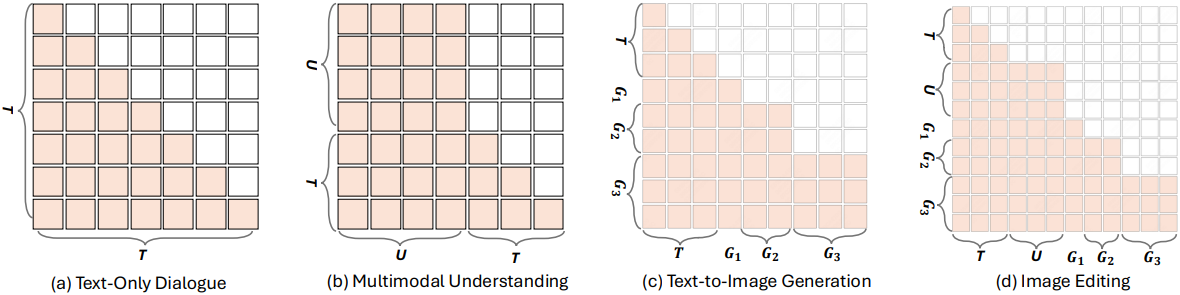
텍스트 토큰 $T$는 autoregressive한 생성을 위해 causal attention을 사용하고, continuous visual token $U$는 글로벌 상호작용을 위해 full attention을 적용한다. 멀티스케일의 discrete visual token $G$는 block causal attention을 사용한다. 동일한 스케일 내의 토큰들은 서로 자유롭게 attention을 주고받는 반면, 스케일 간의 attention은 causal attention을 따른다.
Model Training Pipeline
1. Stage-1: Multimodal Pretraining
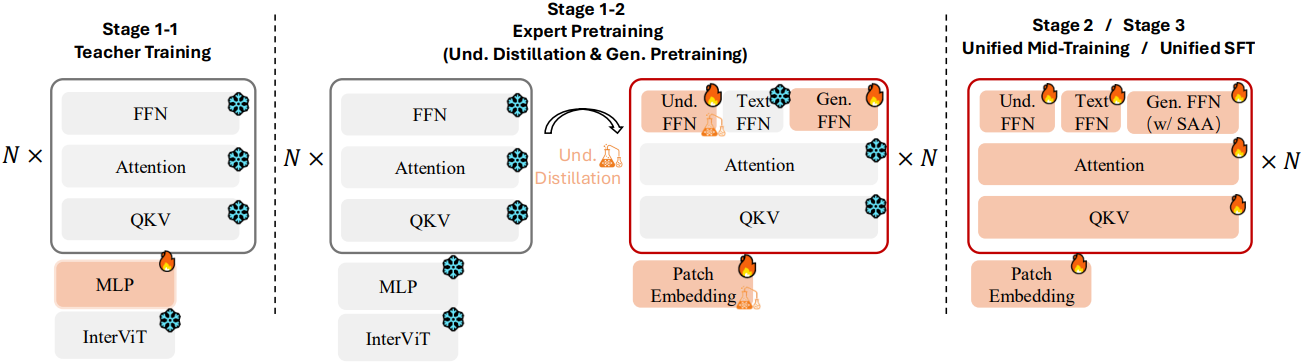
이 단계의 목표는 사전 학습된 LLM의 언어적 기능을 유지하면서 OneCAT에 기본적인 시각적 인식 및 생성 능력을 부여하는 것이다. 핵심 과제는 시각적 인식을 위해 Und. FFN이 LLM의 텍스트 기반 FFN 가중치를 기반으로 초기화된다는 점이다. 이러한 방식은 사전 학습된 비전 지식이 부족하여 학습 과정에 데이터 집약적인 부담을 초래한다. 이러한 한계를 해결하기 위해 MLLM teacher의 시각적 인식 능력을 활용하고, understanding distillation 전략을 도입하여 Und. FFN을 최적화함으로써 학습 효율을 크게 향상시킨다. 동시에 생성 사전 학습을 수행하여 Gen. FFN을 최적화한다.
Stage 1-1: Teacher Training
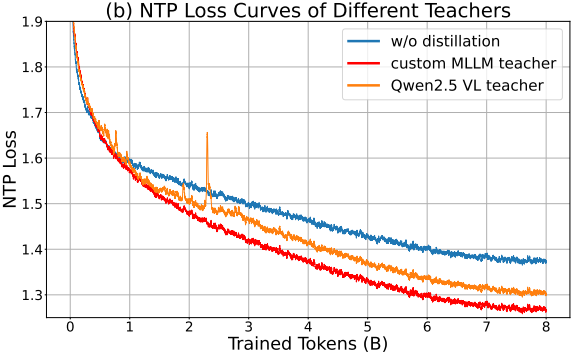
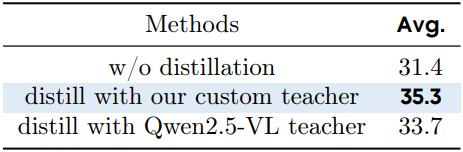
기존 MLLM을 teacher 모델로 사용하는 대신, teacher 모델과 student 모델의 LLM backbone 간 파라미터 일관성을 보장하도록 teacher 모델을 커스터마이징함으로써 distillation의 안정성과 효율성을 향상시켰다.
구체적으로, teacher 모델은 사전 학습된 InternViT와 Qwen2.5를 2-layer MLP로 연결하여 구성된다. 이때 ViT와 LLM은 모두 고정한 상태로 두고, 소규모 이미지-텍스트 캡션 데이터셋에서 NTP loss를 사용하여 MLP connector만 학습시킨다. 이러한 정렬 학습을 통해 맞춤형 MLLM teacher 모델은 강력한 시각적 인지 능력을 갖추게 된다.
Stage 1-2: Expert Pretraining
이어서 teacher 모델을 기반으로 OneCAT을 학습시킨다. 이때 QKV, attention, 텍스트 FFN은 고정하고, 시각적 이해를 위한 Und. FFN과 patch embedding layer, 시각적 생성을 위한 Gen. FFN만을 최적화한다.
Understanding Distillation
이미지-텍스트 쌍으로 구성된 대규모 데이터셋을 사용하여 Und. FFN을 최적화한다. 학습 loss는 cross-entropy loss인 NTP loss \(\mathcal{L}_\textrm{NTP}\)와 distillation loss \(\mathcal{L}_\textrm{Distill}\)을 결합한 형태이다.
($\lambda = 0.02$)
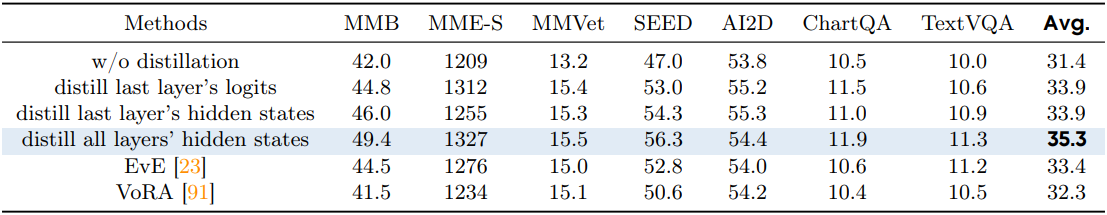
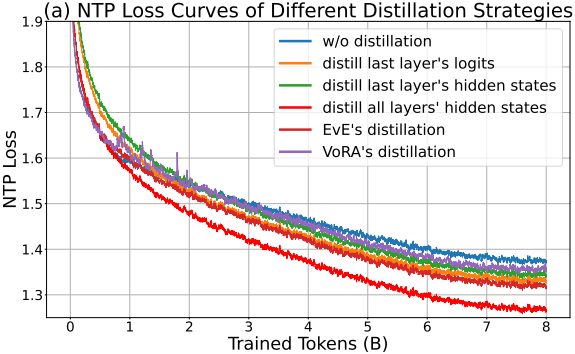
Distillation 과정에서는 최종 출력 logit을 일치시키는 대신, 각 transformer layer에서 student 모델의 hidden state \(\textbf{h}_S^{(n)}\)를 teacher 모델의 hidden state \(\textbf{h}_T^{(n)}\)와 정렬한다.
\[\begin{equation} \mathcal{L}_\textrm{Distill} = \sum_{n=1}^{N} \textrm{MSE} (\textbf{h}_S^{(n)}, \textbf{h}_T^{(n)}) \end{equation}\]이를 통해 student 모델은 teacher 모델의 최종 텍스트 예측 결과뿐만 아니라, 모든 토큰에 대한 내부 연산 패턴까지 모방하게 되어, 시각적 지식을 더욱 효과적으로 전달받을 수 있다. Distillation 과정 전반에 걸쳐, 모든 모델은 연산 부하와 visual feature의 세밀함 사이의 균형을 고려하여 448$\times$448의 고정된 해상도로 이미지를 처리한다.
Generation Pretraining
이와 병행하여, LLM이 공간적 관계와 스케일 사이의 의존성을 학습할 수 있도록 정교한 text-to-image 생성 데이터셋을 사용하여 Gen. FFN을 최적화한다. 또한 next scale prediction을 위해 cross-entropy loss를 도입하며, 출력 이미지 해상도는 256$\times$256으로 고정한다.
2. Stage-2: Unified Mid-Training
2단계에서는 전체 모델의 고정을 해제하고, 여러 task를 아우르는 통합적인 mid-training을 수행한다. 이 단계에서 SAA를 도입하여 다른 모듈들과 함께 최적화함으로써 특정 스케일에 맞는 표현을 추출하고 이미지 생성 품질을 향상시킨다.
또한, 이 단계에서는 원본 해상도 전략을 적용한다. 시각적 이해를 위해 모델이 이미지의 원본 해상도 그대로 처리하도록 학습시킴으로써, 미세한 디테일을 보존하고 정보 손실을 줄인다. 아울러, 전체적인 시각적 컨텍스트를 제공하기 위해 448$\times$448 해상도의 썸네일도 함께 활용한다.
생성의 경우, 288~864 범위 내에서 변의 길이를 샘플링하여 다양한 해상도와 종횡비로 모델을 학습시킴으로써, 생성의 범용성과 실제 환경에서의 적용 가능성을 높인다.
3. Stage-3: Unified Supervised Fine-tuning
마지막 단계에서는 instruction-following 능력과 생성 품질을 향상하기 위해, 엄선된 고품질 데이터셋을 활용한 통합 supervised fine-tuning (SFT)을 수행한다. 또한, 기존의 원본 해상도 전략을 유지하면서, 생성되는 이미지의 한 변의 길이가 288~1776인 이미지를 생성할 수 있도록 한다.
Experiments
1. Multimodal Understanding
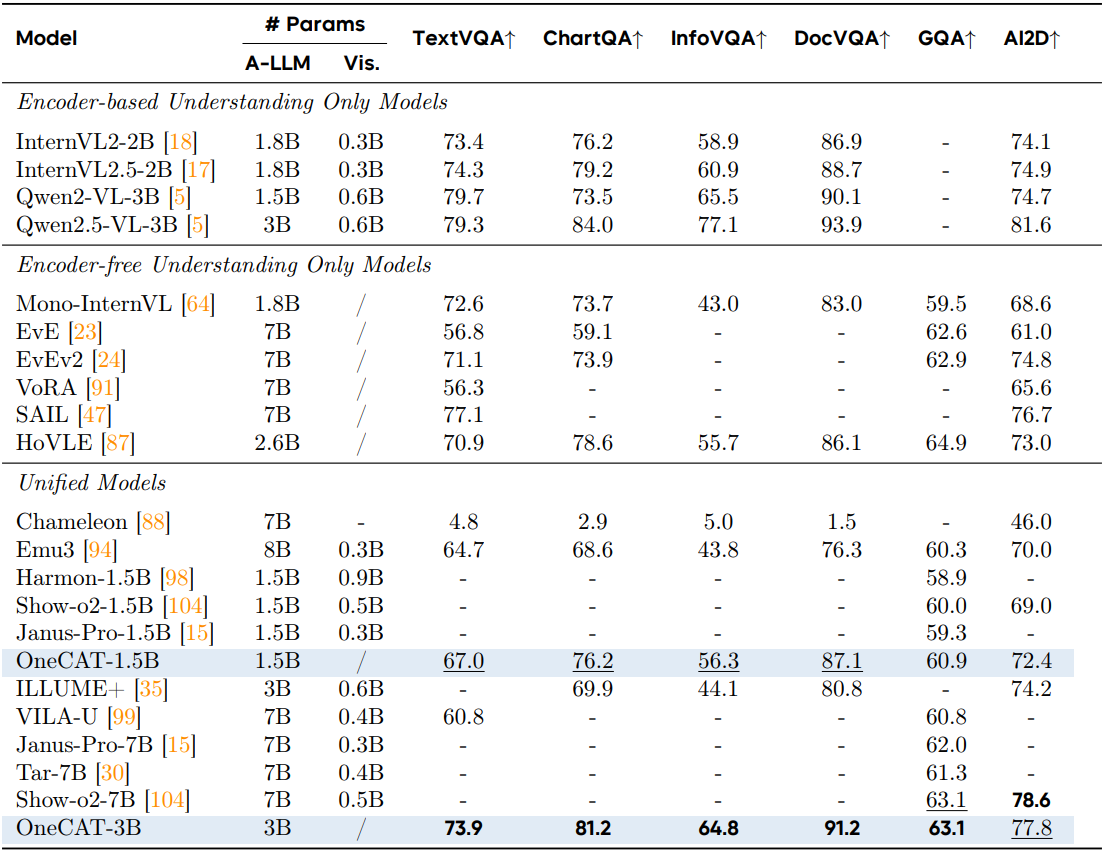
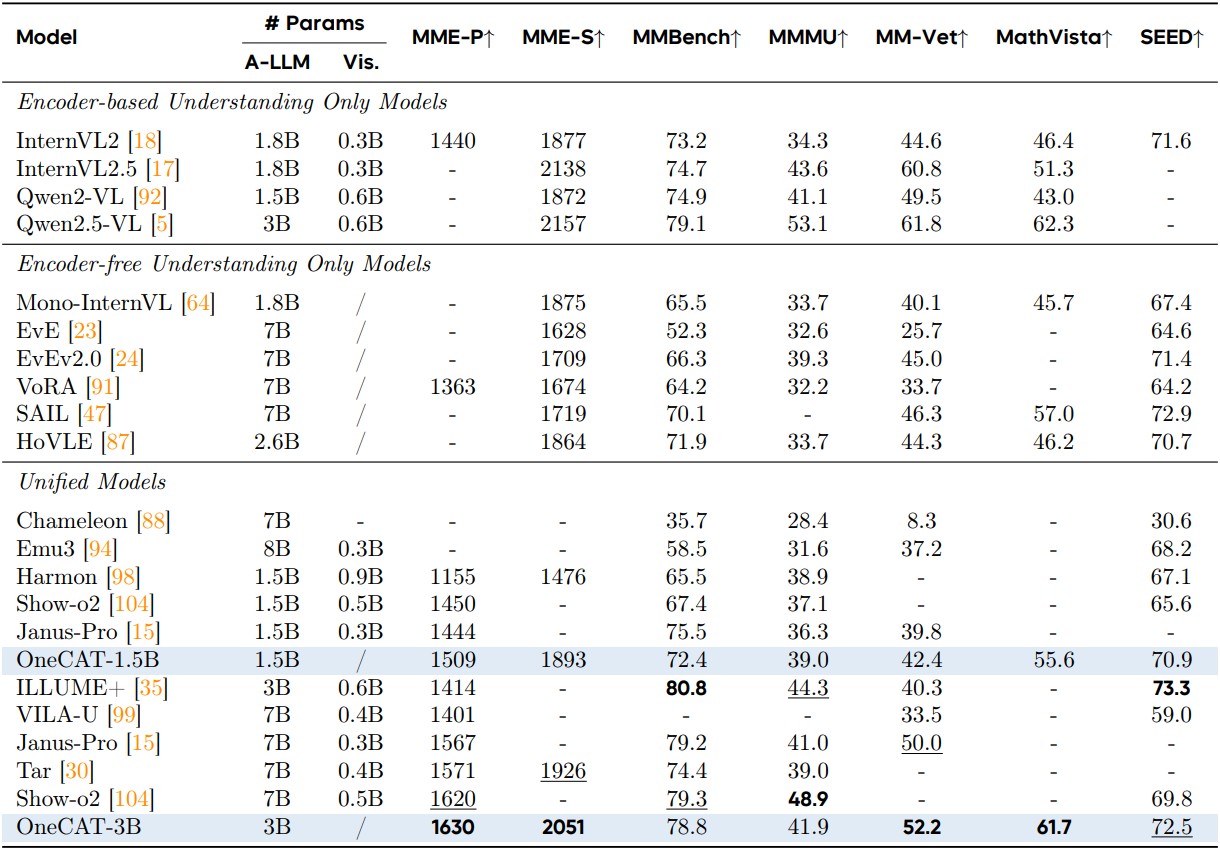
다음은 다양한 멀티모달 이해 벤치마크들에 대한 성능 비교 결과이다.
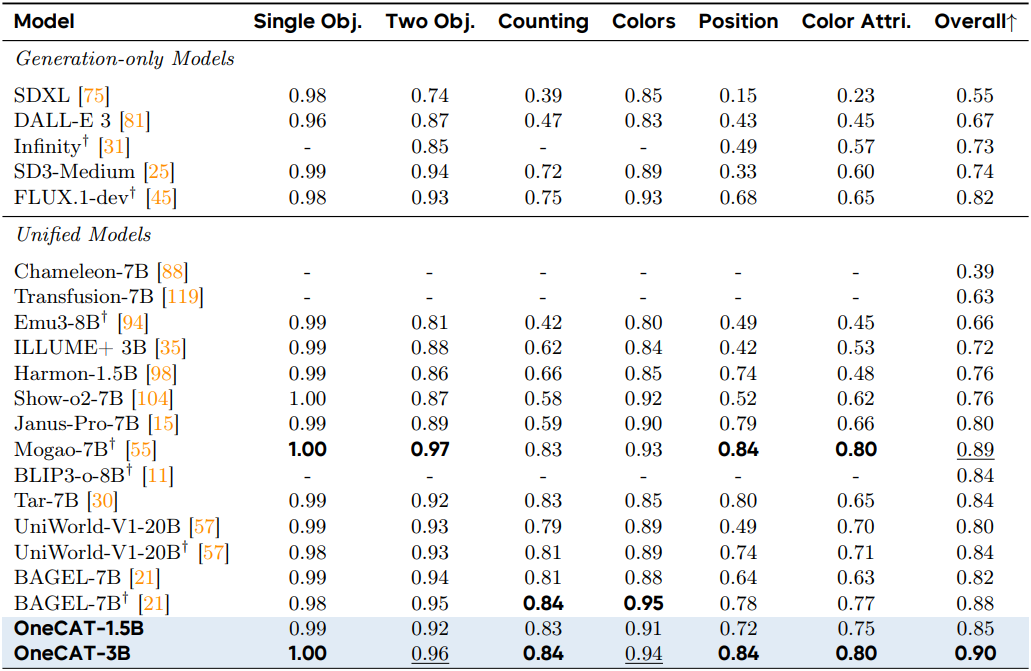
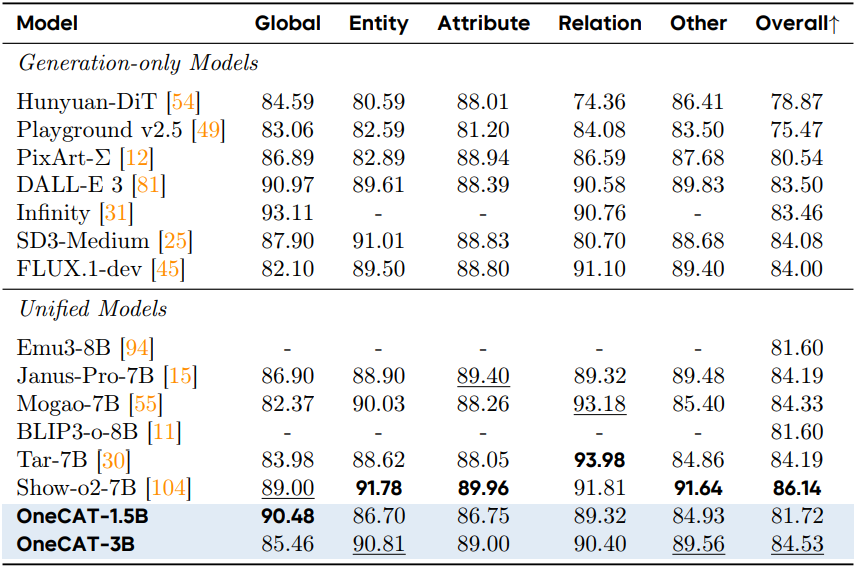
2. Text-to-Image
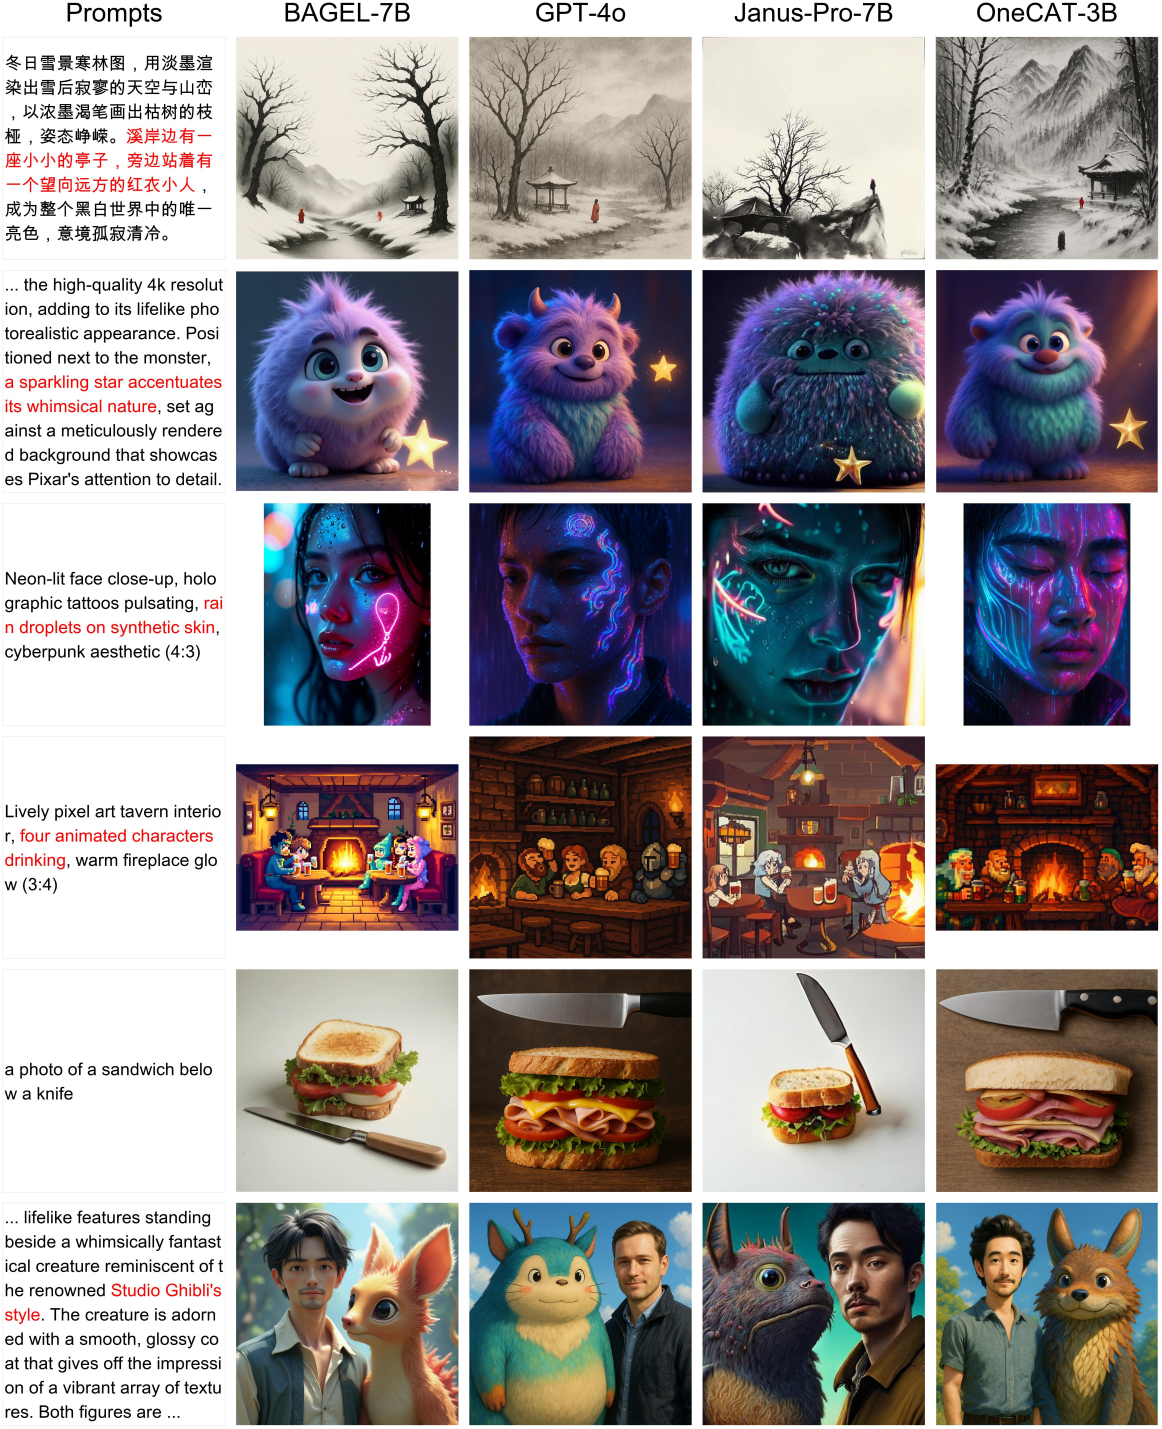
다음은 text-to-image 생성에 대한 비교 결과이다.
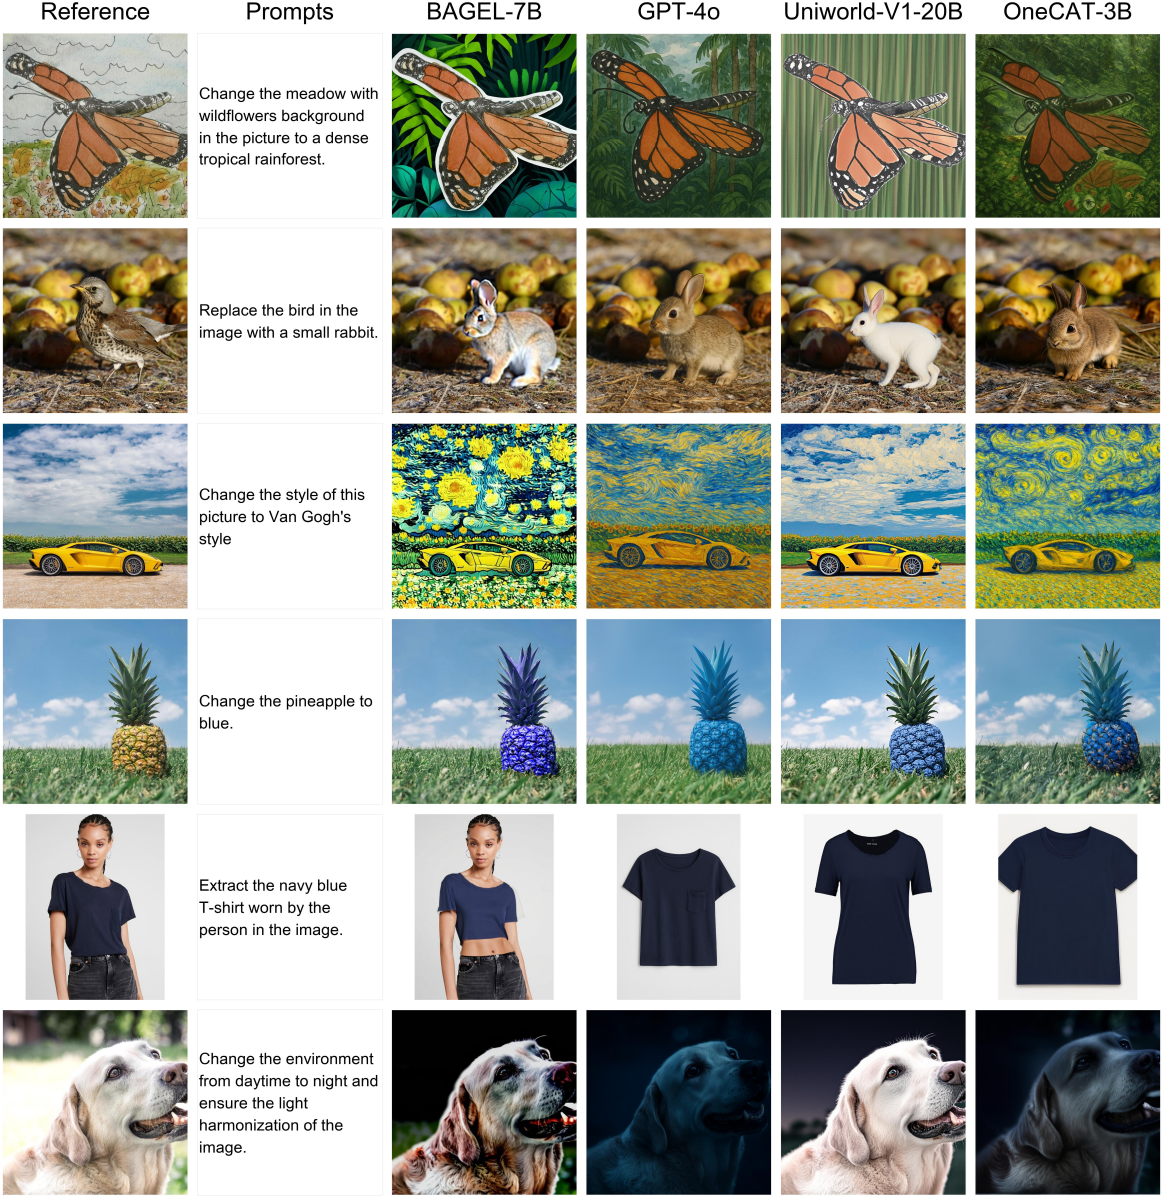
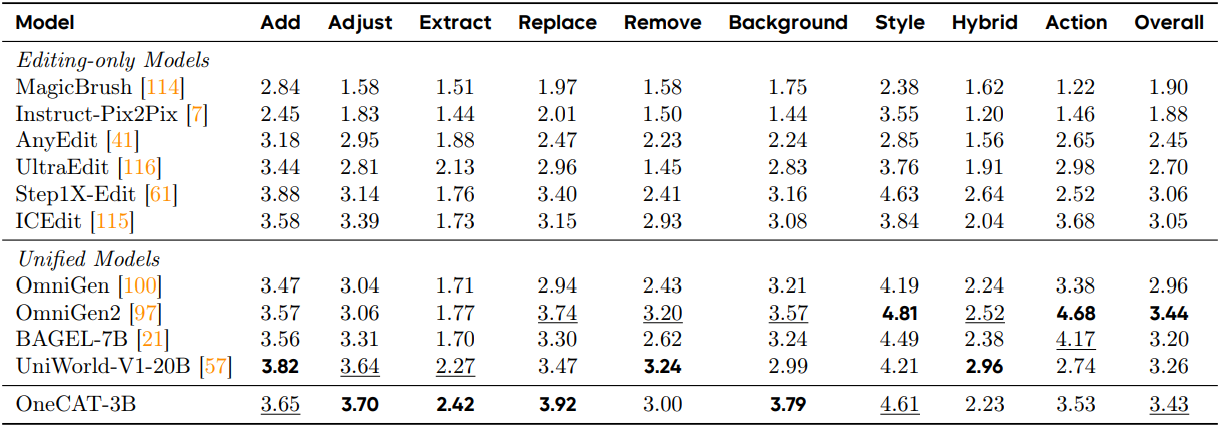
3. Image Editing
다음은 이미지 편집에 대한 비교 결과이다.
4. Inference Efficiency
다음은 (왼쪽) 이해와 (오른쪽) 생성에 대한 효율성 비교 결과이다.
5. Ablation Study
다음은 distillation 전략에 대한 비교 결과이다.
다음은 teacher 모델에 대한 비교 결과이다.
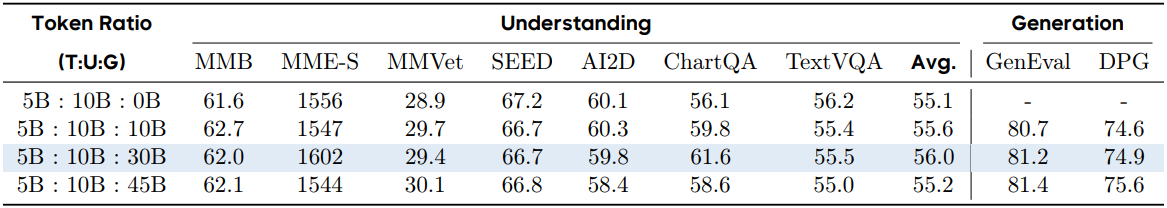
다음은 학습에 사용된 토큰 비율에 따른 성능 비교 결과이다. (T: text-only, U: understanding, G: generation)
다음은 SAA에 대한 ablation 결과이다.