[논문리뷰] GeoSAM2: Unleashing the Power of SAM2 for 3D Part Segmentation
CVPR 2026. [Paper] [Page] [Github]
Ken Deng, Yunhan Yang, Jingxiang Sun, Xihui Liu, Yebin Liu, Ding Liang, Yan-Pei Cao
VAST | The University of Hong Kong | Tsinghua University | Sun Yat-sen University
19 Aug 2025
Introduction
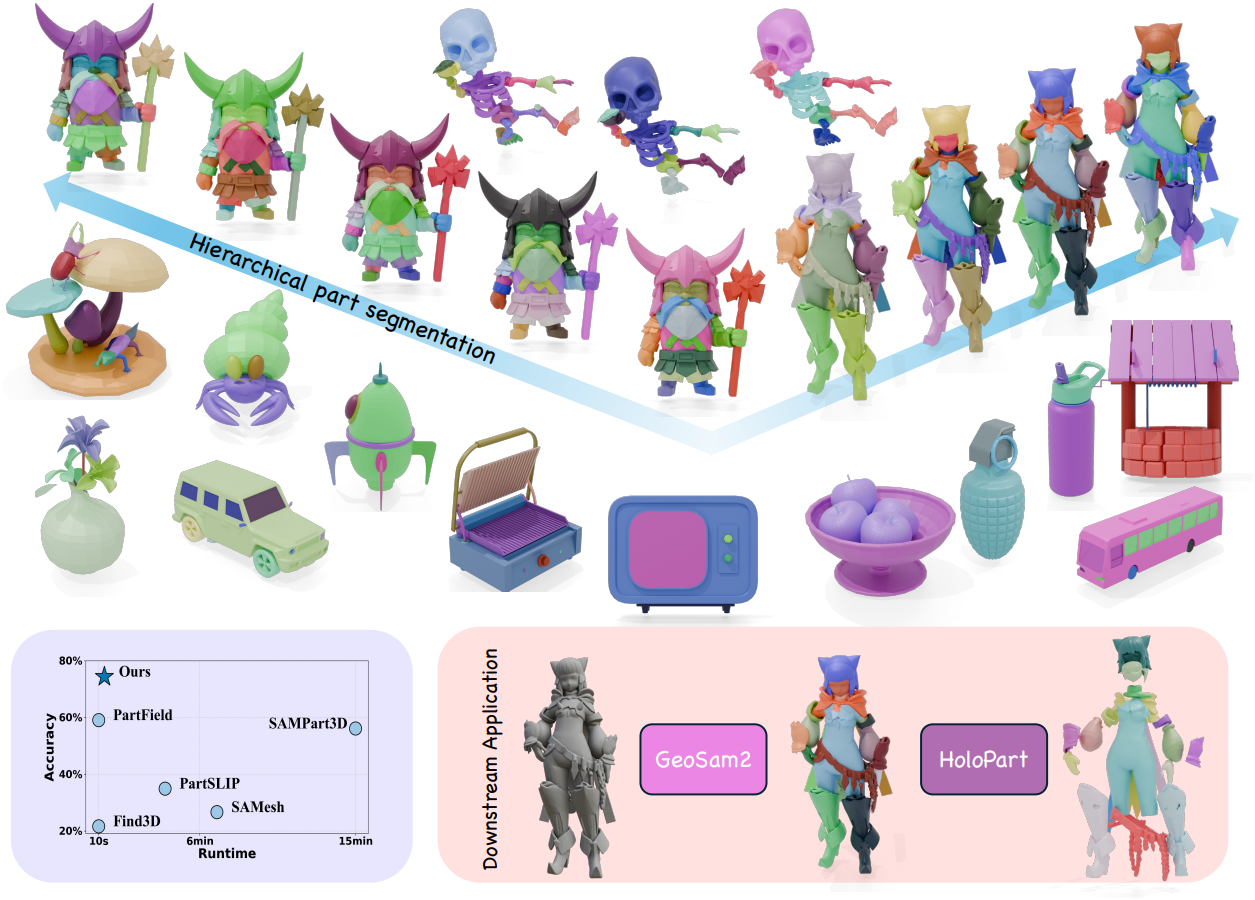
기존 3D part segmentation 방법들은 segmentation에 대한 제어가 간접적이고, coarse하게 이루어지며, 대부분의 파이프라인은 속도는 빠르지만 유연성이 부족하거나, 표현력은 뛰어나지만 속도가 느리다는 특징이 있다. 게다가 2D 상호작용과 3D part 결과물을 완전히 일치시키는 방법이 없어, 정확한 3D segmentation을 구현하는 데 있어 공백이 존재한다.
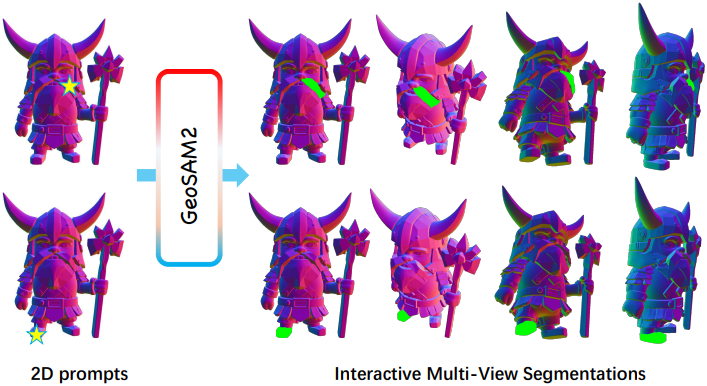
이러한 한계를 해결하기 위해, 본 논문은 텍스처가 없는 object에 대한 prompt-controllable 3D part segmentation 문제를 멀티뷰 2D 마스크 task로 재정의한다. 3D 모델 $\mathcal{M}$이 주어지면, 표준 뷰들에서 normal map과 point map을 렌더링하고, 사용자가 선택한 뷰에서 대상 part를 지정하는 간단한 2D 프롬프트(클릭 또는 박스)를 입력받는다.
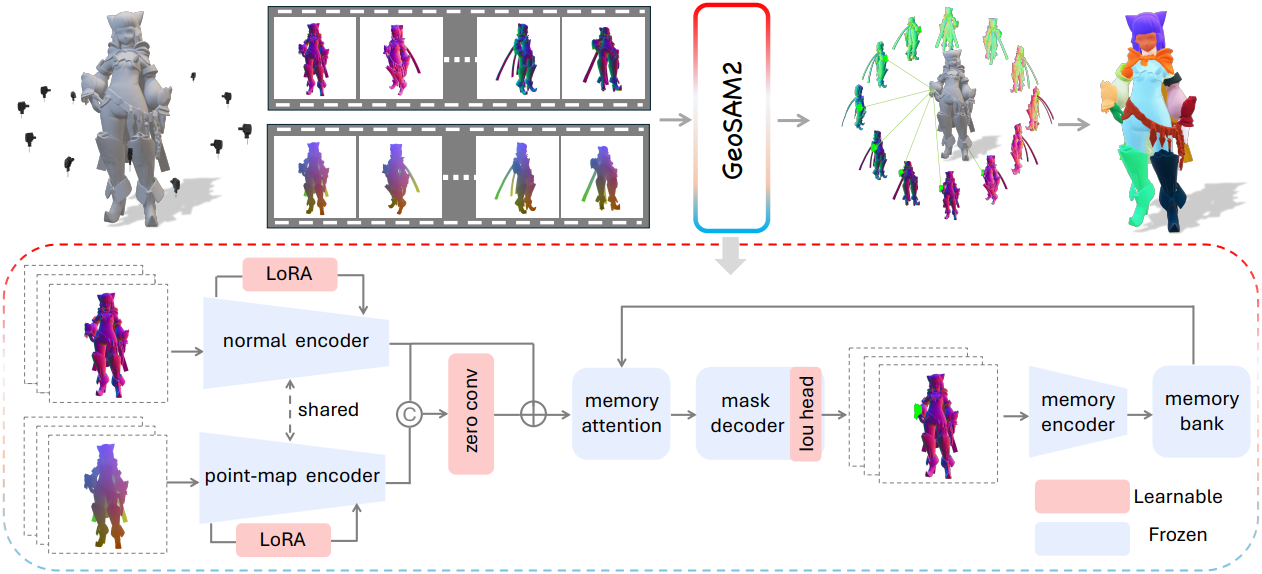
이러한 뷰-프롬프트 쌍은 LoRA를 적용한 공유 SAM2 backbone에 의해 처리되며, 네트워크의 대부분은 고정 상태로 유지하면서도 geometry 정보를 주입할 수 있다. 각 feature pyramid 레벨에서 0으로 초기화된 residual convolution이 normal map과 point map의 feature를 융합하며, 이를 통해 사전 학습된 RGB feature 통계를 보존하는 동시에 cross-modal 연관성을 점진적으로 학습한다. 뷰 간 일관성을 유지하기 위해 모든 뷰의 임베딩을 full-view memory bank에 저장한 다음, 각 시점의 마스크를 $\mathcal{M}$으로 back-projection한다.
경량화된 후처리 단계에서는 kNN 투표 방식을 통해 작은 component를 제거하고 part label을 매끄럽게 다듬는다. 3D label이 2D 마스크와 정확하게 정렬되므로, PartField와 달리 직관적이고 영역별로 세밀한 제어가 가능할 뿐만 아니라, 모든 face에 part label을 할당할 필요 없이 완전 레이블링된 데이터셋과 부분적으로만 레이블링된 데이터셋 모두에서 더 높은 정확도를 달성할 수 있다.
Method
본 논문은 텍스처가 없는 3D 모델의 part segmentation 문제를 멀티뷰 segmentation으로 정의하여 해결한다. 3D 모델 $\mathcal{M}$이 주어지면, 미리 정의된 카메라 포즈 \(\{P_i\}_{i=1}^N\)를 사용하여 일련의 normal map \(\{I_i\}_{i=1}^N\)과 point map \(\{\Pi_i\}_{i=1}^N\)을 렌더링함으로써 다양한 뷰에서 geometry 디테일을 포착한다. 구체적으로, 메쉬를 중심으로 시점을 반시계 방향으로 배치하여 이러한 멀티뷰 렌더링 결과물을 12프레임의 동영상 형태로 구성한다. 각 이미지 $I_i$는 geometry 정보를 통합하여 픽셀 단위의 part mask \(\{M_i\}_{i=1}^N\)을 예측하는 비전 모델 $\mathcal{F}$에 의해 처리된다.
뷰 간 일관성을 보장하기 위해, 서로 다른 시점의 마스크 $M_i$를 추적하고 연관시켜 일관된 part label을 유지하는 메모리 메커니즘 $\mathcal{T}$를 활용한다. 이후 통합된 멀티뷰 마스크는 렌더링 변환의 역과정을 통해 모델 표면 $\mathcal{M}$으로 다시 projection되어 초기 3D part segmentation 결과를 생성한다. 마지막으로, 후처리 단계 $\mathcal{P}$를 통해 경계를 매끄럽게 다듬고 불일치하는 부분을 수정함으로써 part segmentation 결과를 정교화한다.
1. Geometry-Aware Encoding with Low-Rank Adaptation
LoRA 기반 geometry-aware 인코더
SAM2는 RGB 도메인에서 학습되어 마스크 예측에서 우수한 성능을 보이지만, 텍스처가 없는 3D object의 멀티뷰 segmentation에 적용하는 것은 상당한 어려움을 수반한다. 핵심 문제는 SAM2가 RGB 기반 외형 단서에 의존한다는 점인데, 텍스처가 없는 렌더링에서는 이러한 단서가 존재하지 않는다. 또한, 동영상과 달리 멀티뷰 렌더링은 큰 시점 변화와 복잡한 occlusion을 보여 뷰 간 정확한 대응 관계를 설정하기 어렵게 만든다.
이러한 한계를 해결하기 위해, normal map과 point map에서 파생된 geometry-aware feature를 통해 geometry를 모델에 직접 주입한다. 카메라 포즈 $P_i$에서 렌더링된 normal map $I_i$가 주어지면, 카메라 파라미터를 사용하여 depth map을 3D로 back-projection하여 얻은 해당 point map \(\Pi_i\)와 쌍을 이룬다. 이렇게 하면 각 픽셀이 월드 좌표계에서 3D 좌표를 갖게 된다.
\[\begin{equation} \textbf{x}_i (u,v) = D_i (u,v) \cdot K^{-1} [u,v,1]^\top R_i^{-1} - R_i^{-1} \textbf{t}_i \end{equation}\]($D_i$는 $\mathcal{M}$으로부터 렌더링된 depth map, $(u,v)$는 픽셀 좌표, \((R_i, \textbf{t}_i)\)는 $P_i$에 대응하는 카메라 extrinsic)
결과물인 point map \(\Pi_i\)는 뷰 간의 모호성을 해결하고 대응 관계를 추론하는 데 도움이 되는 공간 구조 정보를 담고 있다.
그러나 RGB에서 normal map과 point map으로 적응하도록 전체 모델 $\mathcal{F}$를 직접 학습시키는 것은 연산 효율성이 떨어진다. 따라서 저자들은 LoRA 방식을 채택하였다. 구체적으로, normal map과 point map을 위해 각각 독립적인 두 개의 LoRA branch를 구성하였다. 가중치 $W_0 \in \mathbb{R}^{m \times n}$를 갖는 $\mathcal{F}$ 내의 임의의 linear projection layer에 대해, 학습 가능한 행렬 $A \in \mathbb{R}^{m \times r}$와 $B \in \mathbb{R}^{r \times n}$을 도입하여 적응된 가중치가 다음과 같이 되도록 한다.
\[\begin{equation} W = W_0 + AB, \quad r \ll \min (m,n) \end{equation}\]따라서 입력 벡터 $\textbf{f}$에 대한 출력은 다음과 같다.
\[\begin{equation} W \textbf{f} = W_0 \textbf{f} + A (B \textbf{f}) \end{equation}\]이때 $W_0$는 고정된 상태로 유지된다. 각 transformer block에 LoRA layer를 주입하는 것만으로도 $\mathcal{F}$가 geometry 정보에서 파생된 모달리티를 효과적으로 처리하도록 유도하기에 충분하다.
Normal map feature와 point map feature의 residual fusion
Normal map feature는 RGB 텍스처와 더 밀접하게 정렬되어 있어 SAM2 backbone의 사전 학습된 통계와 더 잘 일치한다. 반면, point map feature는 강력한 기하학적 단서를 제공하지만, 단순하게 융합할 경우 분포 왜곡을 유발할 수 있다. 이러한 두 가지 특성의 균형을 맞추기 위해, 보수적으로 초기화하고 점진적으로 적응하는 residual fusion 전략을 사용한다.
Feature pyramid의 각 해상도 단계에서, normal map feature $G_i \in \mathbb{R}^{H \times W \times C}$와 point map feature $P_i \in \mathbb{R}^{H \times W \times C}$가 주어지면, 이들은 먼저 채널 축을 따라 concat된다.
\[\begin{equation} X_i = [G_i \; \| \; P_i] \in \mathbb{R}^{H \times W \times 2C} \end{equation}\]그리고 가중치가 0으로 초기화된 3$\times$3 convolution layer를 통과한다.
\[\begin{equation} Y_i = \textrm{Conv}_{3 \times 3} (X_i; W = 0) \in \mathbb{R}^{H \times W \times C} \end{equation}\]그런 다음, 그 결과를 원래의 normal feature에 다시 더하여 residual connection을 적용한다.
\[\begin{equation} \hat{G}_i = G_i + Y_i \end{equation}\]Convolution이 0인 가중치로 시작하기 때문에 초기 출력 $Y_i$는 정확히 0이 되며, 학습 초기 단계에서 네트워크는 오직 normal map feature에만 의존하게 된다. 이는 feature 분포의 급격한 변화를 방지하고, gradient를 통해 point map branch의 기여도가 점진적으로 형성되도록 한다. 동일한 융합 전략이 FPN의 각 해상도 레벨에 독립적으로 적용된다.
2. Redesigning Memory Mechanism for Viewpoint-Aware Segmentation
SAM2는 원래 동영상 segmentation을 위해 설계되었으며, 최근 프레임의 feature를 유지하고 시간적 일관성을 유지하기 위해 고정 크기의 memory bank를 사용한다. 그러나 이러한 설계는 중복 정보와 인접 프레임 간의 부드러운 전환을 가정하는데, 이는 멀티뷰 3D segmentation에서는 성립하지 않는 조건이다. 멀티뷰 환경에서는 각 입력 시점이 고유한 공간적 단서와 다양한 geometry feature를 가지고 있다. 따라서 SAM2의 FIFO 메모리 메커니즘을 사용하여 이전 시점을 버리면 돌이킬 수 없는 정보 손실이 발생하고 segmentation 정확도와 일관성이 저하될 수 있다.
멀티뷰 메모리 유지
저자들은 이러한 한계를 극복하기 위해, 시퀀스 전반에 걸쳐 모든 시점의 feature를 유지하는 방식으로 메모리 메커니즘을 재구성하였다. 구체적으로, 각 object를 방위각 기준으로는 90° 간격으로, 고도각 기준으로는 25°, 0°, -25°에 걸쳐 배치된 12개의 표준 시점에서 렌더링한다. 이러한 배치는 포괄적인 geometry 정보를 확보하게 하며, 모델이 이전에 접한 모든 시점을 참조하여 occlusion이나 object part의 경계를 효과적으로 추론할 수 있도록 한다.
프레임 반복을 통한 메모리 부트스트래핑
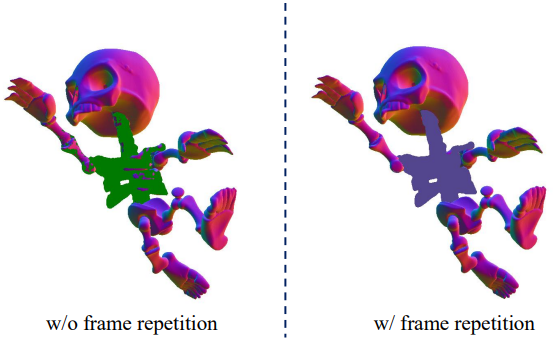
메모리를 유지함에도, SAM2는 초기 memory bank가 비어 있고 sparse한 프롬프트(점, bounding box)에만 의존해야 하기 때문에 시퀀스의 첫 번째 프레임에서 낮은 segmentation 품질을 보인다. 흥미롭게도 메모리가 채워지면 segmentation 품질이 현저히 향상되는데, 이는 memory bank가 시간적 일관성 메커니즘일 뿐만 아니라 암묵적인 guidance 역할을 한다는 것을 시사한다.
이러한 통찰력에 착안하여, 처리 시작 전에 첫 번째 프레임을 복제하는 간단하면서도 효과적인 부트스트래핑 전략을 사용한다. 이 복제는 즉각적이고 의미 있는 메모리 prior를 제공하여 초기 segmentation 품질을 크게 향상시키고, 이후 뷰에서 더욱 선명하고 일관된 마스크를 생성한다.
3. Post-Processing Refinement
앞선 단계들을 통해 이미 고품질의 멀티뷰 마스크를 얻을 수 있으며, 이를 3D 모델로 back-projection하여 3D 마스크를 손쉽게 생성할 수 있다. 특히 메쉬 형태의 3D 모델의 경우, 메쉬의 연결성(connectivity)을 활용하여 마스크를 후처리할 수 있다. 본 논문에서는 SAMesh에서 착안하여 새로운 후처리 방식을 제안하였다.
- 면적이 $A_\textrm{mesh} = PA_\textrm{mesh} \times N_\textrm{faces}$ 미만인 component를 제거 (ex. $PA_\textrm{mesh} = 0.01$)
- 메쉬 라벨을 smoothing한다. 연결성을 기반으로 한 face label의 반복적 smoothing은 시간이 많이 소요되므로 선택 사항으로 두되, 모든 face가 label을 갖도록 보장하기 위해 kNN 방식을 사용하여 나머지 face들에 대한 label을 결정한다.
Experiments
- 구현 디테일
- LoRA rank = 4
- 대부분의 SAM2 파라미터를 고정
- 모든 Q, K, V attention layer들에 대한 2개의 LoRA 모듈과 feature fusion block만 학습
- feature fusion block은 convolution layer 3개로 구성 (kernel size 3)
- 추가로 prediction head를 함께 학습
- 80 epochs, batch size 8, learning rate $5 \times 10^{-5}$
- SAM2와 동일한 loss 사용
- GPU: A800 8개
1. Comparison
다음은 PartObjaverse-Tiny에서의 비교 결과이다.
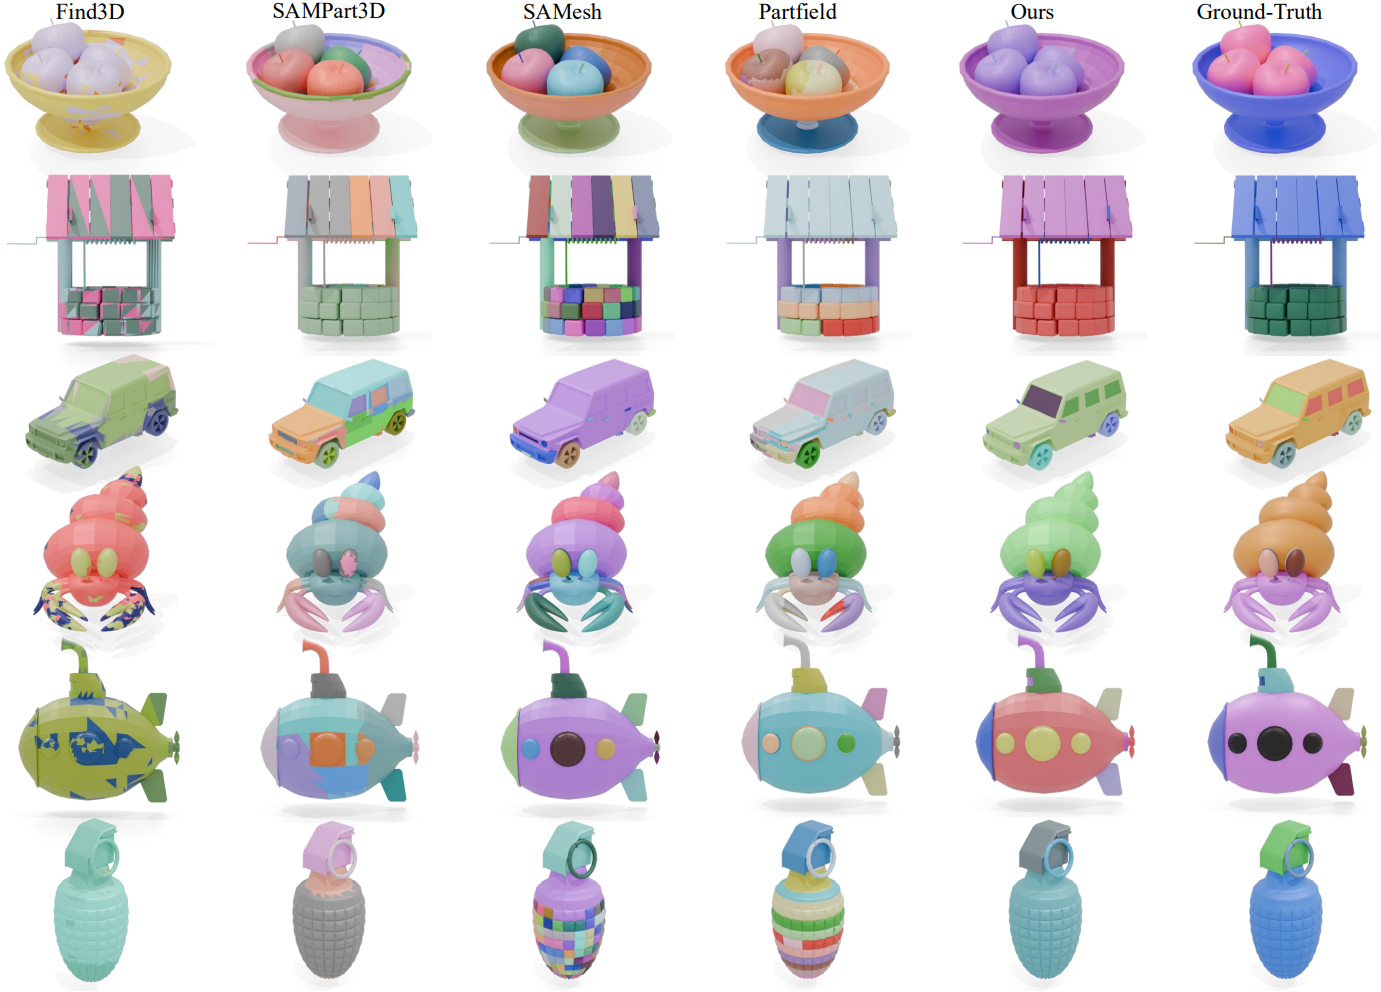
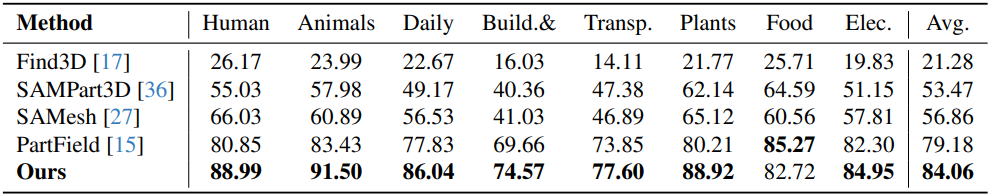
다음은 PartNetE에서의 비교 결과이다.
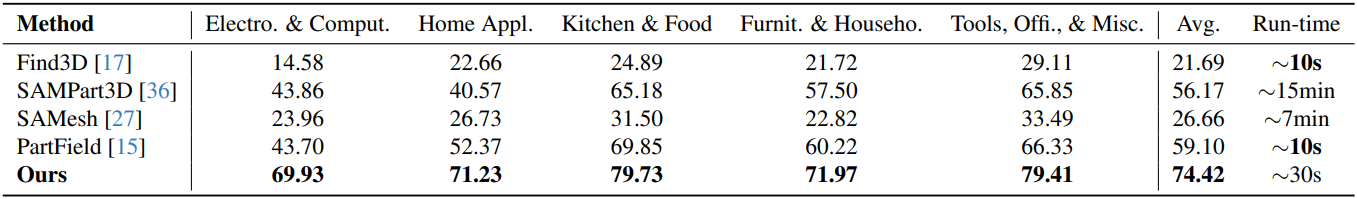
2. Generalization to Generative Model
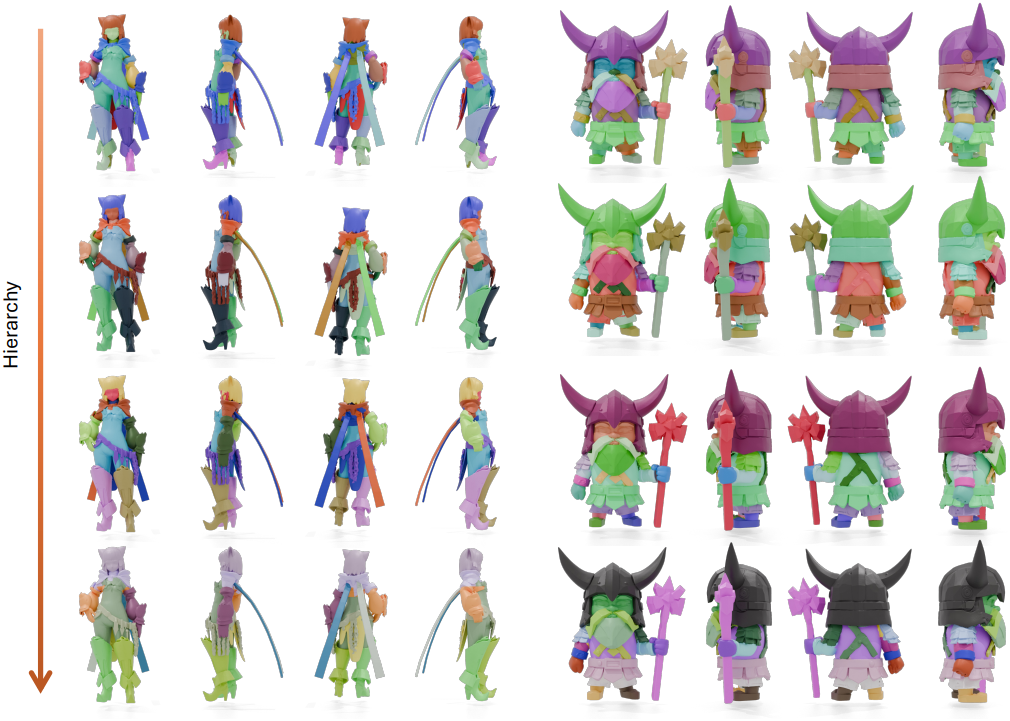
다음은 3D 생성 모델이 만든 geometry를 계층적으로 segmentation한 결과이다.
3. Ablation Study
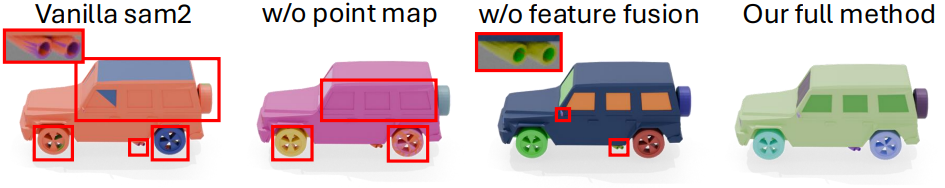
다음은 ablation study 결과이다.
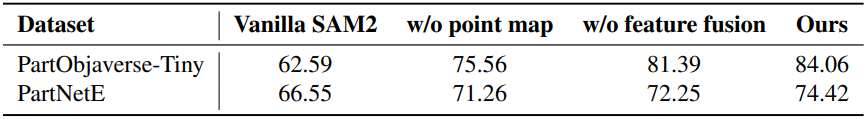
다음은 프레임 반복에 대한 ablation study 결과이다.
4. Application
다음은 GeoSAM2 결과에 zero-shot 3D part completion 모델을 적용하여 amodal segmentation을 수행한 예시이다.
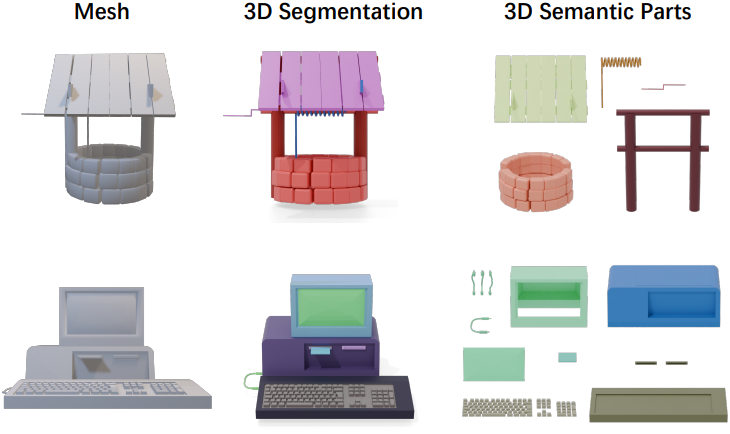
다음은 주어진 2D 프롬프트로 3D part를 segmentation하는 예시이다.