[논문리뷰] SRPO: Self-Referential Policy Optimization for Vision-Language-Action Models
CVPR 2026. [Paper] [Github]
Senyu Fei, Siyin Wang, Li Ji, Ao Li, Shiduo Zhang, Liming Liu, Jinlong Hou, Jingjing Gong, Xianzhong Zhao, Xipeng Qiu
Fudan University | Tongji University | Shanghai Innovation Institute
19 Nov 2025
Introduction
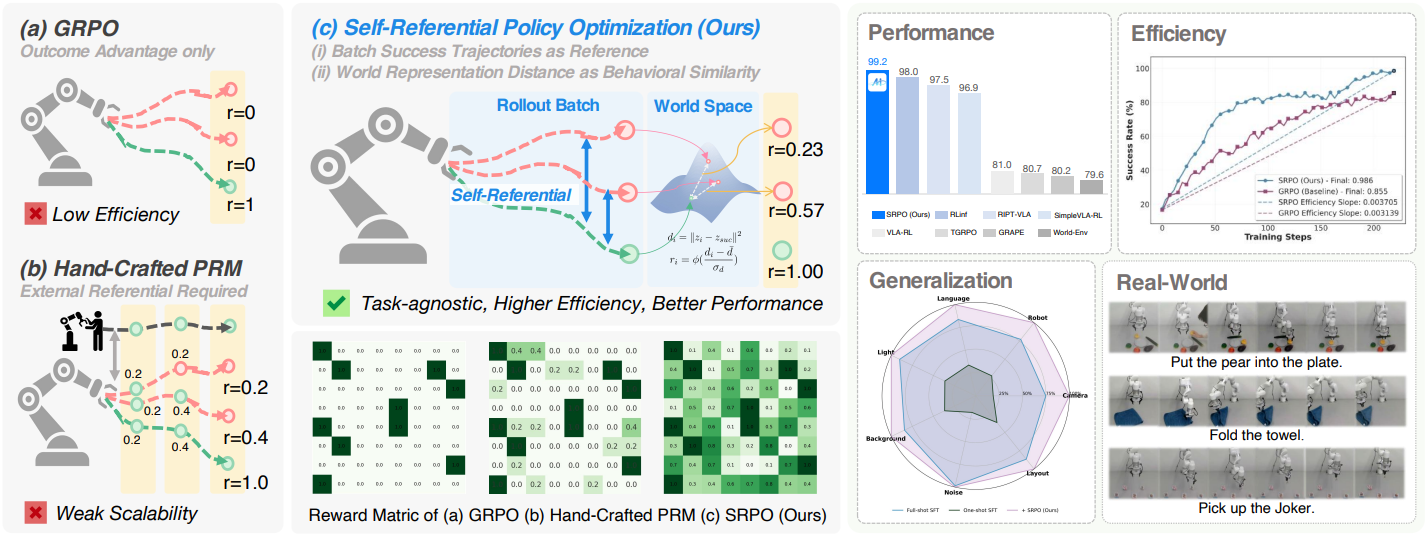
GRPO는 놀라운 발전을 이루었음에도 불구하고, reward 신호의 sparsity 문제에 여전히 직면해 있다. 이 문제는 특히 VLA 도메인에서 두드러지는데, 궤적 생성에 필요한 계산 비용이 상당히 높고, 실패한 궤적에서 얻은 정보를 제대로 활용하지 못해 학습 효율이 크게 떨어지기 때문이다. 더 dense한 피드백을 제공하기 위한 방식들은 일반적으로 전문가의 시연이나 수작업으로 만든 task decomposition에 의존하여 중간 진행 단계를 정의해야 하므로 자율 학습의 목표와 상반되는 scalability의 한계를 초래한다.
Reward sparsity 문제를 해결하기 위해, 본 논문은 모델 자신의 성공한 궤적을 레퍼런스로 삼아 실패한 시도를 평가하고 가이드하는 self-referential learning을 제안하였다. GRPO가 advantage 추정을 위해 결과 기반 reward만을 활용하는 반면, 본 논문의 접근 방식은 궤적 batch 전체를 보다 효율적으로 활용한다.
이 패러다임의 핵심 과제는 task 완료를 향한 진행 상황을 평가하기 위해 성공한 궤적과 실패한 궤적 간의 행동적 유사성을 정량적으로 측정하는 것이다. 궤적은 시각적 관찰에만 의존하기 때문에, 진행 상황을 측정하기 위해서는 글로벌한 state 정보를 추출할 수 있는 reward 모델이 필요하다. World model은 이러한 역학을 모델링하는 데 자연스러운 접근 방식을 제공하지만, 기존의 pixel-level world model은 도메인 간 일반화 성능이 떨어지거나 일반적으로 광범위한 task별 fine-tuning이 필요하다는 단점이 있다.
본 논문에서는 world model이 학습한 latent 표현을 활용하여 이러한 한계를 해결하였다. 이러한 latent 표현은 다양한 환경에서의 행동 진행 패턴을 자연스럽게 포착한다. 이를 통해 정확한 환경 재구성이나 도메인별 학습 없이도 robust한 궤적 비교가 가능하다.
저자들은 이러한 통찰을 바탕으로, RL 학습 구조에 self-referential learning을 유기적으로 통합한 Self-Referential Policy Optimization (SRPO)를 제안하였다. 각 학습 iteration에서 batch 내의 성공한 궤적을 식별하여 world model의 latent 표현을 통해 레퍼런스 대상으로 활용하는 한편, 실패한 궤적에 대해서는 성공한 패턴과의 행동적 일치도에 기반한 단계별 reward를 부여한다. 저자들은 세밀한 reward 설계 대신 궤적 단위의 reward를 채택했다.
Method
1. Problem Formulation and Key Components
Timestep $t$에서의 현재 관측값 $o_t$와 목표 설명 $l$이 주어지면, 에이전트는 $l$을 조건으로 하는 policy \(\pi_\theta (a_t \vert o_t, l)\)에 따라 action $a_t$를 취한다. 이후 에이전트는 환경으로부터 다음 관측값 $o_{t+1}$을 받는 과정을 반복하다가, 마침내 종료 관측값 $o_T$를 받게 된다. 에이전트가 $l$에 명시된 task를 성공적으로 완수하면 양의 reward를 받으며, 그렇지 않은 경우에는 task 완수에 얼마나 근접했는지에 따라 reward를 받는다. 이 과정의 목표는 다양한 목표 $l$과 환경의 초기 state $\textbf{z}$에 대해 시간에 걸쳐 얻는 reward를 최대화하는 policy를 학습하는 것이다.
Observation function은 $o_t \leftarrow O(z_t)$로 정의되는데, 여기서 $O$는 environment state $z_t$를 에이전트가 받는 부분 관측 $o_t$로 매핑하는 함수이다. Action 생성은 policy 함수 \(\pi_\theta (a_t \vert o_t, l)\)로 모델링되며, 이는 현재 관측 $o_t$와 목표 설명 $l$이 주어졌을 때 action에 대한 확률 분포를 나타낸다. Environment function \(z_{t+1} \sim E(\cdot \vert z_t, a_t)\)는 에이전트가 취한 action $a_t$를 바탕으로 현재 environment state $z_t$에서 다음 environment state $z_{t+1}$로의 확률적 전이를 정의한다.
Trajectory rollout은 초기 environment state $z_0$에서 시작하여 시간에 따른 관측 및 action의 시퀀스를 생성하는 과정이다. 궤적 \(\{(z_0, o_0, a_0, z_1, o_1, a_1, \ldots, z_T, o_T)\}\)는 다음과 같이 함수들을 반복적으로 적용하여 생성된다.
\[\begin{equation} o_t = O(z_t), \quad a_t \sim \pi_\theta (\cdot \vert o_t, l), \quad z_{t+1} \sim E(\cdot \vert z_t, a_t) \end{equation}\]에이전트는 environment state $z_t$에 직접 접근할 수 없으며, 대신 observation function $O$를 통해 $z_t$로부터 도출된 관측값 $o_t$에 의존한다.
Reward function $R(z_{0:T}, l)$은 state 궤적이 목표 $l$을 달성하는 데 있어 얼마나 잘 수행되었는지를 평가한다. 이러한 reward는 통상적으로 에피소드가 종료될 때 $l$에 기술된 목표가 달성되었는지 여부에 따라 environment로부터 주어진다. 그러나 이러한 reward는 0 또는 1로 sparse하게 제공될 수 있어, 에이전트가 기존의 RL 방법으로 효과적인 policy를 학습하기 어렵게 만들 수 있다. 이를 해결하기 위해, 본 논문에서는 world model을 활용하여 실패한 궤적에 대한 reward를 설계함으로써 학습 과정에서 더 유익한 피드백을 제공하였다.
2. World progress reward modeling
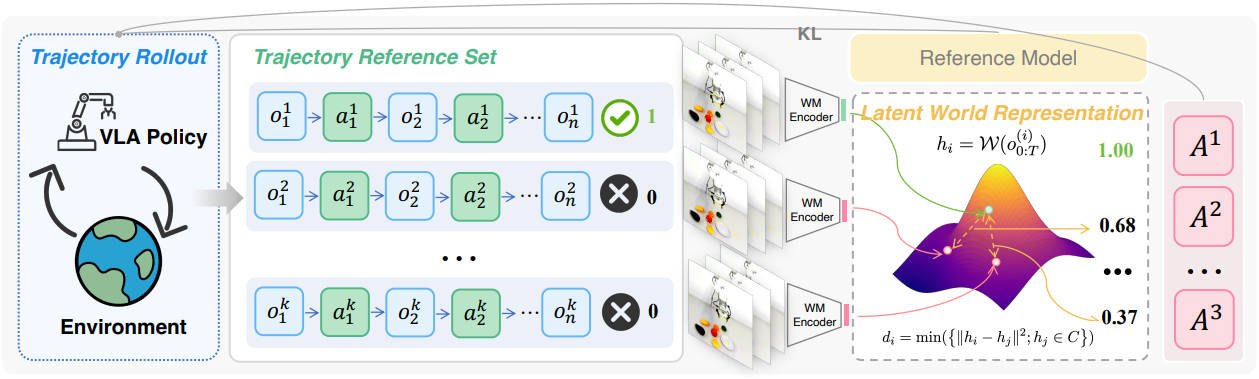
에이전트는 state $z_{0:T}$나 reward function $R(z_{0:T}, l)$에 직접 접근할 수 없다. 각 에피소드가 끝날 때 제공되는 sparse한 최종 reward 신호만이 존재할 뿐이다. 본 논문에서는 실패한 rollout 궤적에 대해서도 진행 상황을 반영한 신호를 제공하기 위해, world model에 기반한 task 독립적인 reward 설계 메커니즘을 제안하였다. 이때 reward \(g (o_{0:T}, \mathcal{S})\)는 성공한 궤적들의 관측값 집합 \(\mathcal{S} = \{o_{0:T}^{(i)} \mid R(z_{0:T}^{(i)}, l) = 1, \forall i\}\)을 기반으로 설계된다.
먼저, 실패한 궤적과 성공한 레퍼런스 궤적의 관측값을 world model 인코더 $\mathcal{W}$를 사용하여 인코딩한다.
\[\begin{equation} h_i = \mathcal{W} (o_{0:T}^{(i)}) \end{equation}\]그런 다음 DBSCAN 알고리즘을 사용하여 성공한 궤적의 표현들을 클러스터링함으로써 대표 중심점들의 집합을 얻는다. 이후 가장 가까운 중심점 표현까지의 거리를 계산하는데, 거리가 짧을수록 더 큰 reward를 의미한다.
\[\begin{aligned} C &= \textrm{DBSCAN} (\mathcal{S}) \\ d_i &= \min_{h_j \in C} (\| h_i - h_j \|^2) \end{aligned}\]Reward는 다음과 같이 계산된다.
\[\begin{equation} g_i = \begin{cases} 1.0 & \textrm{for success trajectory} \\ \phi \left( \frac{d_i - \bar{d}}{\sigma_d} \right) & \textrm{for failed trajectory} \end{cases} \end{equation}\]($\phi(\cdot)$는 출력을 (0, 1) 범위로 변환하는 activation function, $\bar{d}$와 \(\sigma_d\)는 실패한 모든 궤적에 대해 계산된 거리의 평균과 표준편차)
3. Self-Referential Policy Optimization
본 논문은 latent world 표현을 활용하여 궤적 수준에서의 자기 참조적 advantage 추정을 가능하게 하는 VLA 모델용 새로운 policy 최적화 프레임워크인 Self-Referential Policy Optimization (SRPO)를 도입하였다.
Probability ratio, advantage, 정규화 항은 GRPO를 따라 다음과 같다.
\[\begin{equation} r_{i,t} (\theta) = \frac{\pi_\theta (a_t^{(i)} \vert o_t^{(i)}, l)}{\pi_{\theta_\textrm{old}} (a_t^{(i)} \vert o_t^{(i)}, l)}, \quad \hat{A}_i = \frac{g_i - \mu_g}{\sigma_g}, \quad \omega (\theta) = \beta D_\textrm{KL} \left( \pi_\theta \; \| \; \pi_\textrm{ref} \right) \end{equation}\]Clipped surrogate objective는 다음과 같다.
\[\begin{equation} \mathcal{L}_{t,i}^\textrm{CLIP} (\theta) = \min (r_{i,t} (\theta) \hat{A}_i, \textrm{clip} (r_{i,t} (\theta), 1 - \epsilon, 1 + \epsilon) \hat{A}_i) \end{equation}\]최대화하고자 하는 SRPO objective는 \(\mathcal{L}_{t,i}^\textrm{CLIP}\)의 기댓값으로 정의된다. 이 기댓값은 현재 학습 그룹 내의 timestep $t$와 샘플 ID $i$에 대해 계산되며, 파라미터 $\theta$에는 추가적인 정규화 항이 적용된다.
\[\begin{equation} \mathcal{L}_\textrm{SRPO} (\theta) = \mathbb{E}_{t,i} \mathcal{L}_{t,i}^\textrm{CLIP} (\theta) + \omega (\theta) \end{equation}\]그룹 통계는 다음과 같이 world progress reward를 바탕으로 산출된다.
\[\begin{equation} \mu_g = \frac{1}{M} \sum_{i=1}^M g_i, \quad \sigma_g = \sqrt{\frac{1}{M} \sum_{i=1}^M (g_i - \mu_g)^2 + \epsilon} \end{equation}\]이러한 자기 참조적 접근 방식은 policy가 궤적 그룹 내 상대적 성능으로부터 학습할 수 있게 해주며, 이때 reward $g_i$는 전통적인 task-specific reward가 아닌 world progress reward model을 통해 산출된다. KL divergence 항 \(D_\textrm{KL} (\pi_\theta \; \| \; \pi_\textrm{ref})\)는 policy의 안정성을 유지하는 역할을 한다.
Experiments
1. Main Results
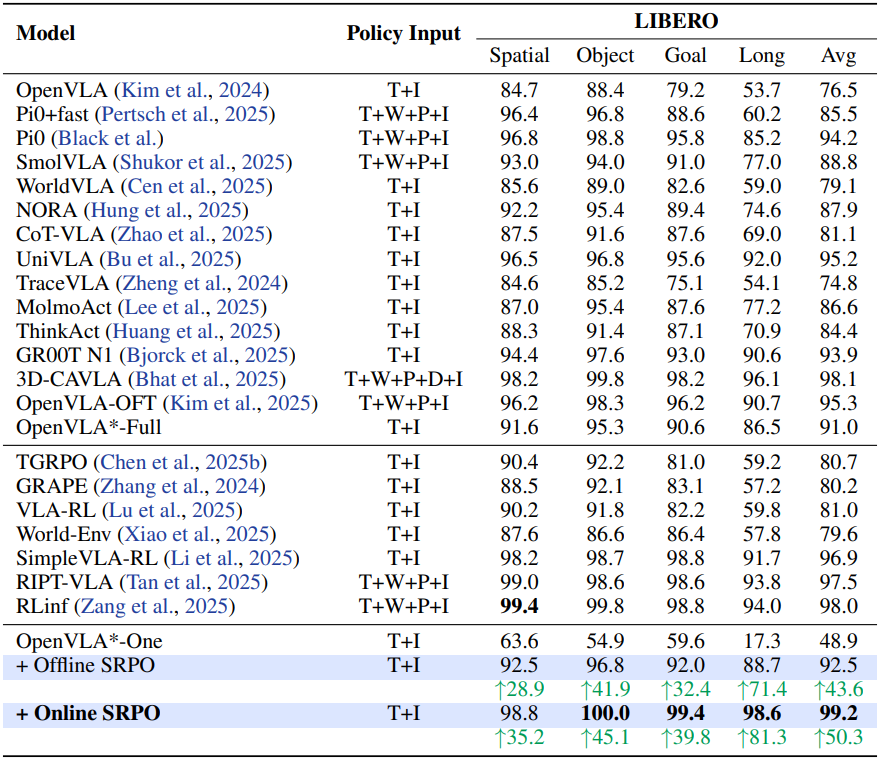
다음은 LIBERO 벤치마크에서의 결과이다. (T는 Thirdview, I는 Instruction, P는 Proprio, W는 Wristimage, D는 Depth)
2. Generalization Performance
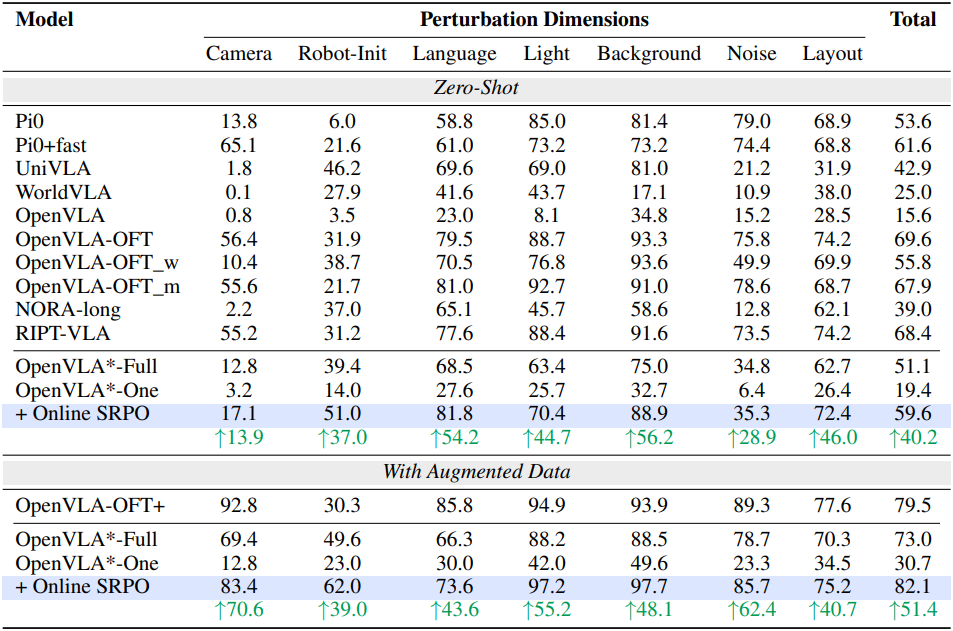
다음은 LIBERO-Plus 벤치마크에서 robustness를 평가한 결과이다.
3. Analysis
다음은 다양한 progress reward를 평가한 결과이다.
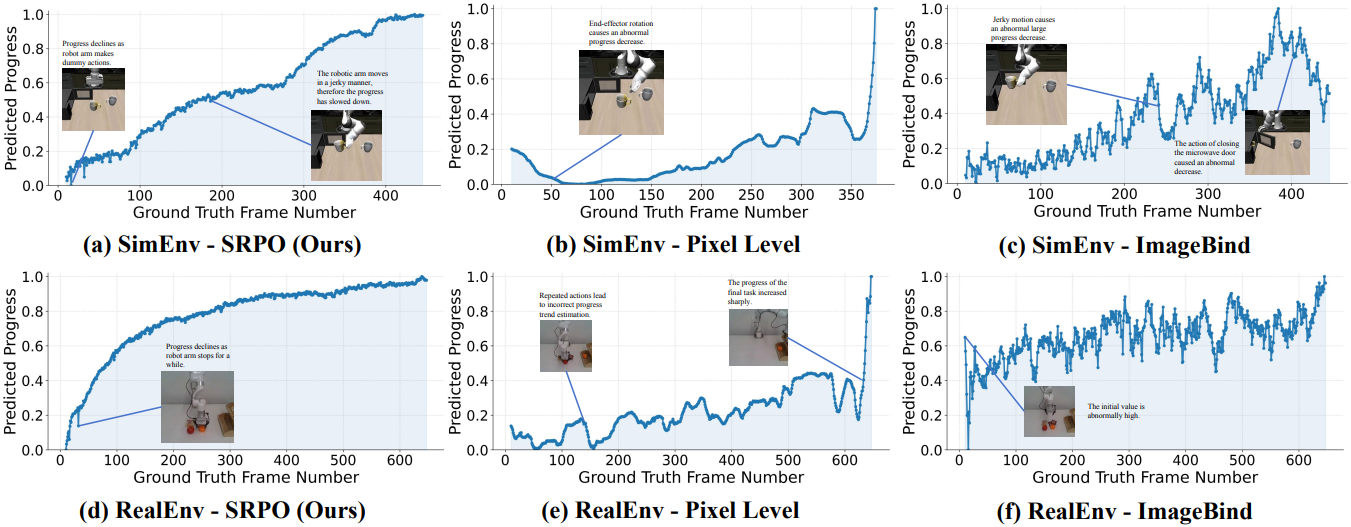
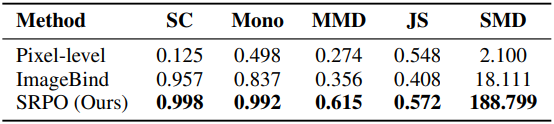
Spearman Correlation (SC)와 Monotonicity (Mono)은 성공 궤적만을 대상으로 계산되어 각각 프레임 번호와의 양의 상관관계 및 궤적의 단조성을 측정하며, Maximum Mean Discrepancy (MMD), JS Divergence (JS), Standardized Mean Difference (SMD)는 성공 궤적과 실패 궤적 간의 구별 가능성을 정량화하는 통계적 metric이다.
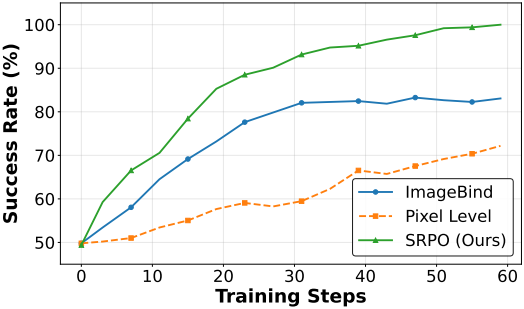
다음은 progress reward에 따른 학습 성능을 비교한 결과이다.
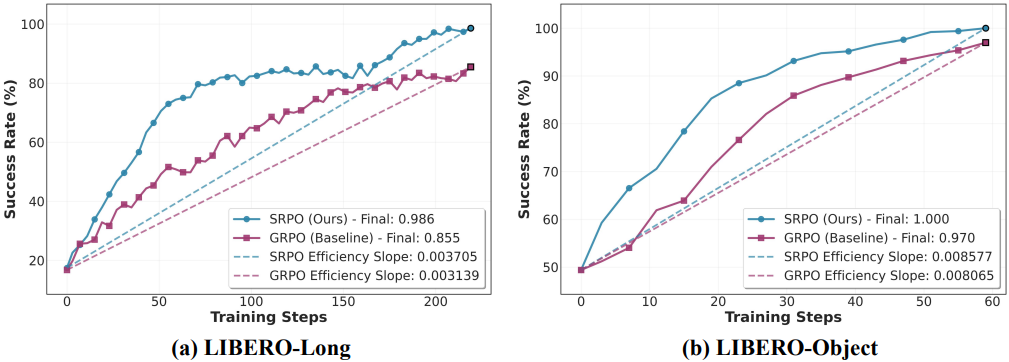
다음은 GRPO와 학습 효율성을 비교한 결과이다.
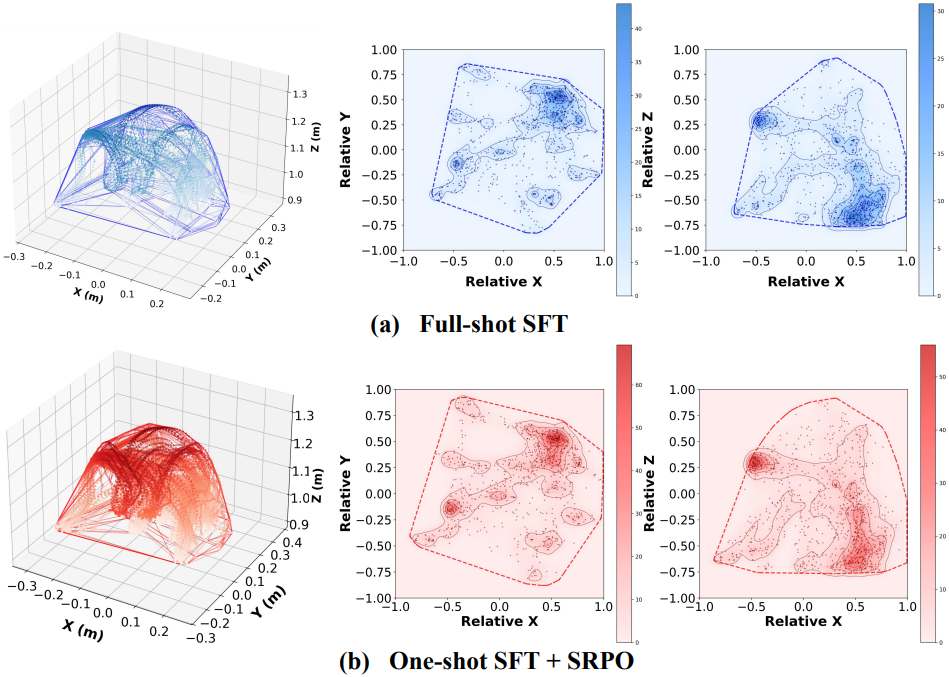
다음은 end-effector 궤적의 action space를 비교한 결과이다. SRPO는 이전에 도달할 수 없었던 영역을 탐색하며, 더 분산된 궤적을 생성한다.
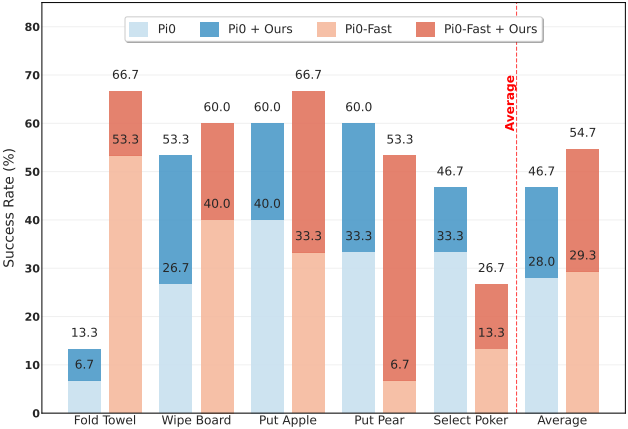
다음은 real-world task에 대한 성공률을 비교한 결과이다. (\(\pi_0\)는 diffusion policy, \(\pi_0\)-FAST는 autoregressive policy)