[논문리뷰] Reconstruction vs. Generation: Taming Optimization Dilemma in Latent Diffusion Models
CVPR 2025 (Oral). [Paper] [Github]
Yongsheng Yu, Wei Xiong, Weili Nie, Yichen Sheng, Shiqiu Liu, Jiebo Luo
Huazhong University of Science and Technology
2 Jan 2025
Introduction
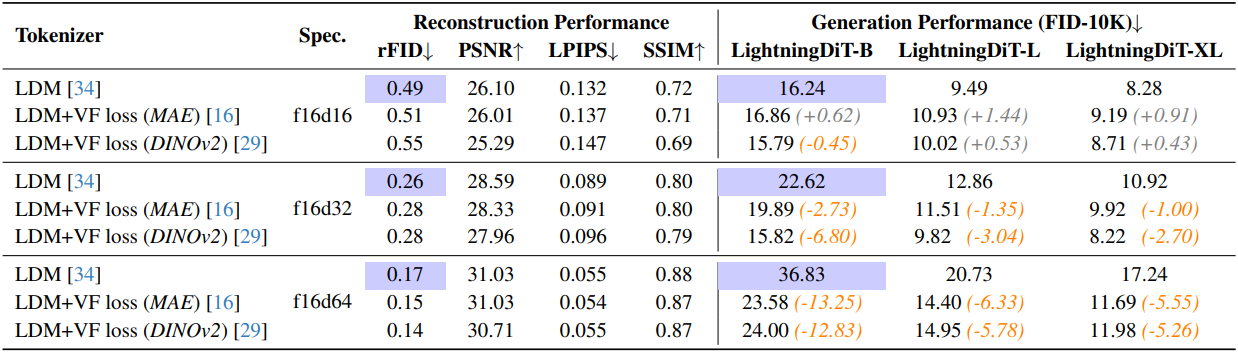
Latent diffusion model에서 재구성 성능과 생성 성능 간의 최적화 딜레마가 대두되었다. 구체적으로, 토큰 feature 차원을 높이면 tokenizer의 재구성 정확도는 향상되지만 생성 성능은 크게 저하된다.
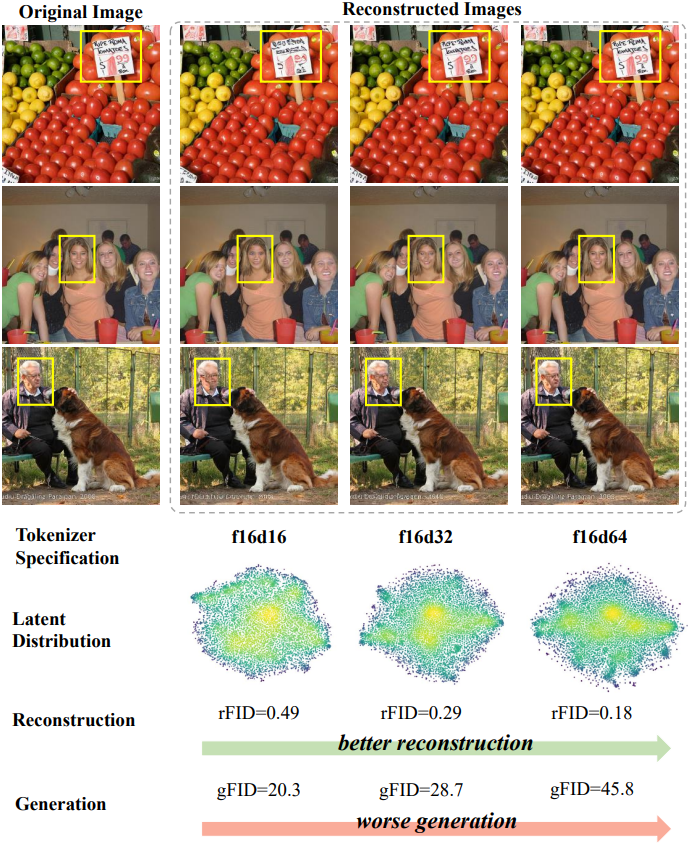
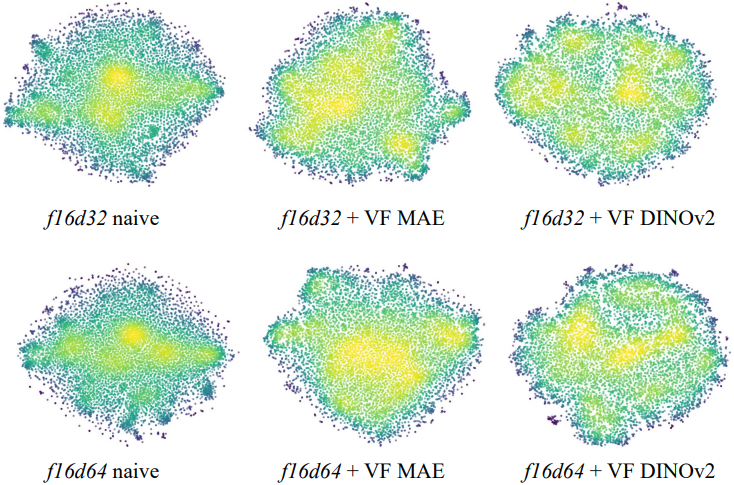
본 논문에서는 이러한 최적화 딜레마에 대해 간단하면서도 효과적인 접근 방식을 제안하였다. 다양한 feature 차원에 따른 latent space 분포를 시각화한 결과, 차원이 높은 tokenizer일수록 latent 표현을 덜 분산된 형태로 학습한다. 이는 분포 시각화에서 고강도 영역이 더 집중된 형태로 나타나는 것으로 입증된다. 이러한 분석은 최적화 딜레마가 제약 없는 고차원 latent space를 처음부터 학습해야 하는 본질적인 어려움에서 기인함을 시사한다.
이 문제를 해결하기 위해, 저자들은 latent diffusion model 내의 continuous VAE를 대상으로 vision foundation model의 가이드로 latent 표현을 학습시키는 최적화 전략을 개발했다. 이러한 방식은 고차원 tokenizer의 기존 재구성 능력을 유지하면서도 생성 성능을 크게 향상시킨다.
본 논문은 tokenizer 학습 중에 latent 표현을 사전 학습된 vision foundation model과 정렬하는 플러그 앤 플레이 모듈인 Vision Foundation model alignment Loss (VF Loss)를 제안하였다. 사전 학습된 vision foundation model로 VAE 인코더를 단순히 초기화하는 방식은 latent 표현이 재구성 최적화를 위해 초기 상태에서 빠르게 벗어나기 때문에 비효율적이다. 본 논문의 정렬 loss는 latent space의 용량을 과도하게 제한하지 않으면서 고차원 latent space를 정규화하도록 특별히 설계되었다.
- Feature space의 글로벌 및 로컬 구조를 포괄적으로 정규화하기 위해 element-wise 유사도와 pair-wise 유사도를 모두 적용하였다.
- 정렬에 제어된 유연성을 제공하기 위해 margin을 도입하여 과도한 정규화를 방지하였다.
저자들은 생성 성능을 평가하기 위해, Vision foundation model Aligned VAE (VA-VAE)를 DiT와 결합하여 latent diffusion model을 구축하였다. VA-VAE의 잠재력을 극대화하고자, diffusion 학습 전략과 transformer 구조를 개선한 DiT 프레임워크를 설계하였으며, 이를 LightningDiT라고 부른다.
VA-VAE
본 논문은 vision foundation model과의 정렬을 통해 학습된 visual tokenizer인 VA-VAE를 소개한다. 이 접근 방식의 핵심은 foundation model의 feature space를 활용하여 tokenizer의 latent space를 제약함으로써, 생성에 대한 적합성을 높이는 것이다.
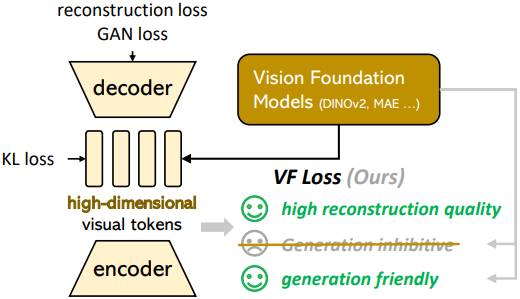
아키텍처 및 학습 과정은 주로 LDM을 따르며, KL loss에 의해 제약되는 continuous latent space를 갖는 VQGAN 모델 아키텍처를 사용한다. 본 논문에서 제시한 VF loss는 모델 아키텍처나 학습 파이프라인을 변경하지 않고 latent space를 실질적으로 최적화하며, 최적화 딜레마를 효과적으로 해결한다.
VF loss는 VAE 아키텍처와 분리된 두 가지 구성 요소로 이루어져 있다.
- Marginal cosine similarity loss
- Marginal distance matrix similarity loss
1. Marginal Cosine Similarity Loss
학습 과정에서, 주어진 이미지 $I$는 visual tokenizer의 인코더와 고정된 vision foundation model 모두에 의해 처리되어, 각각 이미지 latent $Z \in \mathbb{R}^{d_z}$와 visual representation $F \in \mathbb{R}^{d_f}$를 생성한다. $W \in \mathbb{R}^{d_f \times d_z}$를 통해 $Z$를 $F$의 차원에 맞게 projection함으로써 \(Z^\prime \in \mathbb{R}^{d_f}\)를 생성한다.
\[\begin{equation} Z^\prime = WZ \end{equation}\]Marginal cosine similarity loss \(\mathcal{L}_\textrm{mcos}\)는 각 공간 위치 $(i, j)$에서 feature 행렬 $Z^\prime$과 $F$의 대응하는 feature \(z_{ij}^\prime\)와 \(f_{ij}\) 간의 유사도 차이를 최소화한다.
\[\begin{equation} \mathcal{L}_\textrm{mcos} = \frac{1}{hw} \sum_{i=1}^h \sum_{j=1}^w \textrm{ReLU} \left( 1 - m_1 - \frac{z_{ij}^\prime \cdot f_{ij}}{\| z_{ij}^\prime \| \| f_{ij} \|} \right) \end{equation}\]ReLU는 코사인 유사도가 margin $m_1$ 미만인 쌍만 loss 계산에 반영되도록 하여, 유사도가 낮은 쌍에 대한 정렬에 초점을 맞춘다. 최종 loss는 $h \times w$ feature grid 내의 모든 위치에 대해 평균을 구하여 산출된다.
2. Marginal Distance Matrix Similarity Loss
저자들은 절대적인 point-to-point 정렬을 강제하는 \(\mathcal{L}_\textrm{mcos}\)를 보완하기 위해, feature 내 상대적 분포 거리 행렬들이 최대한 유사해지도록 하는 것을 목표로 하는 marginal distance matrix similarity loss \(\mathcal{L}_\textrm{mdms}\)를 제안하였다. \(\mathcal{L}_\textrm{mdms}\)는 feature 행렬 $z$와 $f$의 내부 분포를 정렬한다.
\[\begin{equation} \mathcal{L}_\textrm{mdms} = \frac{1}{h^2 w^2} \sum_{ij} \textrm{ReLU} \left( \left\vert \frac{z_i \cdot z_j}{\| z_i \| \| z_j \|} - \frac{f_i \cdot f_j}{\| f_i \| \| f_j \|} \right\vert - m_2 \right) \end{equation}\]각 쌍 $(i, j)$에 대해 대응하는 벡터 간 코사인 유사도 차이의 절댓값을 계산함으로써, 이들 상대적 구조가 더 밀접하게 정렬되도록 유도한다.
3. Adaptive Weighting
원래의 재구성 loss와 KL loss는 모두 sum loss이므로 VF loss는 완전히 다른 스케일에 위치하게 되어 안정적인 학습을 위한 가중치 조정이 어렵다. 따라서 저자들은 적응형 가중치 메커니즘을 도입했다. Backpropagation 전에 다음과 같이 인코더의 마지막 convolutional layer에서 \(L_\textrm{vf}\)와 \(L_\textrm{rec}\)의 gradient를 계산한다. 적응형 가중치는 이 두 gradient의 비율로 설정하여 \(L_\textrm{vf}\)와 \(L_\textrm{rec}\)가 모델 최적화에 유사한 영향을 미치도록 한다.
\[\begin{equation} w_\textrm{adaptive} = \frac{\| \nabla L_\textrm{rec} \|}{\| \nabla L_\textrm{vf} \|} \end{equation}\]그러면 적응형 가중치를 적용한 VF loss를 얻게 된다.
\[\begin{equation} \mathcal{L}_\textrm{vf} = w_\textrm{hyper} w_\textrm{adaptive} (\mathcal{L}_\textrm{mcos} + \mathcal{L}_\textrm{mdms}) \end{equation}\]적응형 가중치의 목적은 서로 다른 VAE 학습 파이프라인에서 loss 스케일을 빠르게 일치시키는 것이다. 이를 기반으로 hyperparameter \(w_\textrm{hyper}\)를 사용하여 성능을 더욱 향상시킬 수 있다.
LightningDiT
DiT는 ImageNet에서의 수렴 속도가 상당히 느려 많은 비용이 소요된다는 한계가 있다. 본 논문에서 DiT 아키텍처의 잠재력을 확장하고 DiT가 도달할 수 있는 성능의 한계를 탐구하였다.
본 논문에서는 visual tokenizer로 f8d4의 SD-VAE를 사용하고, 모델로는 DiT-XL/2를 채택했다. 최적화 절차는 다음 표와 같다.
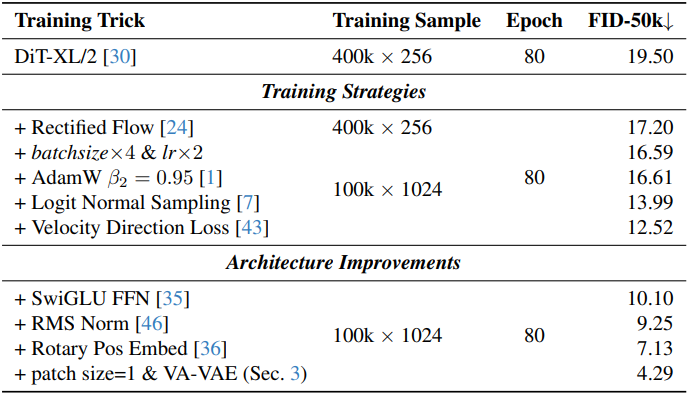
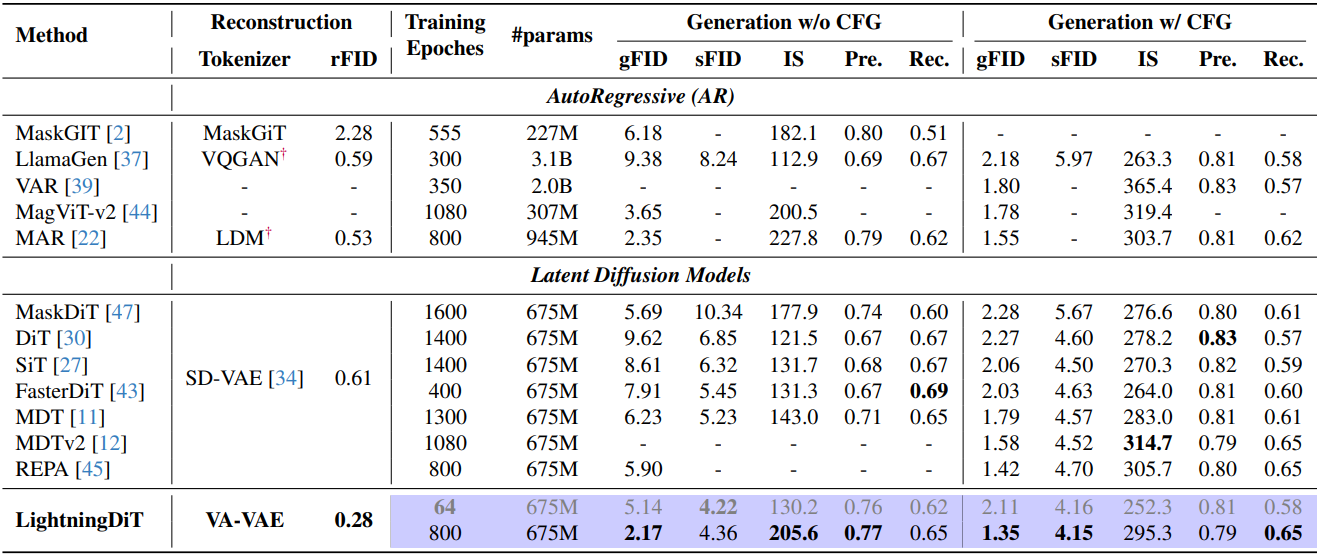
최적화한 모델인 LightningDiT는 ImageNet 클래스 조건부 생성 task에서 SD-VAE를 사용하여 약 80 epoch 만에 7.13의 FID를 달성했다. 이는 기존 DiT 및 SiT 모델에서 사용한 1,400 epoch의 6%에 불과한 수준이다.
Experiments
1. Foundation Models Improve Convergence
다음은 VF loss 유무에 따른 생성 성능을 비교한 결과이다.
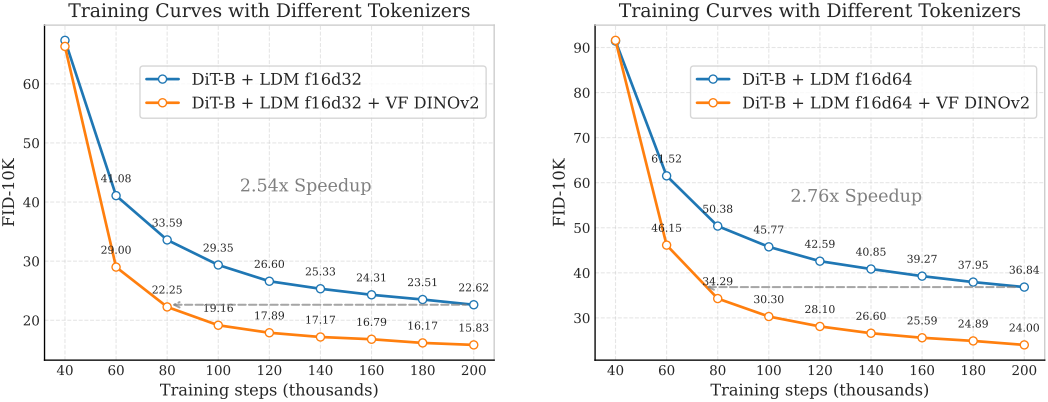
다음은 tokenizer에 따른 training curve를 비교한 결과이다.
2. Foundation Models Improve Scalability
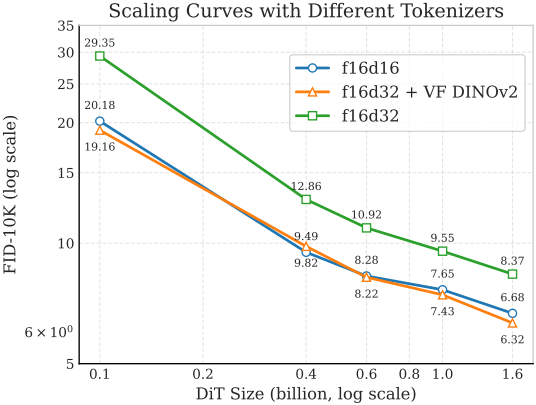
다음은 DiT 크기에 따른 scalability를 비교한 결과이다.
3. Convergence 21.8× Faster than DiT
다음은 ImageNet 256$\times$256에서의 성능 비교 결과이다.
4. Ablations
다음은 foundation model에 대한 ablation 결과이다.
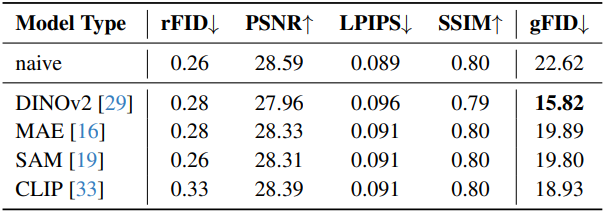
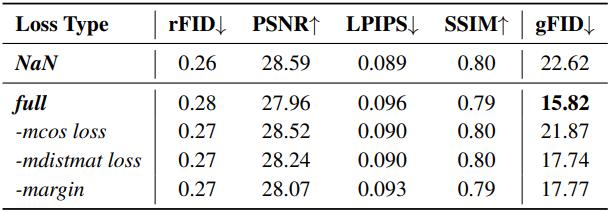
다음은 VF loss에 대한 ablation 결과이다. (LightningDiT-B)
다음은 latent space를 t-SNE로 시각화한 것이다.
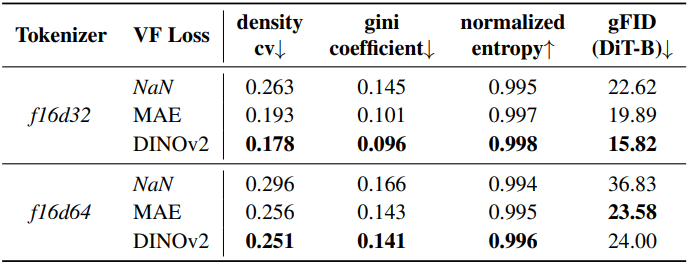
다음은 feature 분포의 균일성과 생성 성능 간의 관계를 나타낸 표이다.