[논문리뷰] Learning Convex Decomposition via Feature Fields
CVPR 2026 (Oral). [Paper] [Page] [Github]
Yuezhi Yang, Qixing Huang, Mikaela Angelina Uy, Nicholas Sharp
NVIDIA | University of Texas Austin
10 Mar 2026
Introduction
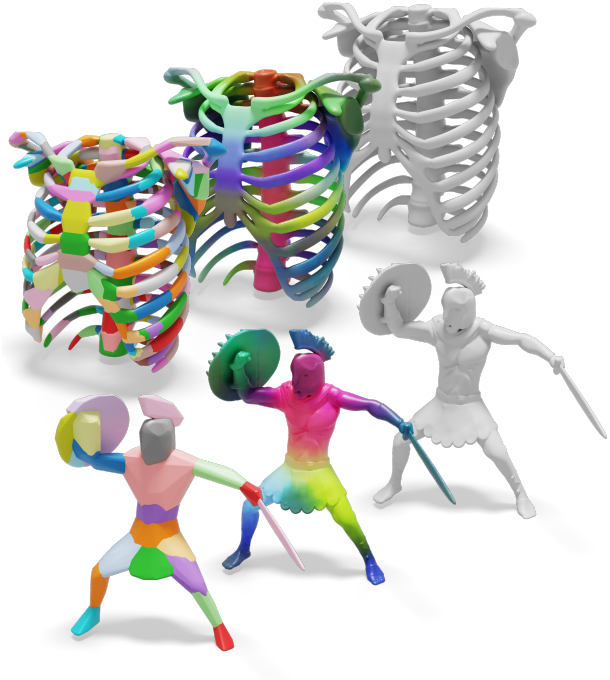
Convex decomposition은 3D shape을 입력으로 받아 해당 shape을 정밀하게 근사하는 convex body들의 집합을 출력다. 본 논문은 고품질 convex decomposition 결과를 직접 생성하는 feedforward 모델을 학습시킬 수 있는 새로운 convex decomposition 공식을 제안하였다.
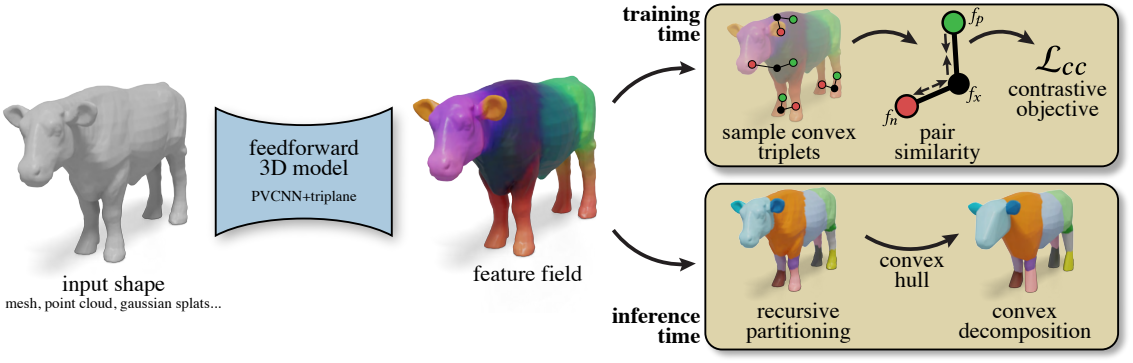
핵심 아이디어는 feature learning 방식을 도입하는 것이다. Primitive 집합을 직접 최적화하거나 학습하는 대신, shape을 따라 정의된 continuous한 feature를 활용하여, 이를 클러스터링했을 때 우수한 convex decomposition 결과가 도출되도록 하는 feature 집합을 구성한다. 이를 실현하기 위해, ‘두 점을 잇는 선분이 shape 내부에 포함되어야 한다’는 convexity의 정의에서 영감을 얻은 새로운 feature 기반 self-supervised contrastive loss를 도입하였다.
Method
1. Formulation
\(\mathcal{M} \subset \mathbb{R}^3\)을 어떤 입체의 경계면인 shape 표면이라 하고, \(\textrm{Vol}(\mathcal{M}) \in \mathbb{R}^3\)을 해당 입체의 볼륨이라고 정의하자.
Convex decomposition은 $\mathcal{M}$을 서로 겹치지 않는 구성 요소들의 집합 \(\{S_i\}\)로 분할하는 과정으로 볼 수 있다. 즉, 모든 $S_i$의 합집합은 $\mathcal{M}$이 되고, $S_i \cap S_j = \emptyset$를 만족해야 한다. 여기서 좋은 분할이란 구성 요소의 개수가 최소화되고, 각 구성 요소가 해당 shape을 정밀하게 볼록 근사하는 경우, 다시 말해 $S_i$와 $S_i$의 convex hull 간의 편차가 작은 경우를 의미한다. 후자의 척도를 ‘concavity’라 부른다. 또한, shape 위의 한 점을 입력받아 그 점이 어떤 세그먼트에 속하는지를 반환하는 할당 함수 \(G : \mathcal{M} \rightarrow \{S_i\}\)를 정의할 수도 있다.
Convex Pairs
저자들은 convexity에 대한 고전적인 정의에서 영감을 받았다. 어떤 shape 내의 임의의 두 점을 연결하는 선분이 그 shape의 내부에 완전히 포함될 때, 그 shape은 convex하다고 한다.
\[\begin{equation} \lambda x + (1 - \lambda) y \in \textrm{Vol}(\mathcal{M}) \quad \forall x, y \in \mathcal{M}, \quad \forall \lambda \in [0, 1] \end{equation}\]이러한 점들을 convex pair라고 부른다. 잠재적으로 non-convex일 수 있는 shape에 대해, 모든 convex pair의 집합 $\mathcal{C}(\mathcal{M}) \subseteq \mathcal{M} \times \mathcal{M}$을 다음과 같이 정의할 수 있다.
\[\begin{equation} \mathcal{C}(\mathcal{M}) = \{(x \in \mathcal{M}, y \in \mathcal{M}) : \lambda x + (1 - \lambda) y \in \textrm{Vol}(\mathcal{M}) \quad \forall \lambda \in [0, 1] \} \end{equation}\]표면상에 위치한 점들만 검사하는 것으로 충분하다. $(x, y) \notin \mathcal{C}$가 non-convex하다는 것은, 이 두 점을 잇는 선분이 해당 shape의 외부를 통과함을 의미한다. 실제로는 두 점을 잇는 광선을 쏘아 표면과의 교차 여부를 확인하는 방식으로, 표면상의 점 쌍에 대한 convexity 여부를 효율적으로 검사할 수 있다.
이러한 convex pair의 개념을 활용하면, 좋은 convex decomposition이 무엇을 의미하는지에 대한 최적화 문제를 구성할 수 있다. 좋은 decomposition이란 동일한 세그먼트에 속하는 convex pair의 수를 최대화하거나, 이와 동등하게 서로 다른 세그먼트로 나뉘는 convex pair의 수를 최소화하는 분할을 말한다.
\[\begin{equation} \max_{\{S_i\}} \iint_{(x,y) \in \mathcal{C}(\mathcal{M})} \mathbb{1}_{G(x)=G(y)} \, dx \, dy \end{equation}\]이 objective를 직접 최적화하는 것은 불가능하지만, 이를 continuous한 feature 임베딩 문제로 완화할 수 있다.
2. Convex Decomposition as Feature Learning
위의 objective가 클러스터링과 유사하다는 점에 주목하여, objective를 feature learning 문제로 재구성한다. 여기서 목표는 나중에 클러스터링하여 원하는 convex decomposition을 얻을 수 있는 continuous한 feature를 학습하는 것이다. 각 점에서 정의된 $k$차원 feature field $f : \mathcal{M} \rightarrow \mathbb{R}^k$를 고려하고, feature 거리 $d(f_x, f_y)$라는 개념을 사용한다. 이러한 관점에서 위의 objective는 다음과 같이 완화될 수 있다.
\[\begin{equation} \min_f \iint_{(x,y) \in \mathcal{C}(\mathcal{M})} d(f_x, f_y) \, dx \, dy \end{equation}\]위 식은 convex pair들을 서로 끌어당기기 때문에 $f(x) = \textrm{constant}$라는 자명한 해를 갖게 된다. 따라서 non-convex pair들을 서로 밀어내려는 두 번째 항을 추가하여 균형을 맞춘다.
\[\begin{equation} \min_f \iint_{(x,y) \in \mathcal{C}(\mathcal{M})} d(f_x, f_y) \, dx \, dy - \min_f \iint_{(x,y) \notin \mathcal{C}(\mathcal{M})} d(f_x, f_y) \, dx \, dy \end{equation}\]이때 $\vert \vert f \vert \vert = 1$$이라는 제약을 두어 값이 무한히 커지는 것을 방지한다. 머신러닝 관점에서 볼 때 이 objective는 self-supervised 방식이다. 즉, 입력 shape의 geometry만을 활용하여 좋은 feature 집합을, 나아가 좋은 decomposition 결과를 얻도록 최적화를 수행할 수 있게 해준다.
실제 최적화 과정에서는 먼저 shape 위의 점들로 이루어진 다수의 쌍 $(x, y)$을 샘플링하고, 두 점을 잇는 선분이 shape 내부에 포함되는지 여부를 바탕으로 각 쌍이 $\mathcal{C}(\mathcal{M})$에 속하는지 기하학적으로 판별한 뒤, objective를 최소화하는 방향으로 feature를 최적화시킨다.
3. Contrastive Feature Learning
위의 objective를 직접 최적화하는 대신 contrastive learning의 형태로 재구성한다. Contrastive loss는 positive pair $x, p \in \mathcal{C}(\mathcal{M})$과 negative pair $x, n \notin \mathcal{C}(\mathcal{M})$을 형성하는 triplet $x, p, n \in \mathcal{M}$을 수집하여 정의되며, 이때 positive pair 간의 거리가 negative pair 간의 거리보다 작아지도록 하는 것을 목표로 한다.
\[\begin{equation} \mathcal{L}_\textrm{cc} = -\frac{1}{2} \left[ \log \frac{\exp (f_x \cdot f_p / \tau)}{\exp (f_x \cdot f_p / \tau) + \exp (f_x \cdot f_n / \tau)} + \log \frac{\exp (f_p \cdot f_x / \tau)}{\exp (f_p \cdot f_x / \tau) + \exp (f_p \cdot f_n / \tau)} \right] \end{equation}\]($\tau$는 temperature hyperparameter)
Triplet Sampling과 Hard Negatives
먼저 object 표면에서 기준 샘플 $x \in \mathcal{M}$을 균등하게 선택한다. $x$와 positive pair를 이루는 샘플 $p \in \mathbb{M}$을 얻기 위해, $x$의 표면 normal 방향과 반대되는 반구 방향, 즉 shape 내부를 향해 랜덤 광선을 쏘고, 이 광선이 표면 밖으로 나가는 지점을 $p$로 취한다.
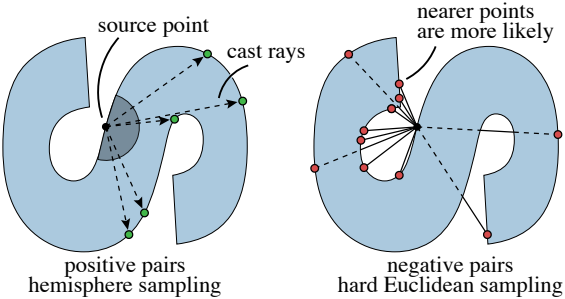
$x$와 negative pair을 이루는 샘플 $n \in \mathcal{M}$을 얻을 때는 rejection sampling을 수행한다. $\mathcal{M}$의 표면에서 후보점들을 생성한 뒤 $x$와 $n$을 잇는 선분이 shape 외부로 나가는지 여부를 확인한다. 표면상의 점들을 단순히 균등하게 수집하기보다는 $x$와 공간적으로 가까운 샘플을 선호하며, 따라서 유클리드 거리에 반비례하는 확률 \(P(n) = \frac{1}{\| n-x \|^2}\)에 따라 샘플링을 수행한다. 이를 통해 feature 최적화를 더욱 효율적으로 수행할 수 있다.
이 샘플링 절차의 효율적이고 robust하게 구현될 수 있는데, 이는 샘플링 포인트 추출과 ray casting만 필요로 하기 때문이다. 특히 ray casting 연산은 Intel Embree나 NVIDIA OptiX와 같은 라이브러리를 통해 하드웨어 가속을 활용함으로써, 실시간으로 빠르게 triplet을 생성할 수 있다.
4. Feedforward Model
Feature 기반의 접근 방식은 segmentation이나 임베딩 등을 위한 대규모 학습의 프레임워크로서 널리 활용되어 왔다. Convex decomposition을 feature learning 문제로 재구성하면 이러한 접근 방식을 적용할 수 있게 된다. 이를 통해 방대한 3D shape 데이터셋을 활용한 self-supervised learning으로 입력 shape $\mathcal{M}$에 따른 field $f$를 예측하는 feedforward 모델을 학습시킬 수 있다. 본 논문에서 제안하는 self-supervised loss는 고품질의 GT 데이터가 부족한 문제를 우회하여, 오직 shape의 geometry만으로 학습을 가능하게 하는 핵심적인 역할을 한다.
개별 shape별 최적화 방식과 비교했을 때, 이 feedforward 모델은 세 가지 주요 이점을 제공한다.
- 빠른 inference 속도
- 입력 노이즈나 불완전한 shape 정보에도 robust한 feature field
- 다양한 3D 입력 모달리티에 대한 일반화 능력
저자들은 Partfield와 유사한 아키텍처를 채택하였다. Partfield는 shape 표면 $\mathcal{M}$에서 샘플링된 포인트 클라우드를 입력으로 받아, 임의의 공간 위치에서 평가 가능한 triplane으로 인코딩된 feature field를 출력한다.
네트워크는 크게 두 단계로 구성된다. 먼저, PVCNN 인코더가 포인트 클라우드로 $\mathcal{M}$을 인코딩하여 각 포인트별 feature를 추출한다. 추출된 feature들은 mean reduction을 거쳐 축 정렬된 3개의 2D feature plane으로 projection됨으로써 초기 triplane 표현을 형성한다. 이 초기 triplane은 2D CNN을 통해 다운샘플링된 후 reshape되어 transformer 모듈을 통과하며, 최종적으로 transposed 2D CNN을 이용한 업샘플링을 거쳐 최종 feature triplane으로 복원된다. 따라서 임의의 3D 쿼리 포인트에 대한 feature는 최종 feature triplane에서 해당 위치의 feature들을 통합함으로써 얻을 수 있다.
5. Recursive Decomposition on Features
Inference 시, 학습된 모델은 feature field $f : \mathcal{M} \rightarrow \mathbb{R}^k$를 생성하는데, 이때 유사한 feature들은 convex decomposition 과정에서 함께 나타나야 하는 표면 영역을 나타낸다.
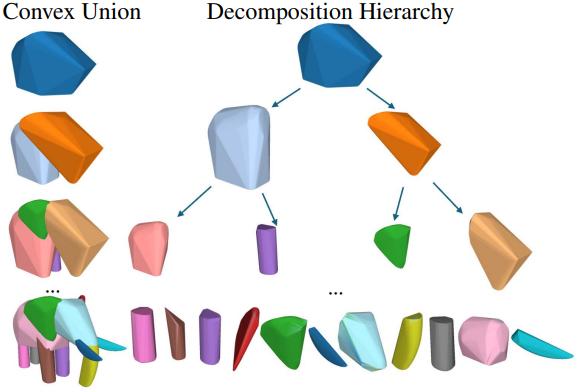
구체적으로, 예측된 field를 사용하여 입력 shape $S$의 표면에서 feature를 샘플링하고, 클러스터링 알고리즘을 적용하여 $S$를 \(\{S_i\}\)로 분할한다. 원칙적으로 어떤 클러스터링 알고리즘이든 사용할 수 있으며, 일반적으로 빠른 성능을 위해 $k$-means 클러스터링을 사용하거나, 연결성을 고려하기 위해 agglomerative clustering을 사용한다. 메쉬 기반 입력의 경우, 각 face별로 feature를 샘플링하고 메쉬 연결성을 고려한 agglomerative clustering을 사용한다. 포인트 클라우드와 같은 다른 모달리티의 경우, feature space 거리와 유클리드 거리를 혼합하여 $k$-means 클러스터링을 적용한다. 마지막으로, 각 클러스터에 대해 convex hull ${\textrm{hull}(S_i)}$$을 계산하고, 이 convex hull들의 합집합은 입력 shape을 근사한다.
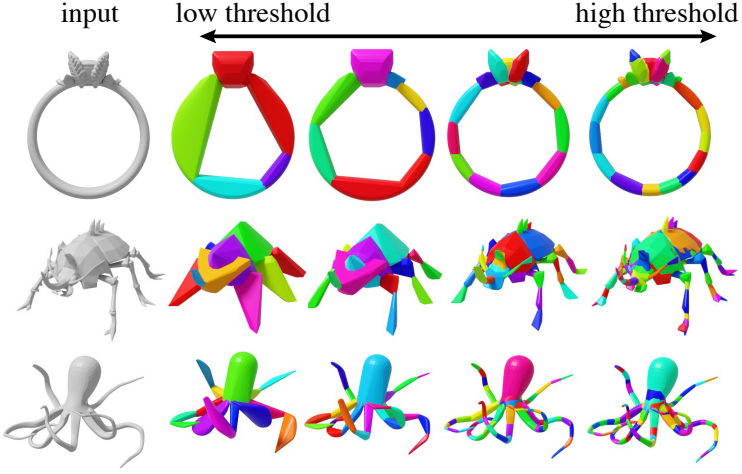
Decomposition 시 클러스터의 개수를 결정하는 명확한 전략은 존재하지 않으므로, 본 논문에서는 사용자가 지정한 concavity threshold에 도달할 때까지 binary clustering을 반복적으로 수행하는 재귀적 전략을 채택하였다. 이 threshold를 통해 결과물의 세밀도를 조절할 수 있는데, 중요한 점은 이러한 세밀도 설정이 클러스터링 후처리 단계에서만 이루어지면 되며, 학습된 feature는 임의의 세밀도 수준에서의 decomposition에 활용될 수 있다는 것이다.
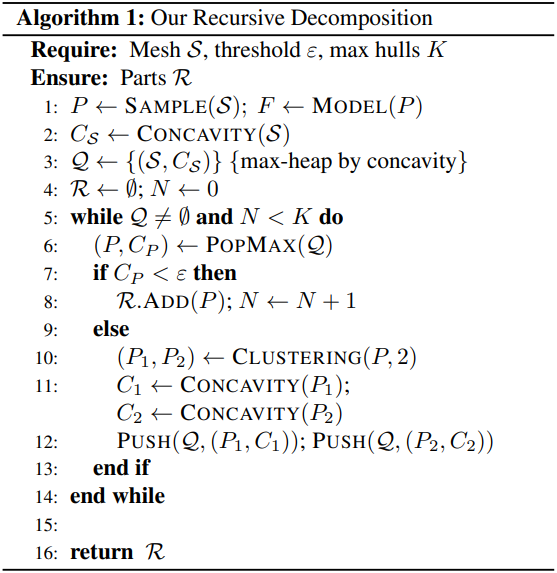
Algorithm 1은 이 divide-and-conquer 전략을 설명한다. 해당 클러스터가 자신이 포함하는 영역을 충분히 근사하는 convex 형태가 아닐 경우, binary clustering을 적용하여 이를 분할한 뒤 생성된 두 하위 구성요소에 대해 재귀적으로 동일한 과정을 수행한다. 모든 구성요소가 목표 threshold에 도달하거나 사용자가 지정한 최대 구성요소 개수에 이를 때까지 concavity 정도에 따라 구성요소들을 처리한다.
Experiments
- 데이터셋: Objaverse
- $[-1, 1]$로 정규화 후 10만 개의 점을 샘플링
1. Baseline Comparisons
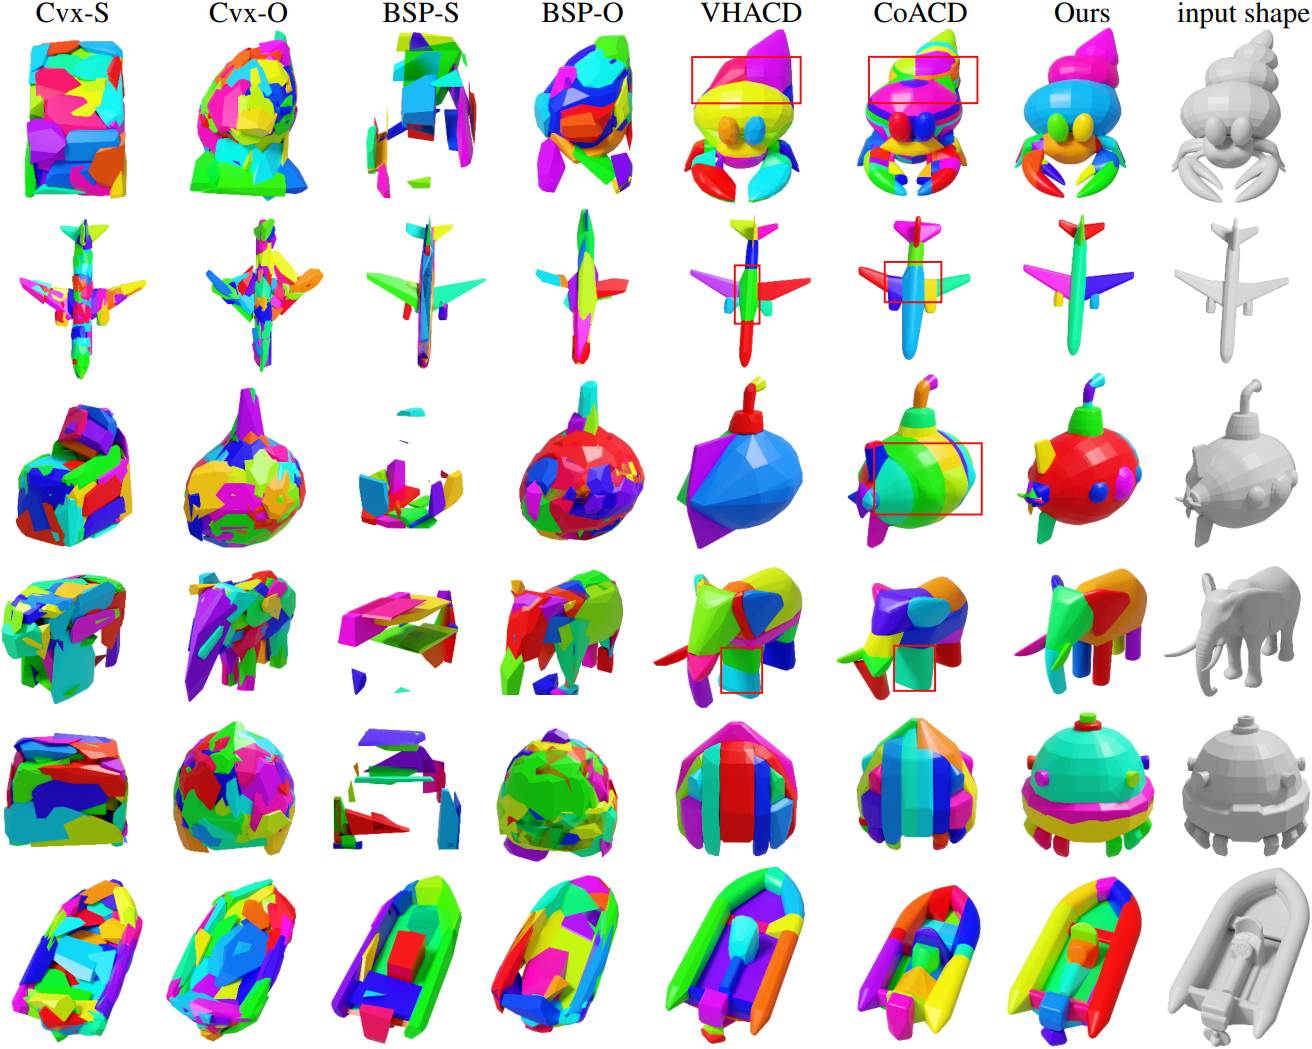
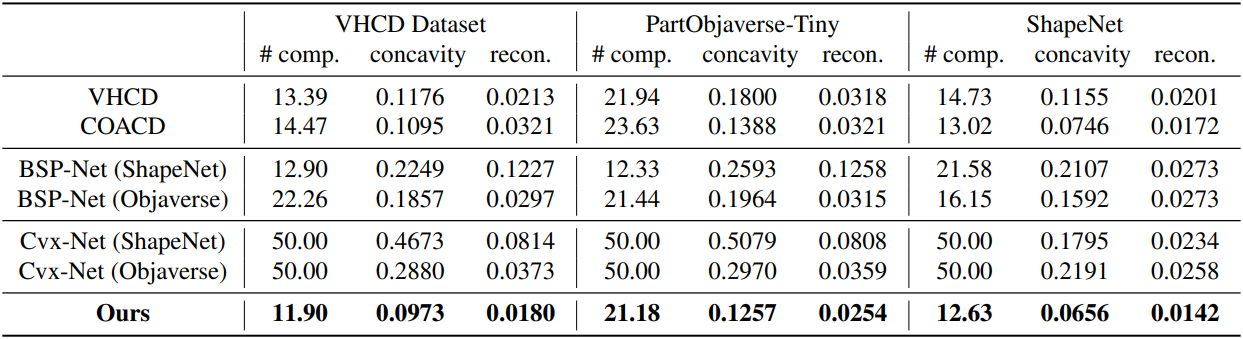
다음은 다른 방법들과 비교한 결과이다.
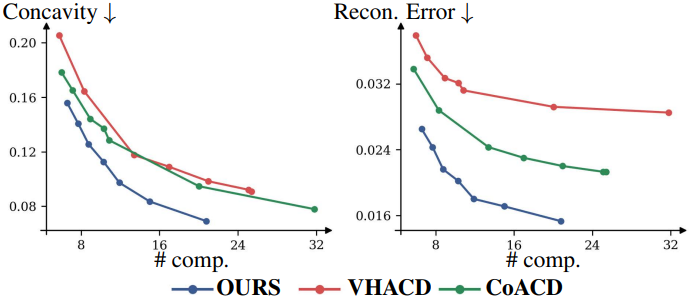
다음은 VHACD 데이터셋에서 다양한 세밀도에 따른 결과를 비교한 그래프이다.
2. Analysis and Ablation
다음은 concavity threshold에 따른 convex decomposition 결과를 비교한 것이다.
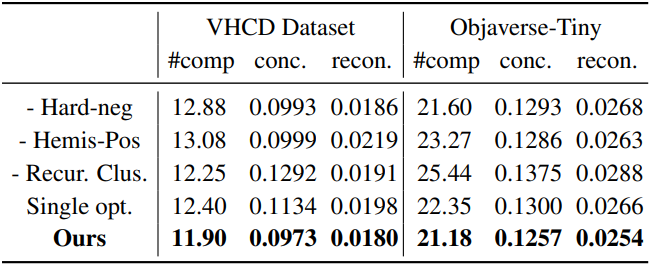
다음은 ablation study 결과이다.
3. Applications
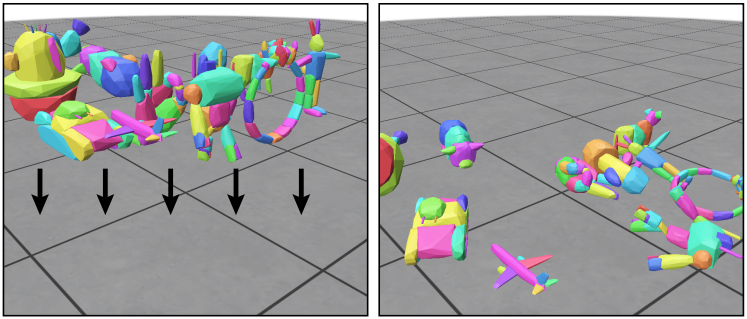
다음은 물리 시뮬레이션에서 충돌 처리를 가속하기 위해 convex decomposition 결과를 사용한 예시이다.
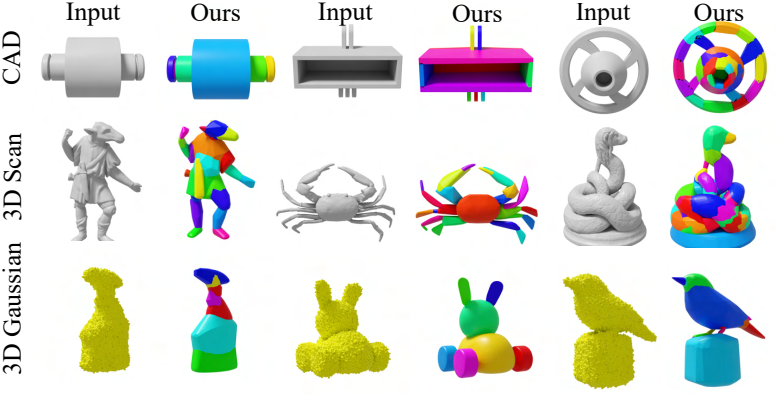
다음은 다양한 입력 모달리티에 따른 결과이다.
Limitations
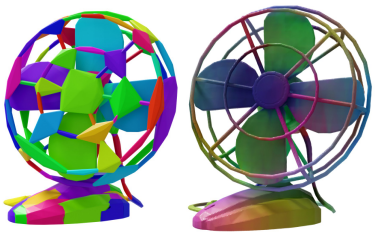
- Object-level 데이터로 학습되었기 때문에, 장면 스케일이나 결손이 심한 shape에 대해서는 반드시 일반화된 성능을 보이지는 않는다.
- 선풍기 프레임과 같이 복잡하고 얇은 구조를 처리하는 데 어려움이 있다.