[논문리뷰] Difix3D+: Improving 3D Reconstructions with Single-Step Diffusion Models
CVPR 2025. [Paper] [Page] [Github]
Jay Zhangjie Wu, Yuxuan Zhang, Haithem Turki, Xuanchi Ren, Jun Gao, Mike Zheng Shou, Sanja Fidler, Zan Gojcic, Huan Ling
NVIDIA | National University of Singapore | University of Toronto | Vector Institute
3 Mar 2025
Introduction
본 논문에서는 2D diffusion prior를 활용하여 대규모 장면의 3D 복원 품질을 효율적으로 향상시키는 과제를 다룬다. 이를 위해 저자들은 text-to-image 생성의 inference 속도를 획기적으로 높인 single-step diffusion 기술을 기반으로 삼았다. 이러한 single-step 모델은 시각적 지식을 보유하고 있어, 최소한의 fine-tuning만으로도 NeRF나 3DGS 렌더링 결과물에 나타나는 아티팩트를 보정하는 데 활용될 수 있다.
복원 과정에서 이 fine-tuning된 모델(Difix)을 사용하여 pseudo-training view들을 생성하고, 이를 다시 3D 모델로 distillation함으로써 데이터가 부족하거나 제약이 적은 영역의 품질을 크게 높인다. 나아가 모델의 빠른 inference 속도를 활용하여, 개선된 복원 결과물에 Difix를 실시간 후처리 단계로 직접 적용함으로써 품질을 한층 더 향상시켰다 (Difix3D+).
Method
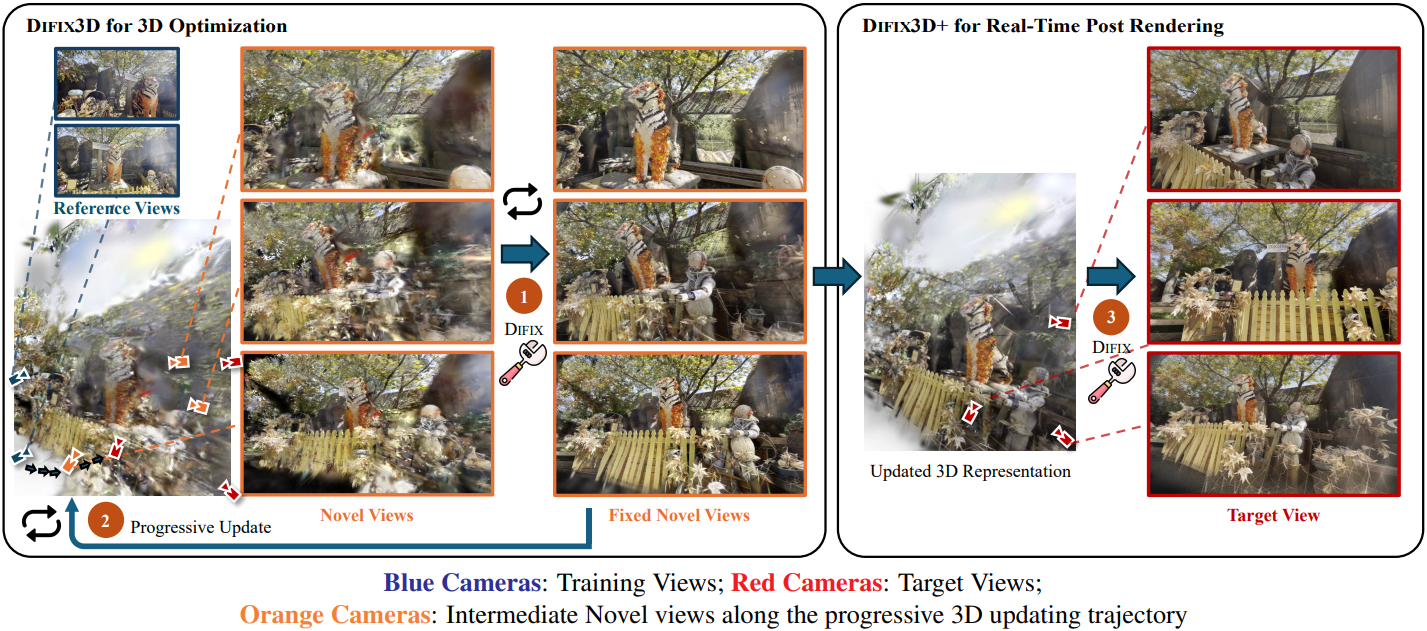
RGB 이미지 모음과 해당 카메라 포즈가 주어졌을 때, 본 논문의 목표는 임의의 시점에서 사실적인 novel view synthesis를 가능하게 하는 3D 표현을 재구성하는 것이다. 특히 입력 카메라 위치에서 멀리 떨어진, 제약 조건이 부족한 영역에 중점을 둔다. 이를 달성하기 위해, 사전 학습된 diffusion model의 강력한 prior를 활용한다. 구체적으로, 최적화 단계에서는 학습 데이터셋을 반복적으로 깨끗한 가상 시점으로 보강하여 멀리 떨어져 있거나 관찰되지 않은 영역의 3D 표현을 개선하고, inference 단계에서는 실시간 후처리를 통해 불충분하거나 일관성이 없는 학습 supervision으로 인한 아티팩트를 더욱 줄인다.
1. Difix: From a pretrained diffusion model to a 3D Artifact Fixer
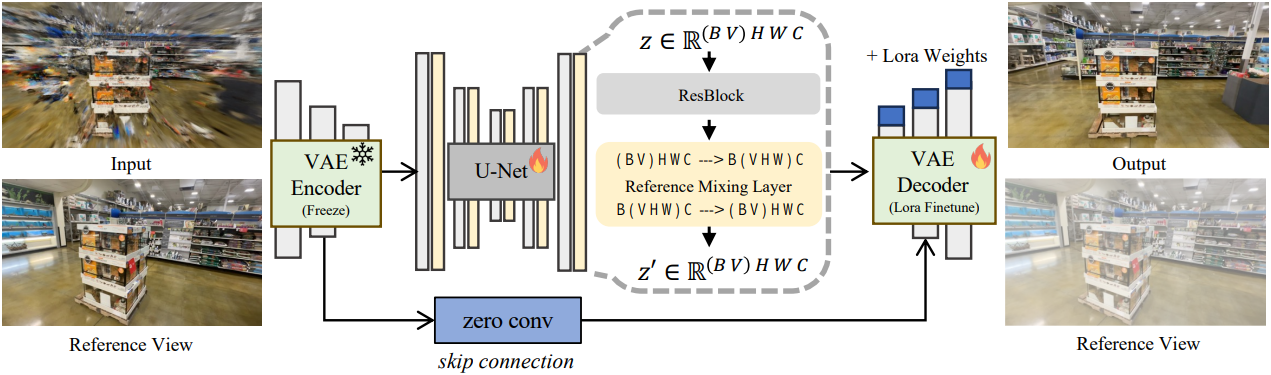
아티팩트를 포함할 수 있는 렌더링된 새로운 시점의 이미지 $\tilde{I}$와 깨끗한 레퍼런스 뷰 집합 \(I_\textrm{ref}\)가 주어지면, 모델은 정제된 novel view의 예측 이미지 $\hat{I}$를 생성한다. 효율성을 확보하고 inference 시에 실시간 후처리가 가능하도록 하기 위해, 저자들은 single-step diffusion model인 SD-Turbo를 기반으로 모델을 구축했다.
레퍼런스 뷰 컨디셔닝
깨끗한 레퍼런스 뷰 집합 \(I_\textrm{ref}\)를 기반으로 모델을 컨디셔닝하는데, 실제로는 가장 가까운 학습 뷰를 선택한다. Self-attention layer를 레퍼런스 혼합 레이어로 변환하여 뷰 간 의존성을 포착한다. 먼저 $\tilde{I}$와 \(I_\textrm{ref}\)를 추가 뷰 차원에서 concat하고 프레임 단위로 latent space로 인코딩한다.
\[\begin{equation} \mathcal{E}((\tilde{I}, I_\textrm{ref})) = \textbf{z} \in \mathbb{R}^{V \times C \times H \times W} \end{equation}\]($V$는 입력 뷰 수, $C$는 latent 채널 수, $H$와 $W$는 latent 공간 차원)
레퍼런스 혼합 레이어는 먼저 뷰 축을 공간 축으로 이동시킨 다음, self-attention 연산 후 다시 원래 shape으로 복원하는 방식으로 작동한다.
\[\begin{aligned} \textbf{z}^\prime &\leftarrow \textrm{rearrange} (\textbf{z}, \textrm{b c v (hw)} \rightarrow \textrm{b c (vhw)}) \\ \textbf{z}^\prime &\leftarrow l_\phi^i (\textbf{z}^\prime, \textbf{z}^\prime) \\ \textbf{z}^\prime &\leftarrow \textrm{rearrange} (\textbf{z}, \textrm{b c (vhw)} \rightarrow \textrm{b c v (hw)}) \end{aligned}\]($l_\phi^i$는 vhw 차원에 적용되는 self-attention layer)
이러한 설계 덕분에 기존 2D self-attention의 모든 모듈 가중치를 그대로 활용할 수 있다. 이러한 방식은 레퍼런스 뷰로부터 핵심 정보를 포착하는 데 효과적이며, 특히 생성된 novel view의 품질이 심각하게 저하된 경우에 더욱 그렇다.
Fine-tuning
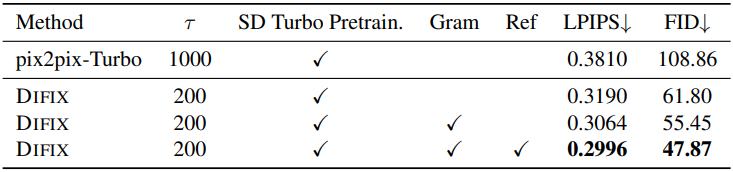
Pix2pix-Turbo와 유사한 방식으로, 고정된 VAE 인코더와 LoRA로 fine-tuning된 디코더를 사용하여 SD-Turbo를 fine-tuning한다. 랜덤 Gaussian noise 대신 품질이 저하된 렌더링 이미지 $\tilde{I}$를 직접 입력으로 받도록 모델을 학습시키되, 더 낮은 noise level을 적용한다 ($\tau = 1000$ 대신 $\tau = 200$). 품질이 저하된 이미지 $\tilde{I}$의 분포가, 특정 noise level $\tau$에서 diffusion model을 학습시키는 데 사용된 이미지 \(\textbf{x}_\tau\)의 분포와 유사하기 때문이다.
Losses
손쉽게 얻을 수 있는 2D supervision 정보로부터 도출된 loss를 사용하여 diffusion model을 학습시킨다. 모델의 출력값 $\hat{I}$와 GT 이미지 $I$ 간의 L2 차이, LPIPS loss, style loss를 함께 사용한다. Style loss는 VGG-16 feature의 auto-correlation에 대한 L2 norm으로 정의되는 Gram matrix loss를 통해 구현된다.
\[\begin{equation} \mathcal{L}_\textrm{Gram} = \frac{1}{L} \sum_{l=1}^L \beta_l \| G_l (\hat{I}) - G_l (I) \|_2 \\ \textrm{where} \quad G_l (I) = \phi_l (I)^\top \phi_l (I) \end{equation}\]모델을 학습시키는 데 사용되는 최종 loss는 위 항들의 가중 합이다.
\[\begin{equation} \mathcal{L} = \mathcal{L}_\textrm{Recon} + \mathcal{L}_\textrm{LPIPS} + 0.5 \mathcal{L}_\textrm{Gram} \end{equation}\]Data Curation
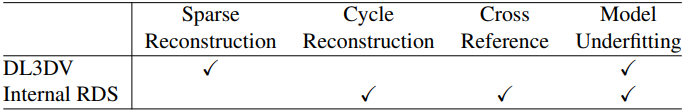
위의 loss 항들을 사용하여 모델을 학습시키기 위해서는, novel view synthesis에서 흔히 발생하는 아티팩트를 포함하는 이미지 쌍과 이에 대응하는 깨끗한 GT 이미지로 구성된 대규모 데이터셋이 필요하다. 간단한 전략은 매 $n$번째 프레임마다 3D 표현을 학습시키고 나머지 GT 이미지를 렌더링된 novel view와 쌍으로 묶는 것이다. 이러한 전략은 상당한 편차를 가진 novel view를 샘플링할 수 있는 DL3DV 데이터셋에서는 잘 작동한다. 그러나 대부분의 다른 novel view synthesis 데이터셋에서는, 학습 시점과 거의 동일한 영역을 관찰한다. 따라서 저자들은 학습 예제의 양을 늘리기 위한 다양한 전략을 탐구하였다.
Cycle Reconstruction
자율 주행 데이터셋에서 볼 수 있는 것과 같은 거의 선형적인 궤적의 경우, 먼저 원본 경로를 기반으로 NeRF를 학습시킨 다음, 수평으로 1~6미터 이동한 궤적에서 뷰를 렌더링한다. 이 렌더링된 뷰를 사용하여 두 번째 NeRF를 학습시키고, 이 두 번째 NeRF를 활용해 원본 카메라 궤적에 대한 저하된 뷰를 렌더링한다.
Model Underfitting
단순히 뷰를 제외하는 것보다 더 두드러진 아티팩트를 생성하기 위해, 원래 학습 일정의 25%~75%에 해당하는 epoch 수를 사용하여 재구성 모델을 underfitting한다. 그런 다음 이 underfitting된 재구성 모델에서 뷰를 렌더링하고 해당 GT 이미지와 짝을 맞춘다.
Cross Reference
다중 카메라 데이터셋의 경우, 하나의 카메라만을 사용하여 재구성 모델을 학습하고 나머지 제외된 카메라의 이미지를 렌더링한다. 유사한 ISP를 가진 카메라를 선택하여 시각적 일관성을 보장한다.
2. Difix3D+: NVS with Diffusion Priors
학습된 diffusion model은 inference 단계에서 렌더링된 novel view의 품질을 향상시키는 데 직접 적용될 수 있다. 그러나 모델의 생성적 특성으로 인해, 특히 관측이 부족하거나 노이즈가 많은 영역에서는 서로 다른 포즈나 프레임 간에 불일치가 발생한다.
이러한 문제를 해결하기 위해, 학습 과정에서 diffusion model의 출력을 3D 표현으로 다시 distillation한다. 이는 멀티뷰 일관성을 향상시킬 뿐만 아니라, 렌더링된 novel view의 품질을 높인다. 나아가 inference 단계에서 최종 neural enhancer 과정을 적용하여 잔여 아티팩트를 효과적으로 제거한다.
Difix3D: 점진적인 3D 업데이트
렌더링된 novel view와 레퍼런스 뷰에 대한 diffusion model의 강력한 컨디셔닝은 멀티뷰 일관성과 입력 시점에 대한 높은 충실도를 달성하는 데 매우 중요하다. 원하는 새로운 궤적이 입력 시점과 너무 멀리 떨어져 있으면 조건 신호가 약해지고 diffusion model은 잘못된 정보를 더 많이 얻게 된다. 따라서 저자들은 반복 학습 방식을 채택하여 novel view에 렌더링할 수 있는 3D 단서의 집합을 점진적으로 늘려 diffusion model의 컨디셔닝을 강화하였다.
구체적으로, 주어진 타겟 뷰 세트에 대해 레퍼런스 뷰를 사용하여 3D 표현을 최적화하는 것으로 시작한다. 1,500 iteration마다, 타겟 뷰 방향으로 실제 카메라 포즈를 약간씩 변경하고, 그 결과로 생성된 novel view를 렌더링한 다음, 학습된 diffusion model을 사용하여 렌더링을 개선한다. 개선된 이미지는 학습 데이터셋에 추가되어 다시 1,500 iteration의 학습을 진행한다. 이 점진적인 과정을 통해 레퍼런스 뷰와 타겟 뷰 간의 3D 단서 중첩을 단계적으로 늘릴 수 있으며, 궁극적으로 일관되고 아티팩트가 없는 렌더링 결과를 얻을 수 있다.
Difix3D+: 실시간 렌더링 후처리
Distillation한 향상된 novel view 이미지에는 멀티뷰 간의 미세한 불일치가 존재하고, 기존 재구성 방식은 선명한 디테일을 표현하는 데 한계가 있어 일부 영역이 여전히 흐릿하게 나타난다. 이러한 novel view 이미지를 더욱 개선하기 위해, 렌더링 시점에 diffusion model을 최종 후처리 단계로 활용한다. 그 결과, 높은 수준의 일관성을 유지하면서도 렌더링 품질이 향상된다. Difix는 single-step 모델이므로 NVIDIA A100 GPU 기준 추가 렌더링 시간이 76ms에 불과하다.
Experiments
1. In-the-Wild Artifact Removal
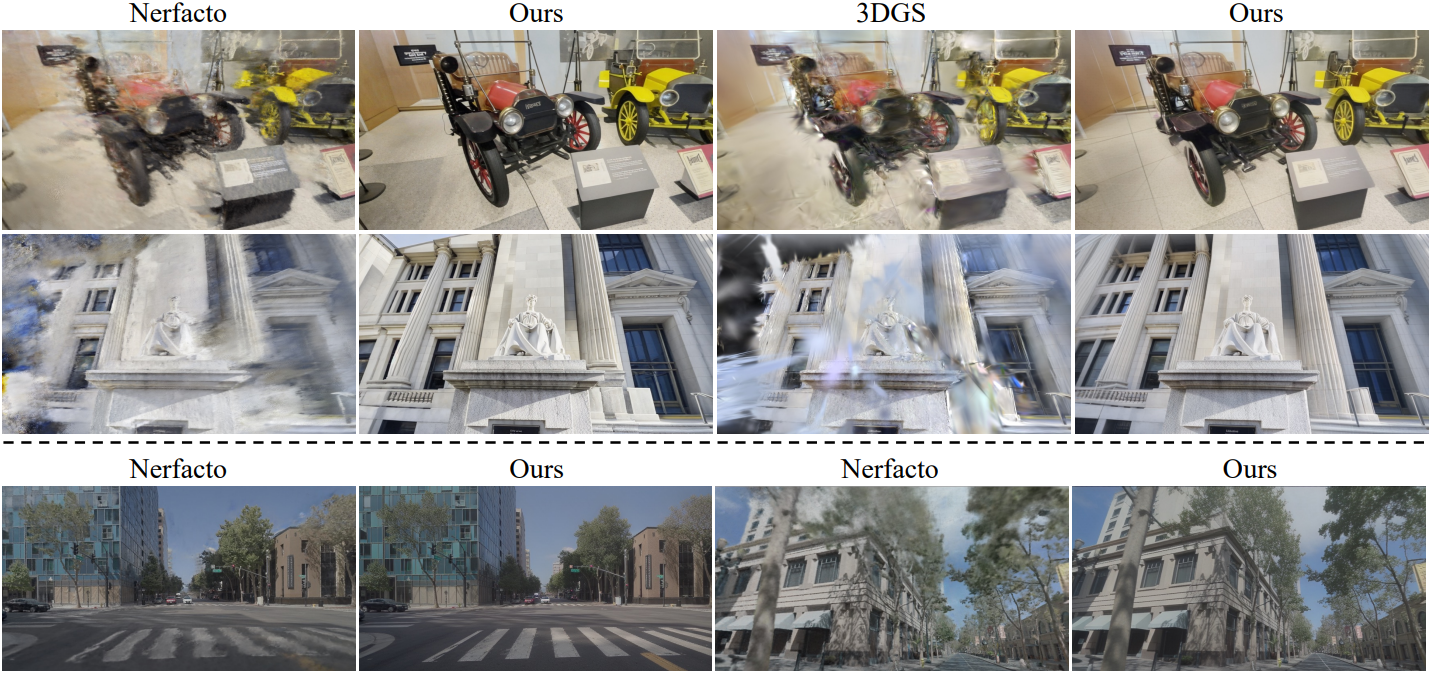
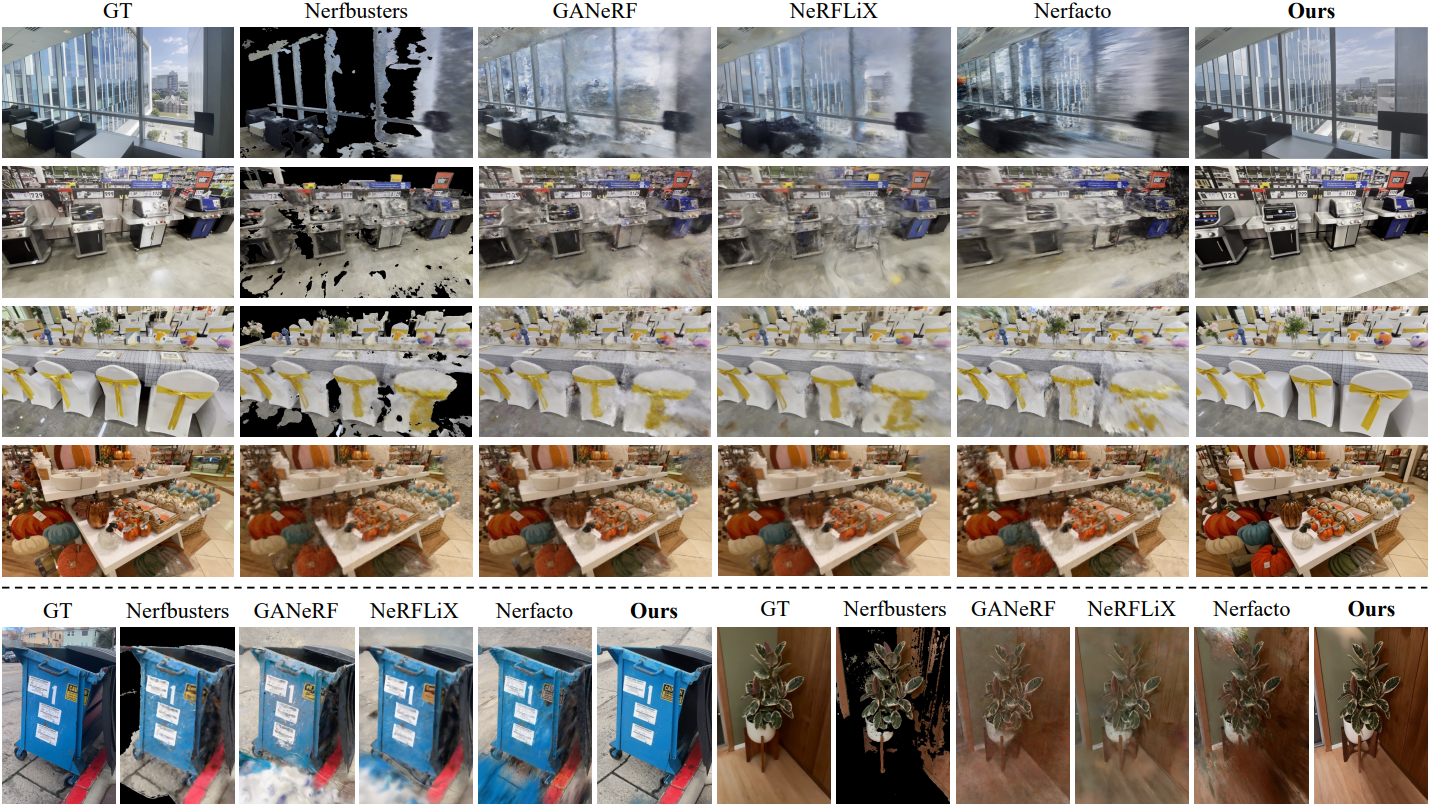
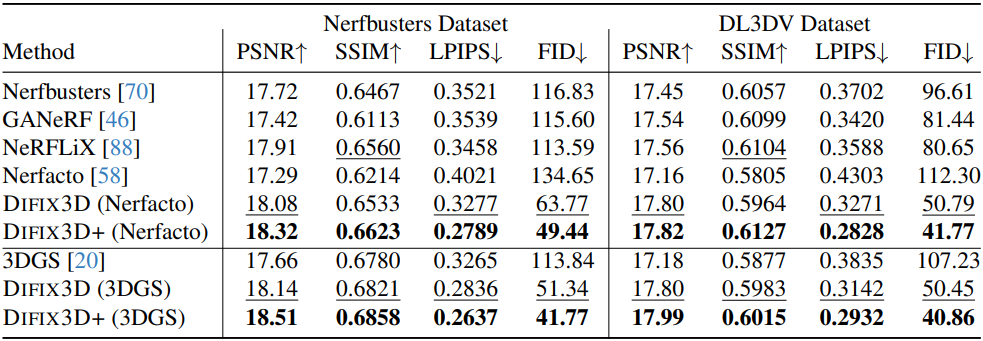
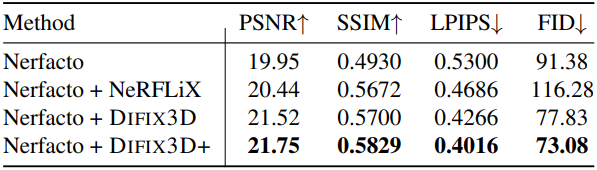
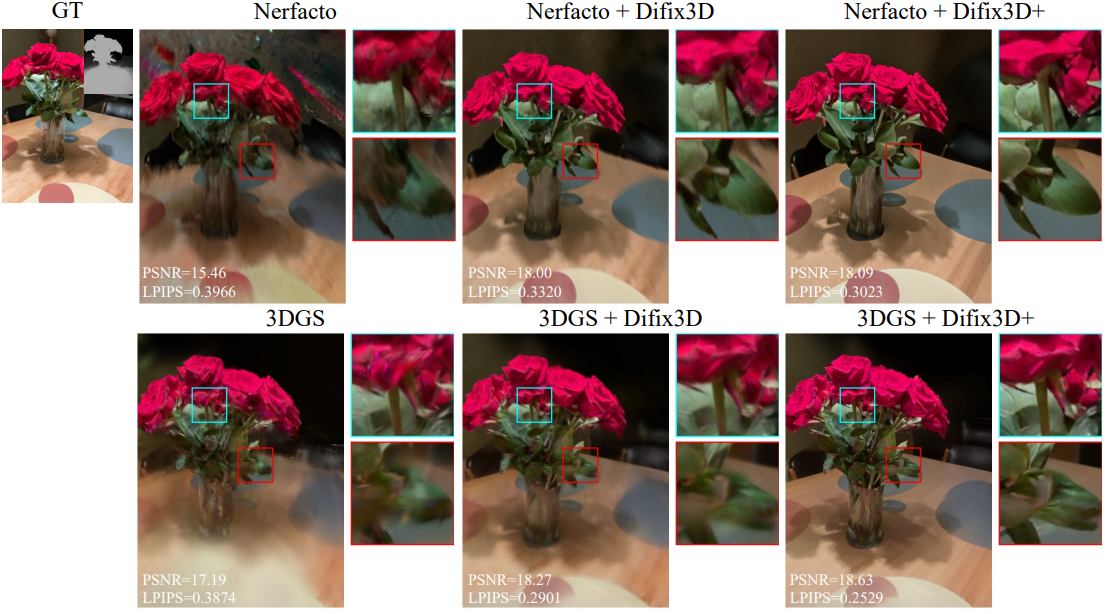
다음은 Nerfbusters와 DL3DV 데이터셋에 대한 비교 결과이다.
2. Automotive Scene Enhancement
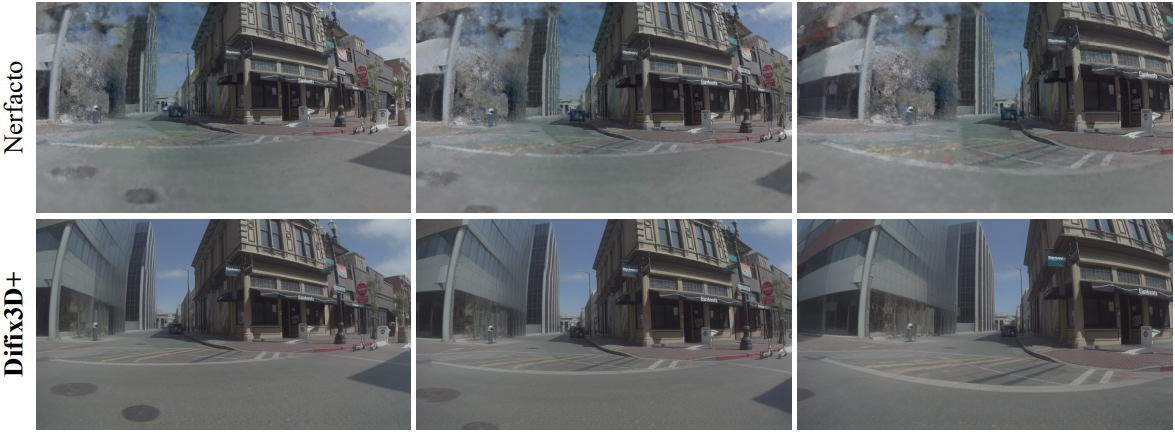
다음은 RDS 데이터셋에 대한 비교 결과이다.
3. Ablations
다음은 실시간 렌더링 후처리에 대한 ablation 결과이다.
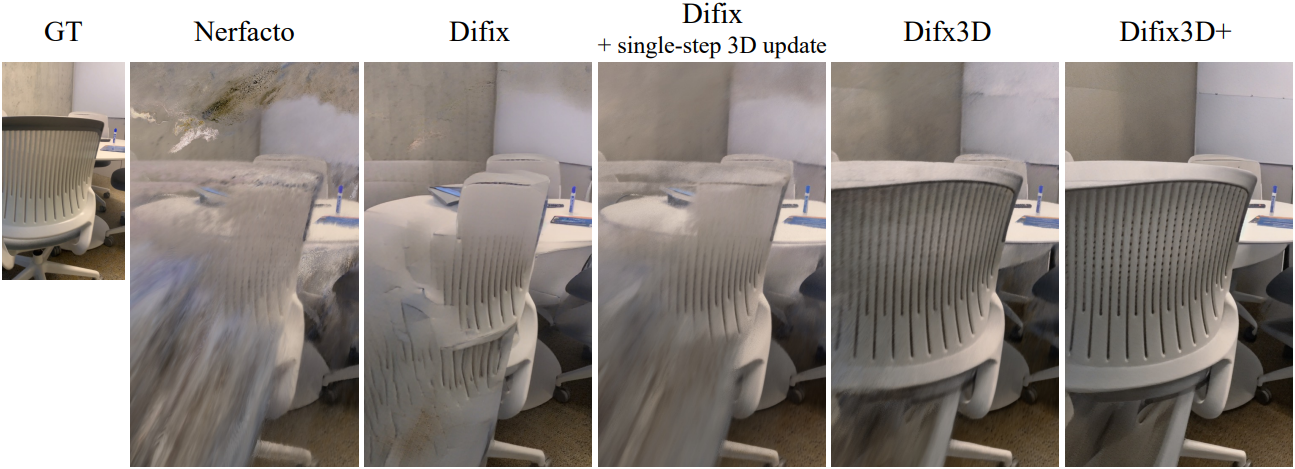
다음은 Difix3D+에 대한 ablation 결과이다.
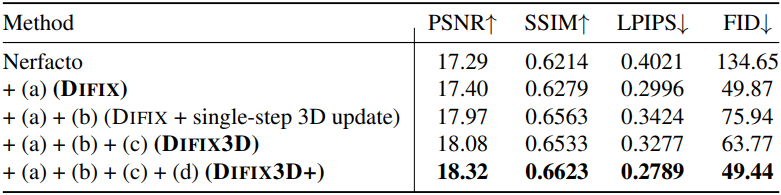
다음은 Difix 학습에 대한 ablation 결과이다.