[논문리뷰] 4D-RGPT: Toward Region-level 4D Understanding via Perceptual Distillation
CVPR 2026 (Highlight). [Paper] [Page] [Github]
Chiao-An Yang, Ryo Hachiuma, Sifei Liu, Subhashree Radhakrishnan, Raymond A. Yeh, Yu-Chiang Frank Wang, Min-Hung Chen
NVIDIA
18 Dec 2025
Introduction
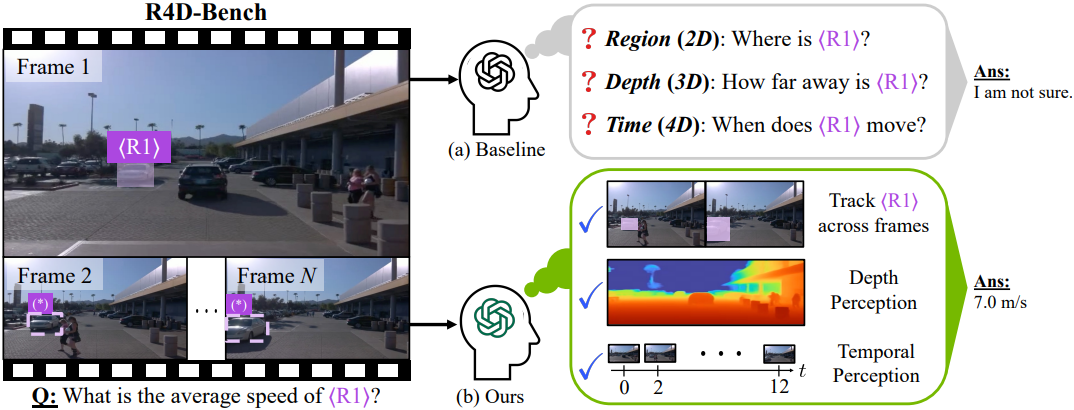
본 논문에서는 Region-level 4D Understanding이라는 까다로운 task를 해결하기 위해 MLLM을 발전시켰다. 이 문제는 두 가지 핵심 요소를 결합하고 있다.
- 4D 이해: 시간의 흐름에 따른 3D 공간 내의 깊이 정보, 시간적 변화, 또는 object 간 상호작용에 관한 질문에 답해야 한다.
- 영역 단위 이해: 제어 가능한 입력을 위해 언어 질문을 특정 시각적 영역에 대응(grounding)시켜야 한다.
Region-level 4D VQA는 자율 주행과 같이 4D 정보가 필수적이고 특정 영역을 정밀하게 지목하는 질문이 요구되는 분야에서 매우 중요하다.
이러한 과제를 해결하기 위해, 본 논문은 효과적인 4D perception과 그에 따른 향상된 4D 이해 능력을 갖춘 특화된 MLLM인 4D-RGPT를 제안하였다. 여기서 4D perception이란 깊이나 optical flow와 같은 low-level의 4D 지식을 추출하는 능력을 의미한다. 구체적으로, 4D-RGPT는 training-only 프레임워크인 Perceptual 4D Distillation (P4D)를 통해 4D 지식을 습득한다. P4D는 latent distillation과 explicit distillation 과정을 모두 채택하여, 4D teacher model의 4D 지식을 student model인 4D-RGPT로 효과적으로 전달한다. 특히 P4D는 학습 단계에서만 사용되는 모듈로만 구성되어 있어 inference 시 추가적인 비용이 발생하지 않는다. 또한 저자들은 명시적인 시간적 단서를 제공하여 MLLM의 시간적 지각 능력을 향상시키는 Timestamp Positional Encoding (TPE)을 도입하였다.
최근 다양한 3D/4D VQA 벤치마크가 제안되었으나, 이들은 흔히 특정 영역에 대한 질문이나 4D 공간에 대한 충분한 이해를 요구하는 과제가 부족하다. 이러한 한계는 4D 컨텍스트 내 특정 영역에 관한 질문에 답하는 능력에 대한 포괄적인 평가를 어렵게 만든다. 본 논문에서는 영역 기반 4D 질문을 포함하며 정적 및 동적 장면 이해 task를 모두 아우르는 새로운 벤치마크인 R4D-Bench를 구축했다.
Method
1. 4D-RGPT
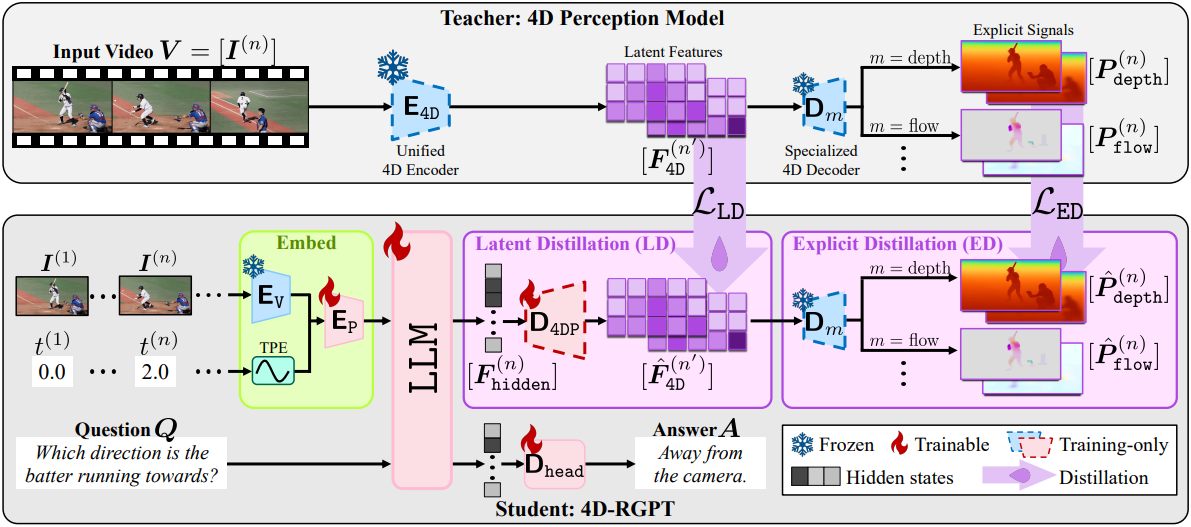
$N$개의 샘플링된 프레임 \(\{\textbf{I}^{(n)}\}_{n=1}^N\)과 각 프레임의 타임스탬프 \(\{t^{(n)}\}_{n=1}^N\)을 포함하는 입력 동영상 $\textbf{V}$가 주어졌을 때, 4D-RGPT는 P4D에서의 distillation을 위한 4D 표현을 추출할 수 있는, 학습 단계에서만 사용되는 4D 인식 모듈들로 구성된다. 또한, 4D-RGPT는 입력 visual feature에 timestamp positional encoding (TPE)을 통합함으로써 시간적 진행을 인식할 수 있다.
Latent 4D Representations
P4D를 위한 latent 4D 표현을 포착하기 위해, 입력 동영상에서 \(\hat{\textbf{F}}_\textrm{4D}\)를 추출한다. 각 프레임 $\textbf{I}^{(n)}$은 동영상 인코더 \(\textbf{E}_\textrm{V}\), multi-modal projector \(\textbf{E}_\textrm{P}\), 그리고 LLM을 거쳐 hidden state feature \(\textbf{F}_\textrm{hidden}^{(n)} \in \mathbb{R}^{hw \times c}\)로 인코딩된다.
Latent 4D 표현 \(\hat{\textbf{F}}_\textrm{4D}^{(n)}\)를 디코딩하기 위해, MLLM 위에 4D perception 디코더 \(\textbf{D}_\textrm{4DP}\)로서 training-only MLP를 도입한다. 구체적으로, 먼저 목표 shape인 $(N^\prime, h^\prime, w^\prime)$에 맞도록 hidden feature \(\textbf{F}_\textrm{hidden}^{(n)}\)을 샘플링하고 resize한다. 따라서 각 다운샘플링된 프레임 $n^\prime \in [1, N^\prime]$에 대해 다음과 같은 결과를 얻는다.
\[\begin{equation} \hat{\textbf{F}}_\textrm{4D}^{(n^\prime)} = \textbf{D}_\textrm{4DP} \left( \textrm{Rearrange} (\textbf{F}_\textrm{hidden}^{(n)}) \right) \end{equation}\]Explicit 4D Representations
\(\hat{\textbf{F}}_\textrm{4D}\)는 풍부한 4D feature를 포착할 수 있지만, depth map과 같은 명시적인 4D 신호는 해석이 더 용이하고 명확한 supervision을 제공한다. P4D에 대한 명시적인 4D 표현을 얻기 위해, 고정된 4D perception 모델의 training-only prediction head \(\textbf{D}_\textrm{m}\)을 통해 \(\hat{\textbf{F}}_\textrm{4D}\)가 주어졌을 때 명시적인 4D 신호 \(\hat{\textbf{P}}_\textrm{m}\)을 추출한다.
\[\begin{equation} \hat{\textbf{P}}_\textrm{m} = \textbf{D}_\textrm{m} (\hat{\textbf{F}}_\textrm{4D}) \end{equation}\]Timestamp Positional Encoding (TPE)
사건이 언제 발생했는지, 특정 행동이 얼마나 지속되었는지와 같은 정확한 시간적 인식은 4D VQA의 핵심 요소이다. MLLM이 깊이를 인식하고 변위를 파악할 수 있다 하더라도, 평균 속도를 계산하기 위해서는 해당 동영상의 시간 길이를 이해해야 한다.
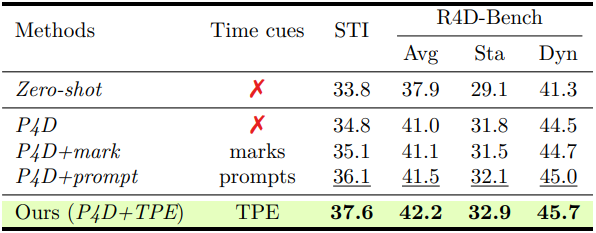
명시적인 시간 단서가 없을 때 MLLM이 시간 인식에 어려움을 겪는다. 시간 단서를 제공하기 위해 타임스탬프를 위치 인코딩으로 MLLM의 시각적 입력에 직접 인코딩한다. 즉, 동영상 $\textbf{V}$에서 시간 $t^{(n)}$에 샘플링된 각 입력 프레임 $\textbf{I}^{(n)}$에 대해, visual feature \(\textbf{E}_\textrm{V} (\textbf{I}^{(n)})\)에 Timestamp Positional Encoding (TPE) \(\textbf{p}^{(n)} \in \mathbb{R}^D\)를 더한 후 이를 \(\textbf{E}_\textrm{P}\)에 입력한다.
\[\begin{equation} \textbf{p}^{(n)} [2i] = \sin \left( \frac{t^{(n)}}{T^{\frac{2i}{D}}} \right), \quad \textbf{p}^{(n)} [2i+1] = \cos \left( \frac{t^{(n)}}{T^{\frac{2i}{D}}} \right) \end{equation}\]($T$는 최대 timescale, $i$는 인덱스)
2. Perceptual 4D Distillation (P4D)
4D 관련 질문에 답하기 위해 MLLM은 semantic한 컨텐츠뿐만 아니라 서브픽셀 단위의 움직임이나 수치적 깊이 값과 같은 4D 지식의 다양한 측면을 이해해야 한다. 최근 3D/4D 특화 MLLM들은 자체 구축한 학습 데이터셋에 의존하거나 외부 모델을 활용하여 3D 지식을 보강하는 방식을 취하고 있다. 그러나 이러한 방법들만으로는 MLLM이 4D를 온전히 이해하기에 부족하다. 게다가 외부 모듈을 도입하면 inference 비용이 추가로 발생한다. 따라서 별도의 모듈을 추가하지 않고도 MLLM의 내부적인 4D perception 능력을 직접적으로 학습시킬 수 있는 메커니즘이 필요하다.
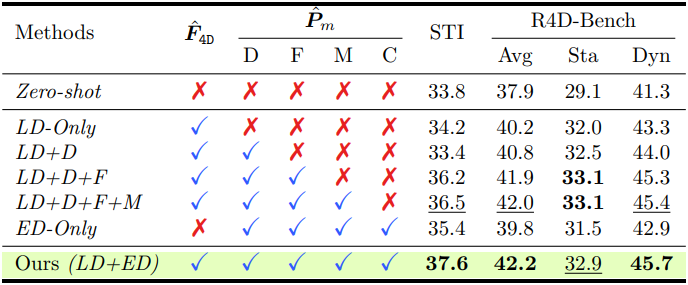
이를 위해 저자들은 P4D 프레임워크를 제안하였다. 구체적으로, L4P를 고정된 4D teacher model로 활용하여, 해당 모델의 4D 표현을 student model인 4D-RGPT로 전달한다. 포괄적인 knowledge transfer를 보장하기 위해, latent distillation과 explicit distillation으로 구성된 dual-branch distillation 방식을 사용한다.
Latent Distillation
Latent space에서 MLLM의 latent 4D 표현 \(\hat{\textbf{F}}_\textrm{4D}\)을 학습시키기 위한 latent distillation을 도입한다. Latent distillation은 latent space상에서 MLLM에게 중간 단계의 4D guidance를 제공하는 역할을 한다.
구체적으로, latent distillation loss $\mathcal{L}_{LD}$는 teacher model의 latent 4D feature \(\textbf{F}_\textrm{4D}\)와 student model의 latent 4D feature \(\hat{\textbf{F}}_\textrm{4D}\) 간의 차이 \(\Delta_\textrm{4D}\)를 좁히도록 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{LD} = \sum_{n^\prime = 1}^{N^\prime} \Delta_\textrm{LD} (\textbf{F}_\textrm{4D}^{(n^\prime)}, \hat{\textbf{F}}_\textrm{4D}^{(n^\prime)}) \end{equation}\]Explicit Distillation
MLLM의 명시적 4D 표현 \(\hat{\textbf{P}}_m\)을 학습시키기 위한 explicit distillation을 도입한다. Explicit distillation은 MLLM이 $\mathcal{M}$ 내의 정확한 4D 신호를 포착하도록 보장하기 위해 직접적이고 해석 가능한 supervision을 제공한다.
구체적으로, explicit distillation loss $\mathcal{L}_\textrm{ED}$는 teacher model의 명시적 4D 신호 \(\textbf{P}_m\)와 student model의 명시적 4D 신호 \(\hat{\textbf{P}}_m\) 간의 차이 \(\Delta_m\)을 좁히도록 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{ED} = \sum_{n=1}^N \sum_{m \in \mathcal{M}} \lambda_m \Delta_m (\textbf{P}_m^{(n)}, \hat{\textbf{P}}_m^{(n)}) \end{equation}\](\(\lambda_m\)은 각 $m$에 대한 loss 가중치)
Training
저자들은 RoboFAC, SAT, VSTIBench (training split), Wolf를 포함한 다양한 3D/4D 대화 데이터셋에 SFT와 P4D를 모두 활용하여 4D-RGPT를 최적화시켰다. 전체 loss는 표준 cross-entropy SFT loss \(\mathcal{L}_\textrm{SFT}\), latent distillation loss \(\mathcal{L}_\textrm{LD}\), explicit distillation loss \(\mathcal{L}_\textrm{ED}\)의 조합으로 구성된다.
3. R4D-Bench
여러 3D/4D VQA 벤치마크는 MLLM이 깊이를 지각하거나 object 간의 3D 상호작용을 이해할 것을 요구한다. 그러나 기존 벤치마크들은 복잡한 실제 환경에서의 4D 영역 기반 이해 능력을 평가하지는 못한다. 이들 벤치마크는 다음과 같은 핵심적인 특성을 결여하고 있다.
- 동적 장면 부족: 대부분의 모델은 object 간 상호작용이 최소화되거나 움직임이 제한된 실내 장면에 초점을 맞추고 있어 실제 object 조작 및 동적 변화의 복잡성을 충분히 반영하지 못한다.
- 영역 프롬프트 부족: 영역 프롬프트는 VQA에서 사용자가 직관적이고 제어된 방식으로 질문할 수 있도록 한다. 이 기능이 없으면 MLLM의 해석 가능성과 실제 응용 분야에서의 유용성이 저해된다.
이러한 격차를 해소하기 위해, 본 논문은 깊이 및 시간적 인식이 핵심적인 region-level 4D VQA를 통해 MLLM의 성능을 시험하는 새로운 벤치마크인 R4D-Bench를 도입하였다.
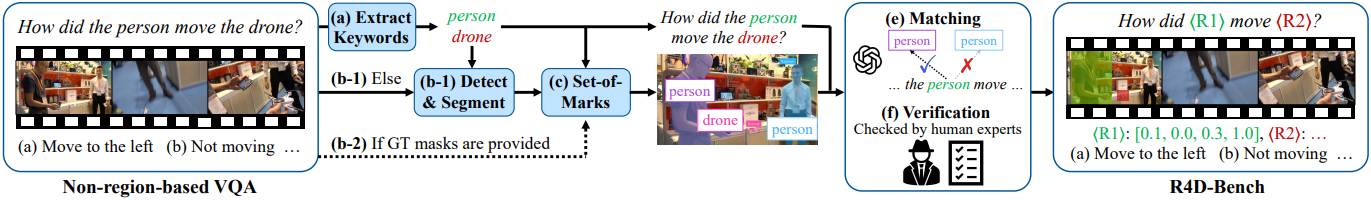
기존의 non-region 4D VQA 벤치마크(STI-Bench, VLM4D)가 주어졌을 때, R4D-Bench의 데이터 큐레이션 파이프라인은 다음과 같다.
- Qwen2.5-VL로 질문에서 명사 키워드를 추출해 관심 object 후보로 설정한다.
- GT segmentation mask가 제공되는 경우 이를 바로 사용하고, 그렇지 않은 경우에는 GroundingDINO와 SAM2를 사용하여 각 관심 object의 segmentation mask를 추출한다.
- 첫 번째 프레임에 대한 Set-of-Mark (SoM) 이미지를 생성한다.
- SoM 이미지와 처리된 질문을 Qwen2.5-VL에 입력하여, 질문에 언급된 object와 해당 영역을 매칭한다.
- 생성된 매칭 결과는 사람에 의해 검증된다.
Experiments
1. Main Results
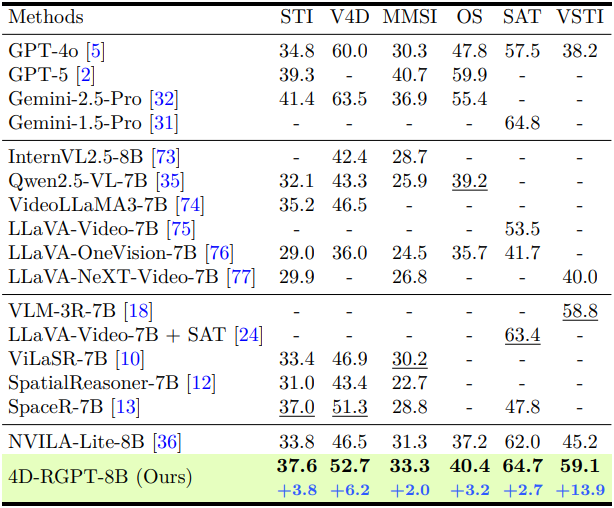
다음은 non-region 3D/4D 벤치마크에서의 비교 결과이다.
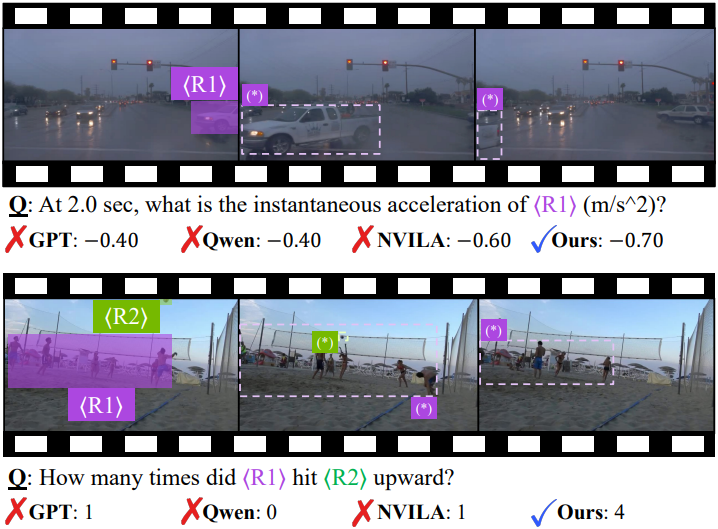
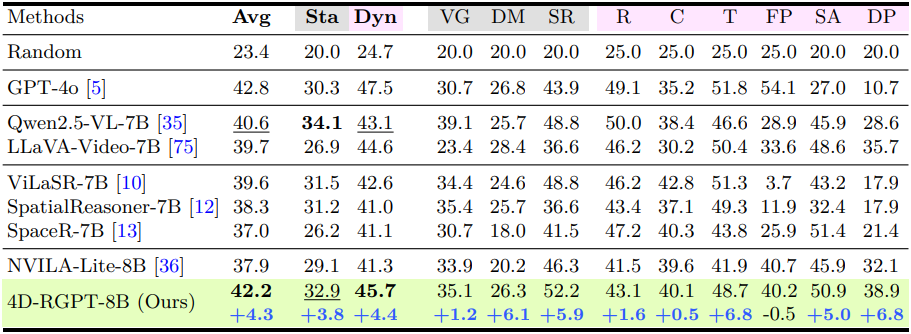
다음은 R4D-Bench에서의 비교 결과이다.
2. Ablation Studies
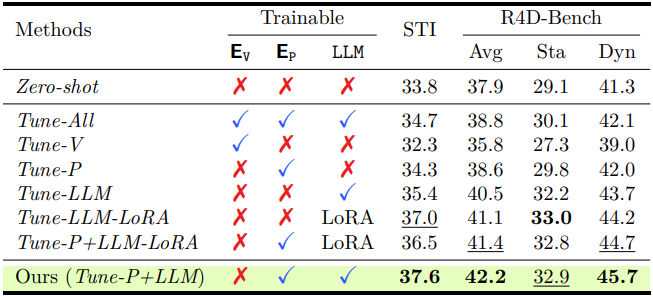
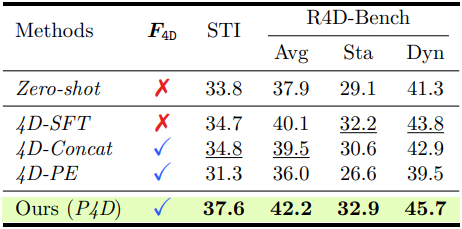
다음은 4D VQA를 위한 대체 전략과의 비교 결과이다.
다음은 4D 모달리티에 대한 ablation study 결과이다.
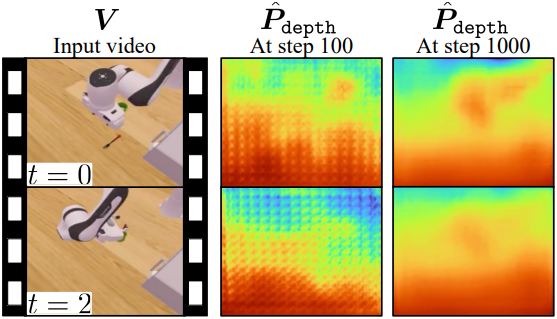
다음은 예측된 depth map \(\hat{\textbf{P}}_\textrm{depth}\)를 시각화한 것이다.
다음은 TPE에 대한 ablation study 결과이다.
다음은 다양한 학습 설계에 대한 ablation study 결과이다.