[논문리뷰] Towards Learning to Complete Anything in Lidar
ICML 2025. [Paper] [Page]
Ayca Takmaz, Cristiano Saltori, Neehar Peri, Tim Meinhardt, Riccardo de Lutio, Laura Leal-Taixé, Aljoša Ošep
NVIDIA | ETH Zurich | Carnegie Mellon University
16 Apr 2025
Introduction
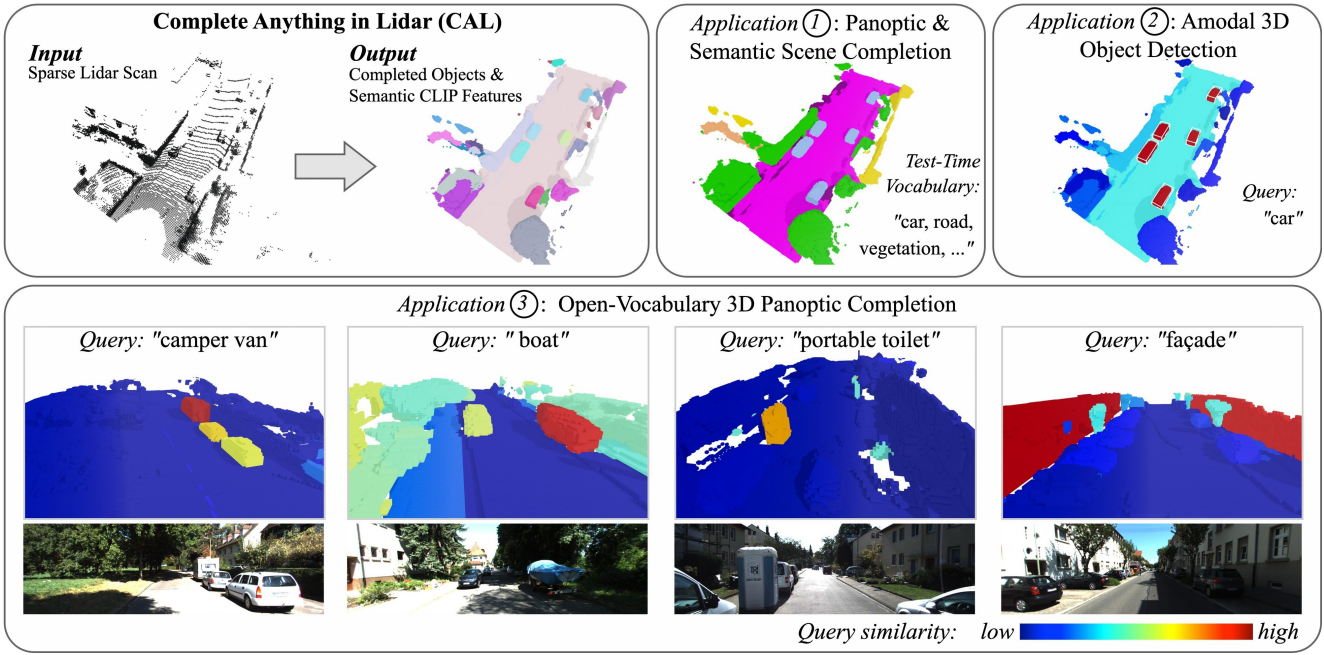
기존 방법들은 LiDAR 데이터셋에 레이블링된 약 20개 클래스에 대해서만 위치를 파악하고 복원할 수 있다. 이와 달리, 본 논문에서는 LiDAR 시퀀스의 시간적 컨텍스트에서 object shape prior를 학습시킴으로써 일반적인 고정 분류 체계를 넘어 확장하였다. 이를 위해서는 공간과 시간에서 object와 영역을 분할한 후, 시간적 집계를 통해 3D shape 추정치를 얻어야 한다. 3D reconstruction을 위해서는 object tracking 정확성이 매우 중요하다. Tracking 오차는 부정확하거나 불완전한 shape으로 이어질 수 있다. Object의 위치가 공간과 시간에서 정확하게 파악되더라도 object 단위의 시간적 정합(registration)은 어려운 과제이다.
본 논문에서는 이미지 및 동영상 segmentation foundation model을 활용하여 동영상에서 object의 위치를 파악하고 추적한다. 모든 object를 분할하고 추적한 후, 각 masklet을 LiDAR 공간으로 변환하고, 자율 주행 차량 포즈를 사용하는 calibration된 멀티모달 센서 설정을 통해 시간에 따라 통합한다. Zero-shot 인식을 가능하게 하기 위해, 각 masklet에 대해 timestep으로 평균화된 CLIP feature를 추가로 추출하여 완성된 shape과 semantic 정보를 효과적으로 연결한다. Object는 부분적으로만 완성될 수 있으며, 모든 object가 정적이지 않다. 하지만 실제로는 이러한 부분적인 관찰을 통해 정적 및 동적 object를 완전히 완성하는 방법을 학습시킨다.
저자들은 이렇게 추출된 pseudo-label 쌍을 활용하여 instance-level completion 네트워크를 학습시켰다. 구체적으로, sparse encoder-decoder 네트워크를 사용하여 고정 크기 voxel grid 내의 장면 단위 occupancy 정보를 학습시킨다. 개별 object 인스턴스를 분할하기 위해, class-agnostic 방식으로 점유된 voxel space 내 인스턴스 마스크를 예측하는 디코더를 학습시킨다. 마지막으로, 예측된 각 인스턴스에 대해 CLIP 토큰을 예측함으로써 object의 semantic 정보를 고정 차원의 임베딩 벡터로 포착하며, 이를 통해 test-time에 zero-shot 프롬프팅이 가능하다.
Method
1. Mining 3D Shape Priors From Unlabeled Data
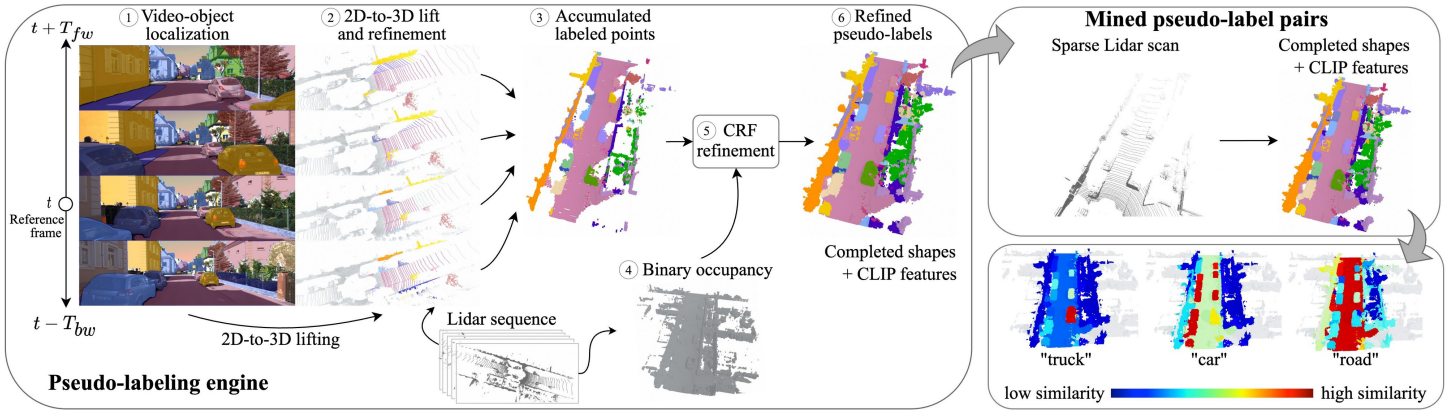
부분적인 장면 관측 정보를 포함하는 LiDAR 스캔 $P$가 주어졌을 때, 본 논문에서 제시하는 shape-mining pseudo-labeler는 각 voxel이 비어 있거나, 레이블이 지정되지 않았거나, 관측된 인스턴스에 할당될 수 있는 occupancy grid $O$를 생성한다. 각 인스턴스는 시간에 따른 각 지점별 인스턴스 관측값을 누적하는 3D occupancy grid \(O_k : \mathbb{R}^4 \rightarrow \mathbb{N}^3\)로 표현된다. 또한, 각 $O_k$에는 인스턴스의 geometry와 vision-language feature를 연결하는 semantic CLIP feature $f_k$가 함께 제공된다.
Key challenge
본 논문의 접근 방식은 도로 주행 중 시간적 컨텍스트를 통해 object 형태를 추론할 수 있다는 관찰에 기반한다. 그러나 object별 shape prior를 획득하려면 정밀한 object 위치 추정, 추적, 그리고 정확한 object 단위 registration이 필요한데, 이는 registration 오류나 drift에 민감하여 해결하기 까다로운 문제이다.
Video-object localization
이를 위해 segmentation foundation model을 활용한다. RGB 이미지 $I_t \in \mathbb{R}^{W \times H \times 3}$로 구성된 동영상 시퀀스 $v$가 주어졌을 때, 먼저 그리드 기반 프롬프트를 사용하는 SAM을 이용하여 이미지를 분할하고, 시간 $t$에 관찰된 레퍼런스 이미지의 object 집합을 나타내는 2D mask proposal 집합 \(m_{t,k}^\textrm{2D} \in \{0, 1\}^{W \times H}\)를 얻는다.
그런 다음, 동영상 segmentation model SAM 2를 사용하여 시간 $t$의 레퍼런스 프레임에서 주어진 temporal window 내의 프레임으로 마스크를 전파한다. 이를 통해 다양한 시점의 관찰 결과를 통합할 수 있다. 최종 결과는 동영상에서 시간적 인스턴스 연결을 제공하는 $K$개 이하의 클래스 독립적인 masklet 집합이다.
Semantic feature aggregation
저자들은 MaskCLIP의 방식을 따라 per-instance CLIP feature를 계산하고, 마스크 정보를 활용하여 시간 영역에서 이들을 통합함으로써 멀티뷰 vision-language feature를 획득한다. 이후 이 feature들을 정규화하고 평균을 내어, 레퍼런스 프레임 $t$ 내의 각 누적 shape $k$에 대한 feature 벡터 \(f_k \in \mathbb{R}^F\)를 구한다($F$는 CLIP 임베딩 차원).
Lift and refine
Temporal window 내의 각 프레임에 대해, 제공된 camera-to-Lidar transformation을 사용하여 각 2D 마스크 $m_{t,k}^\textrm{2D}$를 Lidar 좌표계로 backprojection함으로써 각 인스턴스 $k$에 대한 3D 마스크 \(m_{t,k}^\textrm{3D} \in \{0, 1\}^{X \times Y \times Z}\)를 획득한다. 이러한 마스크는 불완전한 calibration이나 롤링 셔터로 인해 projection 아티팩트가 발생할 수 있다. 따라서 정밀한 위치 추정을 위해 SAL이 제안한 단일 프레임 마스크 정교화 절차를 따른다.
Temporal aggregation
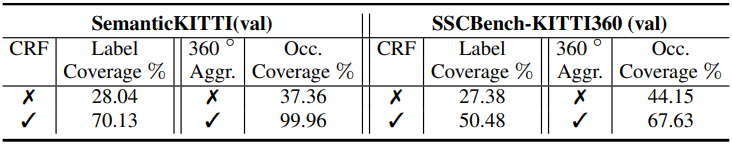
LiDAR 시퀀스에서 마스크 $m_{t,k}^\textrm{3D}$의 위치를 파악한 후, 알고 있는 포즈를 사용하여 레퍼런스 좌표계로 projection하고 시간에 따라 누적하여 dense한 마스크 $m_k^\textrm{3D}$를 얻는다. 각 $m_k^\textrm{3D}$를 voxelize하여 인스턴스별 occupancy $O_k$를 얻고 다수결 투표를 통해 인스턴스 인덱스를 할당한다. $O_k$에만 의존하는 것은 제한적인 정보 제공만을 가능하게 한다. 레이블 커버리지를 개선하기 위해 360° LiDAR 포인트를 직접 누적하여 얻은 binary occupancy 신호를 $O_k$에 보완적으로 사용한다.
CRF refinement
레이블 커버리지를 더욱 향상시키기 위해, binary occupancy를 기반으로 구축된 Conditional Random Fields (CRF)을 사용하여 인스턴스 마스크를 정교화한다.
2. Learning To Complete Objects
CAL은 장면 geometry에 대한 sparse하고 불완전한 관측값을 담은 단일 입력 LiDAR 스캔 $P$를 받아, voxel occupancy 및 인스턴스 ID로 표현되는 완성된 object 인스턴스 집합을 출력한다. 각 인스턴스 ID에는 예측된 semantic feature가 함께 제공되는데, 이를 통해 인스턴스의 semantic feature를 test-time에 주어진 클래스 vocabulary와 매칭할 수 있다. PaSCo와 달리, stuff 클래스와 thing 클래스를 구분하지 않는다. 즉, 자동차, 도로, 그리고 나무 등을 모두 개별 인스턴스로 취급한다.
Model architecture
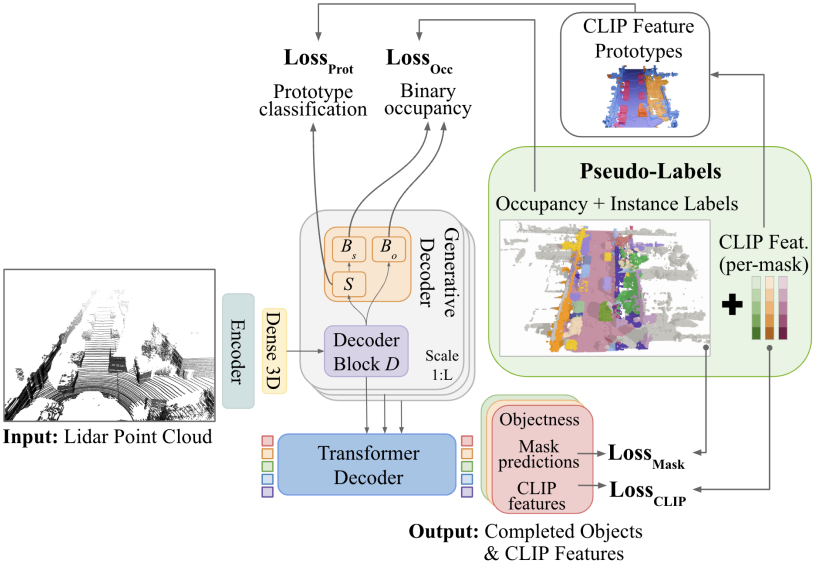
저자들은 PaSCo의 방식을 따라, 장면 수준의 occupancy를 추정하는 sparse-generative 3D U-Net 아키텍처와 점유된 voxel에서 직접 작동하는 Transformer instance decoder를 사용하였다. Backbone은 sparse feature encoder와 그 뒤를 잇는 dense 3D convolutional block으로 구성된다. Multi-scale generative decoder는 세 가지 해상도 레벨 \(L \in \{1, 2, 4\}\)에서 occupancy를 추정하는 3개의 decoder block $D^{1:L}$를 사용한다. Transformer decoder의 입력은 voxel space에서 디코더가 학습한 다중 해상도 feature와 상호작용하는 learnable query들의 집합이다. Zero-shot 인식을 지원하기 위해, 각 query에 대해 objectness score, segmentation mask, CLIP feature를 추정한다.
Generative decoder, completion heads & CLIP feature prototypes
장면을 정확하게 완성하는 데 핵심적인 요소는 sparsity를 유지하기 위해 pruning layer가 삽입된 3개의 decoder block으로 구성된 sparse generative decoder이다. 각 decoder block $D^{1:L}$은 스케일 $L$에서의 feature를 제공하며, 이 feature는 binary occupancy head $B_o$가 해당 스케일에서의 장면 occupancy를 예측하는 데 사용된다.
Pseudo-label을 사용하여 현재 모델을 학습하는 데에는 두 가지 주요 문제가 있다.
- 부분적으로 완성된 pseudo-label은 학습이 잘 커버된 영역으로 치우치게 한다.
- 인스턴스의 semantic grouping이 부족하여 shape prior 학습이 어려워진다.
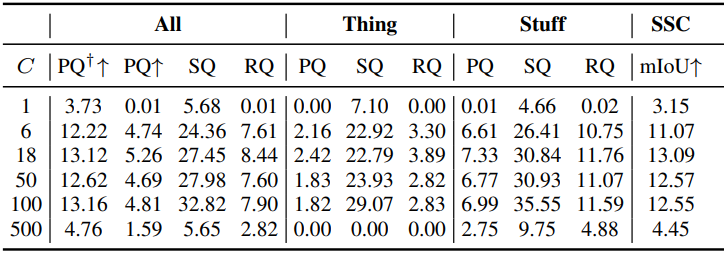
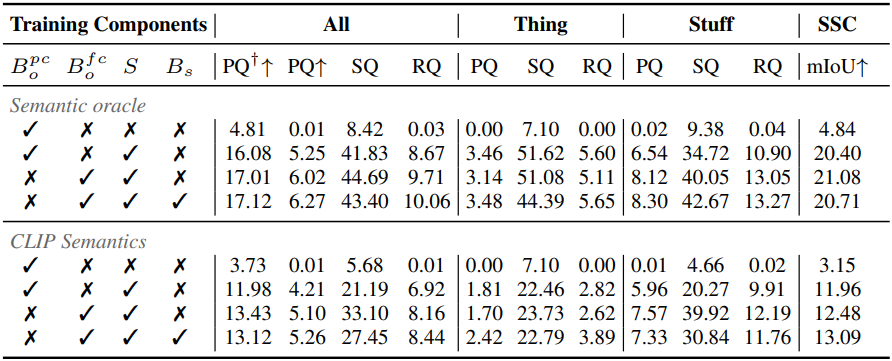
첫 번째 문제는 $B_o$에 binary occupancy 정보를 제공함으로써 해결한다. 두 번째 문제는 인스턴스 CLIP feature를 클러스터링을 통해 $C$개의 pseudo-prototype으로 quantize하고, 각 점유 voxel에 대한 prototype 클래스를 예측하는 추가적인 semantic head $S$를 도입함으로써 해결한다. Prototype 예측은 학습 중에만 사용하며, 테스트 시에는 zero-shot 인식을 위해 예측된 CLIP feature만 사용한다.
또한, 저자들은 클래스별 logit을 처리하고 이를 binary occupancy 예측으로 변환하는 방법을 학습하는 두 번째 occupancy head $B_s$를 추가했다. $B_s$를 추가함으로써 학습이 더욱 정규화된다.
Training
본 논문에서는 완성된 binary occupancy, 인스턴스 마스크 예측, CLIP feature distillation, voxel별 프로토타입 할당을 위해 네트워크를 통합적으로 학습시켰다. 각 학습 iteration에서 디코더는 각 스케일 $L$에 대해 coarse-to-fine voxel grid를 생성하며, 이때 binary occupancy loss \(\mathcal{L}_\textrm{occ}\)와 prototype classification loss \(\mathcal{L}_\textrm{prot}\)을 통해 학습이 이루어진다.
Transformer decoder는 mask-loss \(\mathcal{L}_\textrm{mask}\)와 feature distillation loss \(\mathcal{L}_\textrm{CLIP}\)을 기반으로 학습되며, 인스턴스 마스크와 CLIP feature를 생성한다. \(\mathcal{L}_\textrm{mask}\)의 경우, Hungarian matching을 수행하여 예측된 인스턴스 마스크와 pseudo-label이 있는 인스턴스 마스크를 매칭한다. 이때 pseudo-label이 없는 영역에 대한 예측으로 인해 네트워크가 불이익을 받지 않도록, Hungarian matching 및 \(\mathcal{L}_\textrm{mask}\)와 \(\mathcal{L}_\textrm{prot}\) 계산 과정에서 레이블이 없는 voxel은 제외한다.
최종 학습 loss는 \(\mathcal{L}_\textrm{occ}\), \(\mathcal{L}_\textrm{prot}\), \(\mathcal{L}_\textrm{CLIP}\), \(\mathcal{L}_\textrm{mask}\)의 가중 합으로 정의된다.
\[\begin{equation} \mathcal{L} = \lambda_\textrm{occ} \mathcal{L}_\textrm{occ} + \lambda_\textrm{prot} \mathcal{L}_\textrm{prot} + \lambda_\textrm{CLIP} \mathcal{L}_\textrm{CLIP} + \lambda_\textrm{mask} \mathcal{L}_\textrm{mask} \end{equation}\]Inference
LiDAR 포인트 클라우드를 입력으로 받아, CAL은 voxel grid 상의 object 인스턴스 마스크 집합과 각 예측 인스턴스에 대한 CLIP feature를 생성한다. 이때 overlap threshold \(\tau_\textrm{ovr}\)을 사용하여 겹치는 작은 마스크를 제거하고, objectness threshold \(\tau_\textrm{obj}\)를 통해 신뢰도가 낮은 마스크를 필터링한다.
또한 예측된 CLIP feature를 활용하여 각 쿼리를 zero-shot 방식으로 분류한다. CLIP 텍스트 인코더를 사용하여 semantic vocabulary를 인코딩한 다음, 예측된 CLIP feature와 인코딩된 텍스트 설명 간의 코사인 유사도를 계산함으로써 각 query에 대한 해당 vocabulary의 posterior를 산출한다.
Experiments
1. Experimental results
다음은 SemanticKITTI에서의 비교 결과이다.
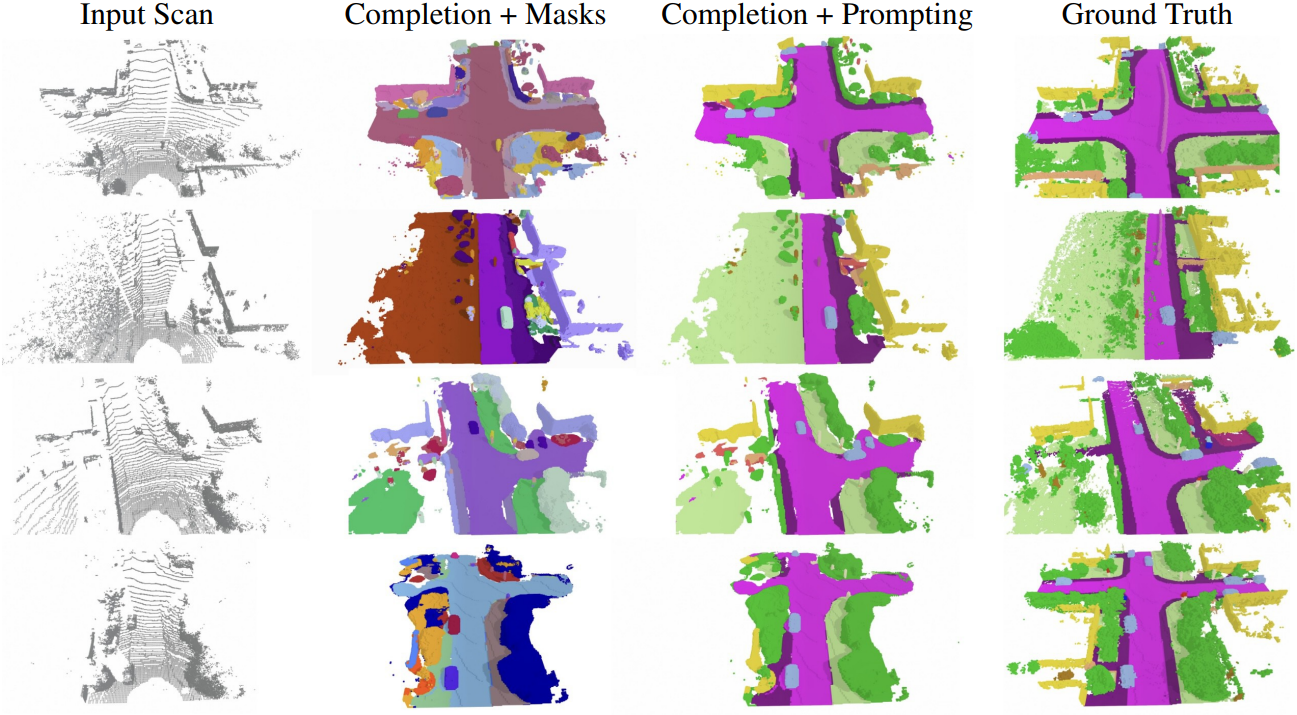
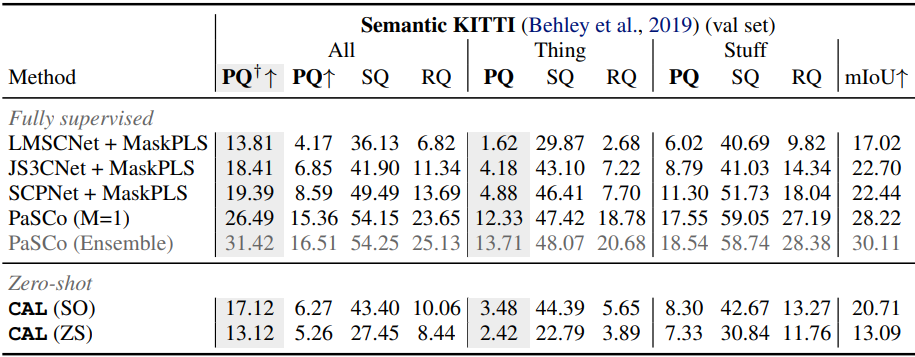
다음은 KITTI-360에서의 결과이다.
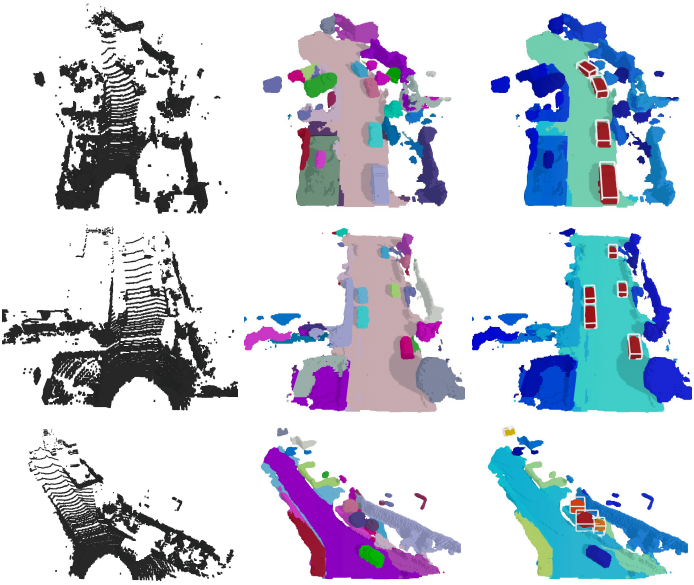
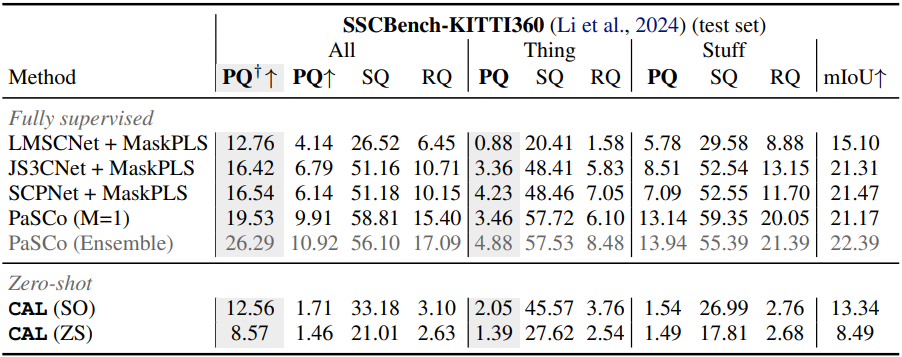
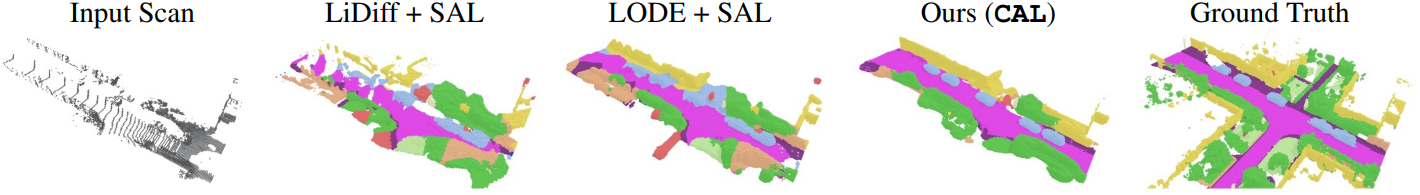
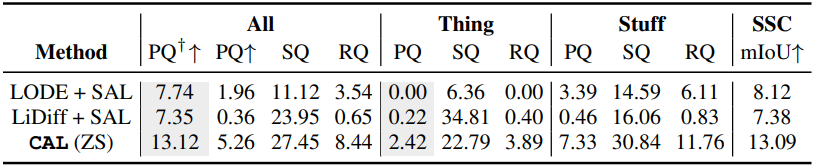
다음은 SemanticKITTI에서 zero-shot baseline과 비교한 결과이다.
2. Pseudo-labeling engine analysis
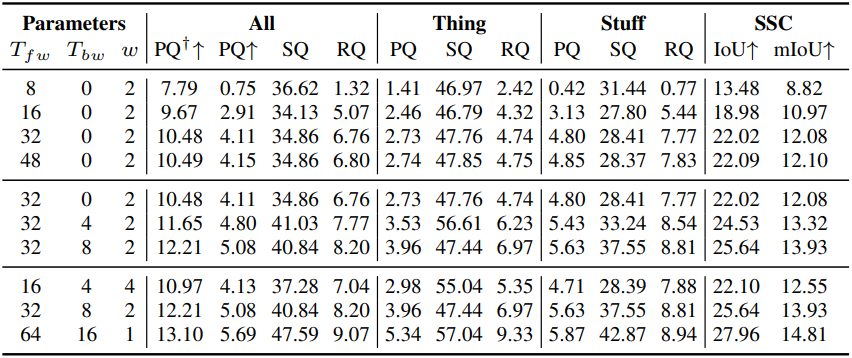
다음은 pseudo-labeling 엔진에 대한 ablation 결과이다.
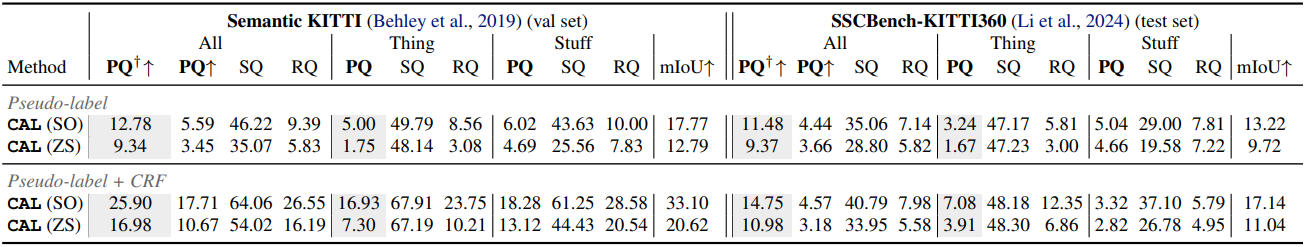
다음은 CRF에 대한 ablation 결과이다.
다음은 마스크 pseudo-label과 binary occupancy의 커버리지에 대한 분석 결과이다.
3. CAL model analysis
다음은 CAL 모델에 대한 ablation 결과이다.
다음은 CLIP prototype 개수에 따른 성능 비교 결과이다.