[논문리뷰] MakeAnything: Harnessing Diffusion Transformers for Multi-Domain Procedural Sequence Generation
CVPR 2026. [Paper] [Github]
Yiren Song, Cheng Liu, Mike Zheng Shou
Show Lab, National University of Singapore
3 Feb 2025
Introduction
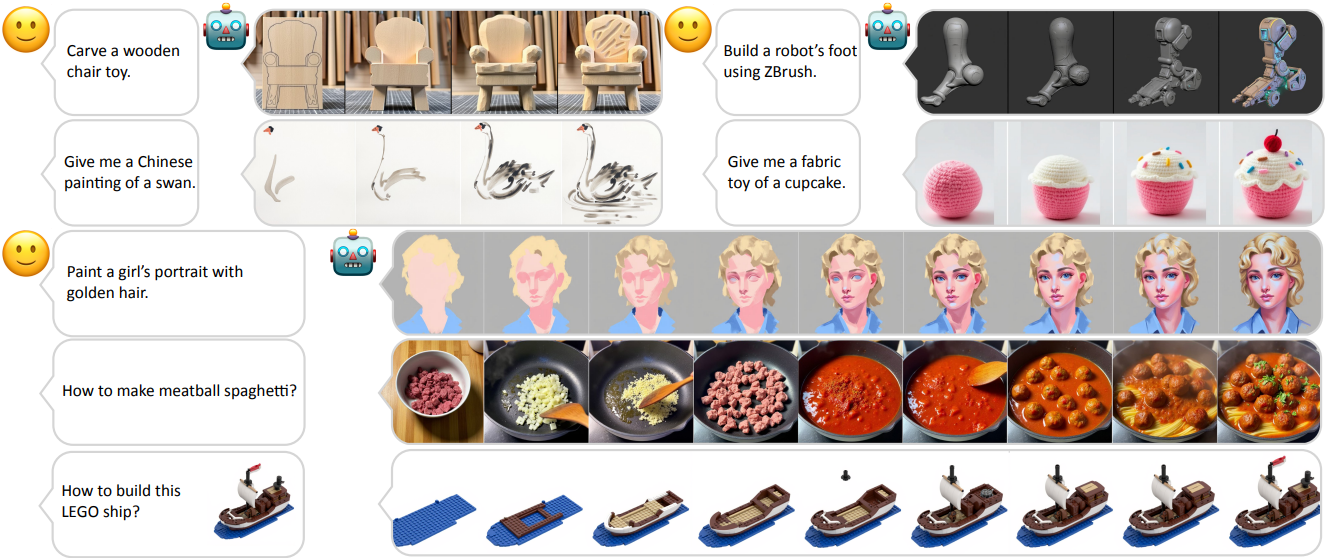
저자들은 인간의 창의적 지능을 구현하기 위해서는 여러 task에 걸친 고품질의 절차 데이터와 고도화된 방법론 설계가 모두 필요하다고 판단하였다. 그리고 이를 위해 회화, 공예, SVG 디자인, 레고 조립, 요리 등 21개 분야를 아우르는 포괄적인 다중 도메인 데이터셋을 구축했다. 이 데이터셋은 단계별 창작 작업을 위한 절차적 주석이 포함된 24,000개 이상의 시퀀스로 구성되어 있다. 방법론적으로는 LoRA fine-tuning을 통해 DiT의 in-context 능력을 활용하여 고품질의 시퀀스를 생성하는 새로운 프레임워크인 MakeAnything을 제안하였다.
심각한 데이터 부족과 데이터 분포의 불균형 문제를 해결하기 위해, 저자들은 이미지 생성에 asymmetric LoRA 전략을 도입하였다. 이 방식은 대규모 데이터로 사전 학습된 인코더와 특정 task에 맞춰 fine-tuning된 디코더를 결합함으로써, 일반화 성능과 도메인 특화 성능 간의 최적의 균형을 달성한다.
저자들은 실질적인 요구 사항을 해결하기 위해, 정적 이미지를 단계별 절차적 시퀀스로 분해하는 효율적이고 제어 가능한 생성 방법인 ReCraft 모델을 개발했다. 최소한의 아키텍처 수정으로 사전 학습된 Flux 모델을 기반으로 구축된 ReCraft는 대상 이미지에서 추출한 깨끗한 latent 토큰이 multi-modal attention을 통해 noise가 포함된 중간 프레임의 denoising을 가이드하는 이미지 컨디셔닝 메커니즘을 도입했다. 이러한 경량화된 적용 덕분에 제한된 데이터로도 효율적인 학습이 가능하며, ReCraft는 task당 수백 또는 수십 개의 시퀀스만으로도 강력한 성능을 달성하였다.
Inference 과정에서 모델은 concat된 latent 표현을 바탕으로 이전 프레임들을 재귀적으로 예측함으로써, 정적인 예술 작품으로부터 그 생성 과정을 효과적으로 재구성한다.
Method
1. Overall Architecture
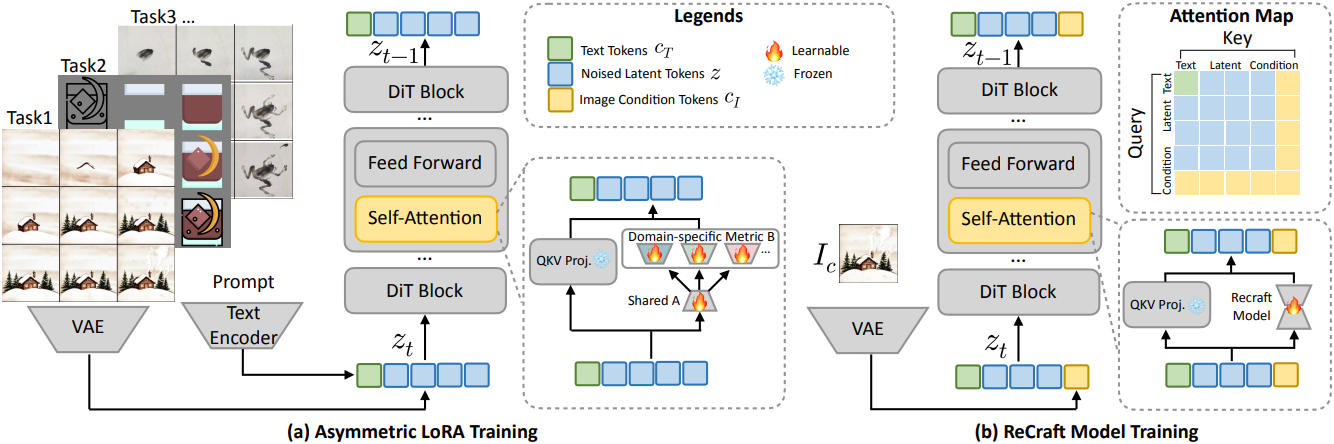
MakeAnything의 학습은 두 단계로 나뉜다.
- Asymmetric LoRA 기법을 사용하여 MakeAnything 데이터셋으로 모델을 학습시킴으로써, 텍스트 설명으로부터 창의적인 튜토리얼을 생성할 수 있도록 한다. 이 단계에서 얻은 LoRA를 Flux base model과 결합하여 ReCraft 모델 학습을 위한 base model을 구성한다.
- 이미지 조건 토큰을 noise가 포함된 latent 토큰과 concat하여, denoising process에 이미지 컨디셔닝 메커니즘을 도입한다. 이 setup을 LoRA를 이용해 추가로 fine-tuning함으로써 ReCraft 모델의 학습을 완료한다.
2. Asymmetric LoRA for Procedural Learning
뱀 모양의 시퀀스 레이아웃
MakeAnything의 핵심은 시퀀스의 여러 프레임을 그리드 형태로 배치하고, DiT의 in-context 능력과 attention 메커니즘을 활용하여 일관된 시퀀스를 생성하는 데 있다. DiT의 attention 메커니즘 내 토큰들은 공간적으로 인접한 토큰에 집중하는 경향이 있는데, 이는 diffusion model의 사전 학습 과정에서 포착된 인접 이미지 픽셀 간의 강한 상관관계에서 비롯된 것이다.
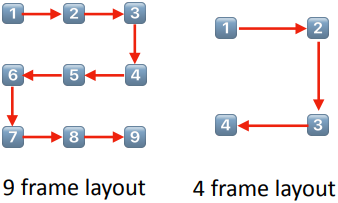
그리드 형태의 시퀀스에 대한 모델의 학습 효율을 높이기 위해, 저자들은 뱀 모양의 데이터셋 구성 방식을 제안하였다. 시간적으로 인접한 프레임들이 공간적으로도 인접하도록 9프레임 및 4프레임 시퀀스를 뱀 모양의 패턴으로 배치한다.
Asymmetric LoRA
또 다른 과제는 모든 데이터를 사용하여 하나의 LoRA를 학습시킬 경우 다양한 지식을 습득하기 어렵다는 점이다. 반면 특정 유형의 시퀀스 데이터로만 LoRA를 학습시킬 경우 각 카테고리별 데이터의 양이 제한적이어서 overfitting이 발생한다.
이에 저자들은 HydraLoRA에서 영감을 받아 이미지 생성 분야 최초로 asymmetric LoRA 설계를 도입하였다. 이 설계는 공유되는 중앙 행렬 $A$와 다수의 task별 행렬 $B$를 공동으로 학습시킴으로써 공유 지식과 특화된 기능을 결합하며, 이를 통해 멀티태스크 성능을 획기적으로 향상시킨다.
LoRA의 각 layer는 범용 행렬 $A \in \mathbb{R}^{r \times k}$와 도메인 특화 행렬 $B_i \in \mathbb{R}^{d \times r}$로 구성되며, asymmetric LoRA 아키텍처는 다음과 같다.
\[\begin{equation} W = W_0 + \Delta W = W_0 + \sum_{i=1}^N \omega_i \cdot B_i A \end{equation}\]이 구조는 일반화와 task별 적응성을 효과적으로 균형 있게 유지하여 다양한 task에서 모델의 성능을 향상시킨다.
Conditional Flow Matching Loss
Conditional flow matching loss function은 Stable Diffusion 3를 따르며, 다음과 같이 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{CFM} = \mathbb{E}_{t, p_t (z \vert \epsilon), p(\epsilon)} \left[ \| v_\Theta (z, t, c_T) - u_t (z \vert \epsilon) \|^2 \right] \end{equation}\]($c_T$는 텍스트 토큰, $t$는 timestep, \(v_\Theta(z, t, c_T)\)는 신경망 가중치로 parameterize된 velocity field, \(u_t (z \vert \epsilon)\)는 noise 분포와 실제 데이터 분포 간의 확률적 경로를 매핑하기 위해 모델이 생성하는 conditional vector field)
3. ReCraft Model
실제 활용 환경에서 사용자는 텍스트를 기반으로 제작 과정을 생성하는 것뿐만 아니라, 이미지 속의 기존 예술 작품이나 공예품의 제작 과정을 예측하는 기능도 원한다. 이를 위해 저자들은 사용자가 이미지를 업로드하면 해당 이미지와 높은 일관성을 지닌 일련의 제작 단계들을 생성해 주는 ReCraft 모델을 구현했다.
ReCraft 모델 학습의 주요 과제는 각 task에 사용할 수 있는 데이터셋의 수가 제한적이라는 점이다. 이러한 문제를 해결하기 위해, 사전 학습된 Flux 모델을 재사용하고 최소한의 수정만을 가해 이미지 조건부 생성 모델로 확장하는 방식으로 ReCraft 모델을 설계했다.
구체적으로, 학습 과정에서는 최종 프레임 \(I_\textrm{src}\)를 VAE에 입력하여 latent 이미지 조건 토큰 $c_I$를 추출하고, 이를 noise가 포함된 latent 토큰과 concat한다. 이때 multi-modal attention 메커니즘을 활용하여 다른 프레임의 denoising을 위한 조건부 정보를 제공한다. Noise를 추가하고 제거하는 과정은 다른 프레임에 대해서만 수행되며, 이미지 조건 토큰은 noise가 없는 상태로 유지된다.
\[\begin{equation} \textrm{MMA}([z; c_I; c_T]) = \textrm{softmax} \left( \frac{QK^\top}{\sqrt{d}} \right) V \end{equation}\]이 공식은 양방향 attention을 가능하게 한다. 이미지 조건을 사용하는 conditional flow matching loss function은 다음과 같이 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{CFM} = \mathbb{E}_{t, p_t (z \vert \epsilon), p(\epsilon)} \left[ \| v_\Theta (z, t, c_I, c_T) - u_t (z \vert \epsilon) \|^2 \right] \end{equation}\](\(v_\Theta(z, t, c_I, c_T)\)는 신경망 가중치로 parameterize된 velocity field)
Inference 시에 ReCraft 모델은 마지막 프레임을 바탕으로 이전 8개 프레임을 예측함으로써, 레퍼런스 이미지 속 물체가 형성되는 과정을 단계별로 보여준다.
4. MakeAnything Dataset
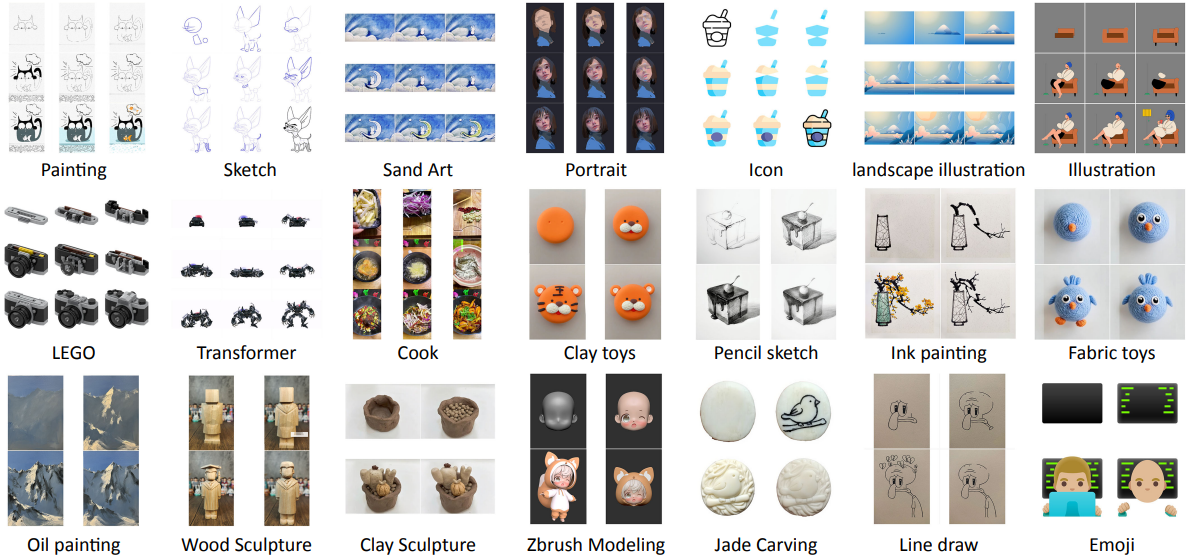
저자들은 전문 데이터 수집 및 annotation 팀을 구성하여 21가지 task에 대한 튜토리얼을 포함하는 MakeAnything 데이터셋을 구축했다. 데이터셋의 규모는 task당 50개에서 10,000개로 다양하며, 전체 데이터 수는 24,000개가 넘는다. 처음 10개 task의 데이터는 9개 프레임으로, 나머지 task는 4개 프레임으로 구성되어 있으며, 학습을 위해 각각 3$\times$3 및 2$\times$2 그리드 형태로 배치되었다. 또한 GPT-4o를 활용하여 모든 데이터셋에 레이블을 만들고 각 프레임에 대한 설명을 작성했다.
Experiments
- 구현 디테일
- Base model: Flux 1.0 dev (1024$\times$1024)
- LoRA rank: 64
- optimizer: CAME
- learning rate: $10^{-4}$
- batch size: 2
- Asymmetric LoRA는 4만 step, ReCraft 모델은 1.5만 step 학습
1. Experimental Results
다음은 MakeAnything의 생성 결과들이다.
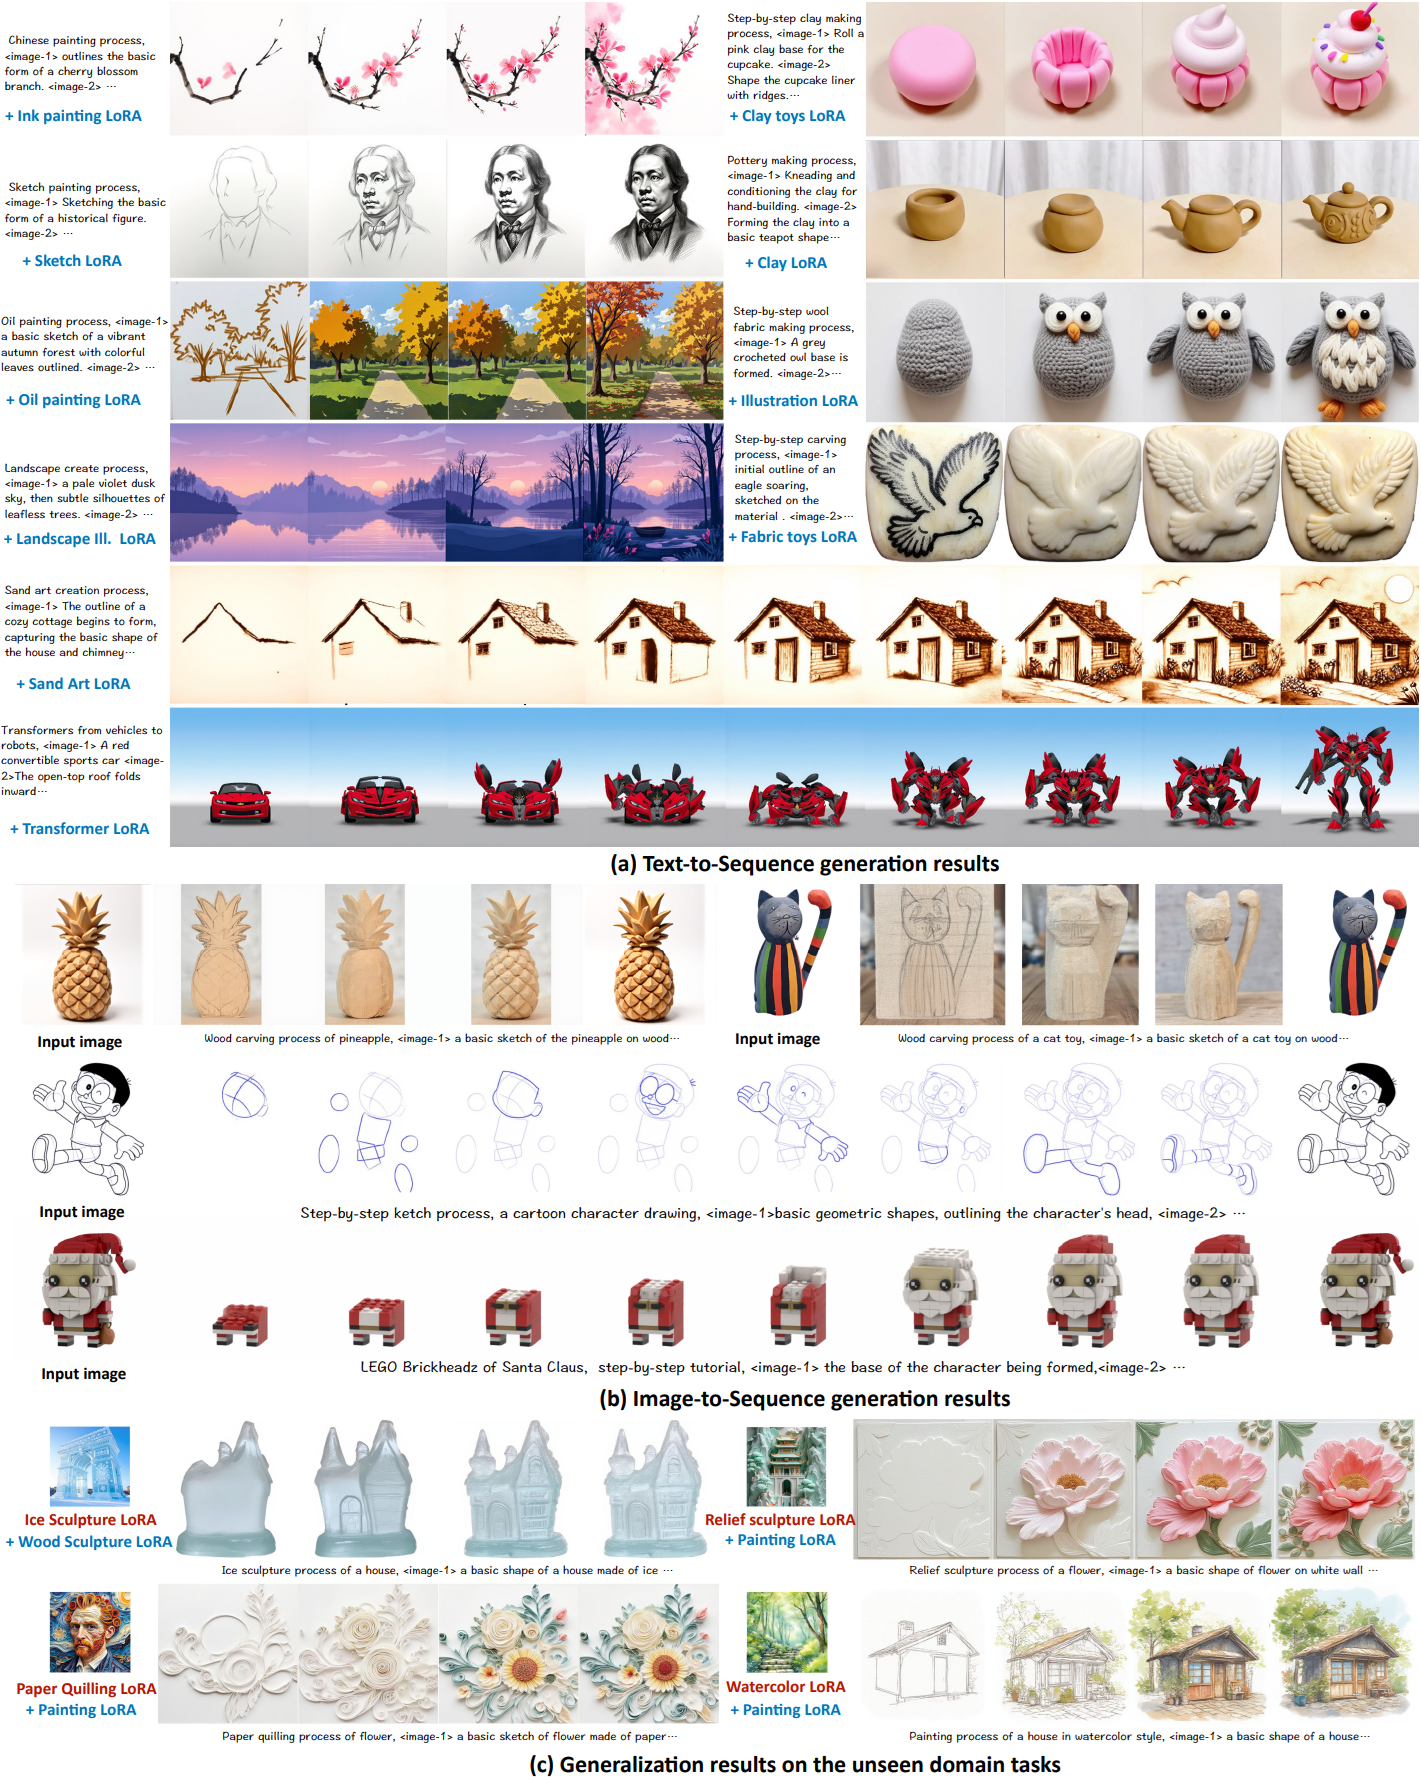
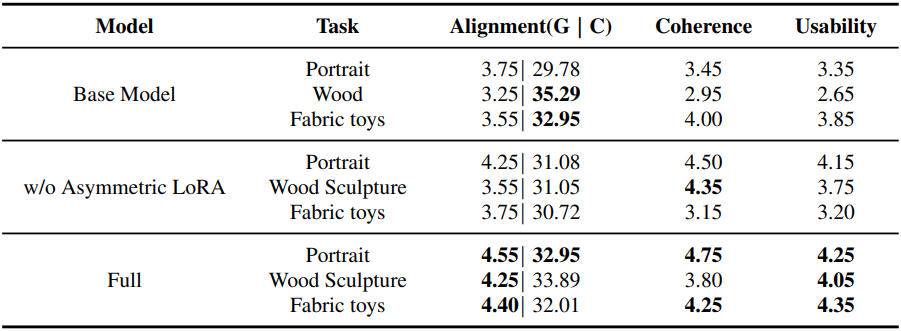
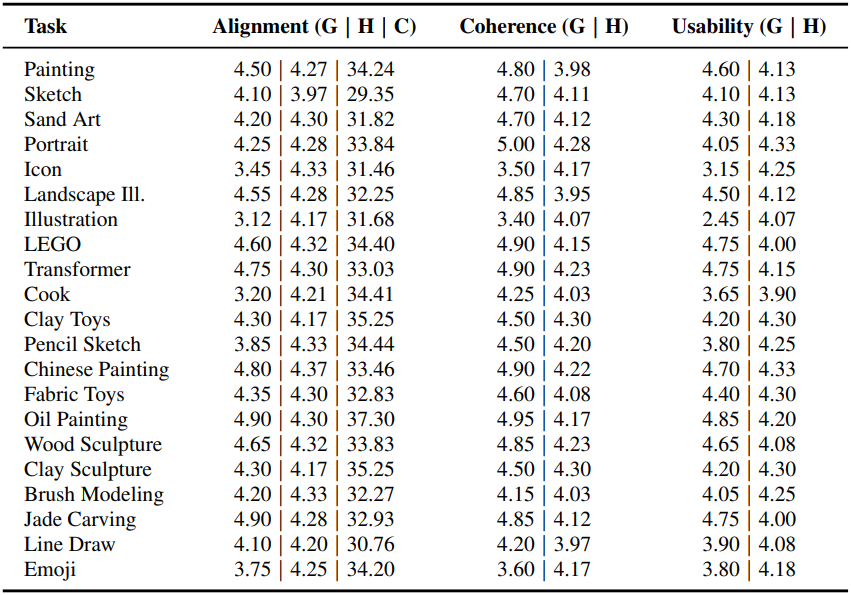
다음은 정량적 평가 결과이다. (G = GPT score, H = Human evaluation, C = CLIP score)
2. Comparison and Evaluation
다음은 다른 baseline들과의 비교 결과이다.
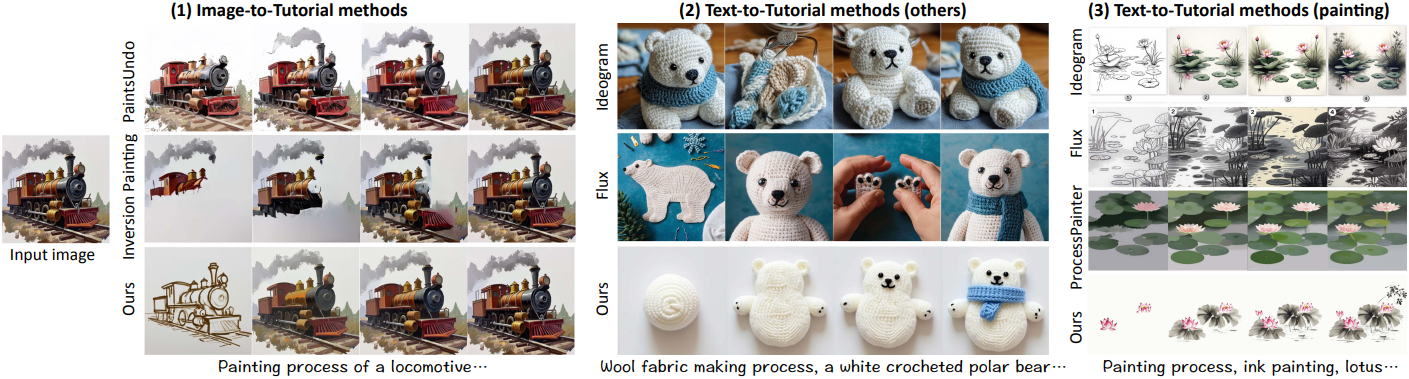
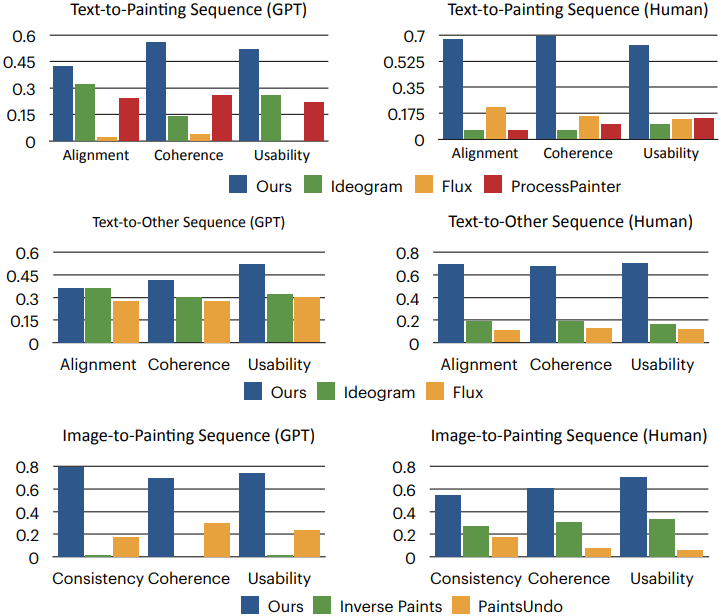
3. Ablation Study
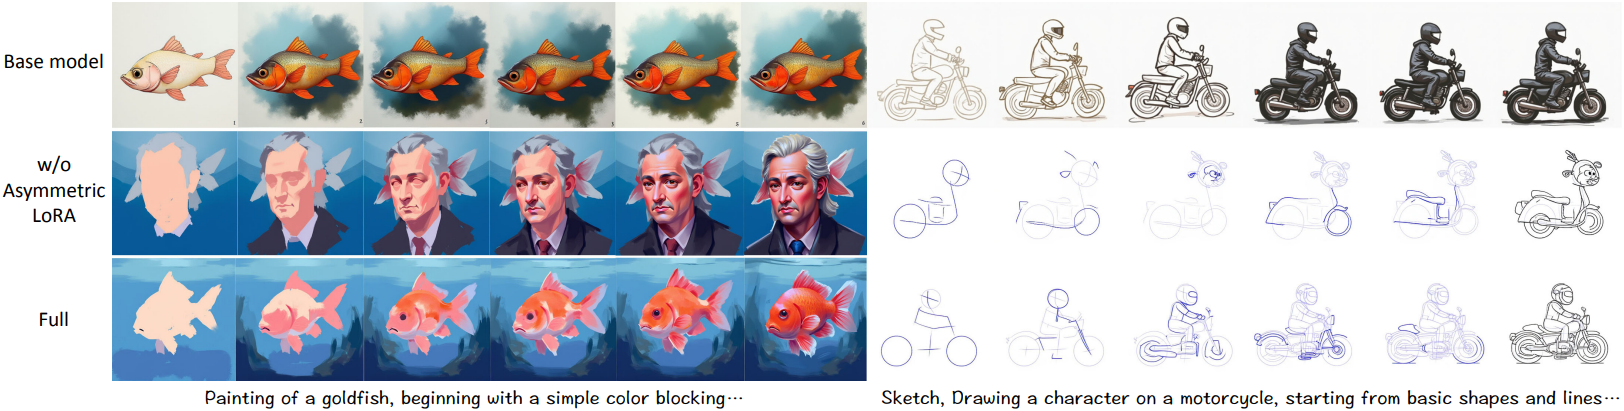
다음은 ablation study 결과이다.