[논문리뷰] DeCo: Frequency-Decoupled Pixel Diffusion for End-to-End Image Generation
CVPR 2026 (Highlight). [Paper] [Page] [Github]
Zehong Ma, Longhui Wei, Shuai Wang, Shiliang Zhang, Qi Tian
Peking University | Nanjing University | Huawei Inc
24 Nov 2025
Introduction
Pixel diffusion은 픽셀을 end-to-end 방식으로 직접 모델링함으로써 VAE에 의존하는 기존 diffusion model의 한계를 극복하였다. 이를 통해 보다 최적화된 분포 학습이 가능해지며, 불완전한 VAE 압축으로 인한 아티팩트 문제도 제거되었다. 그러나 방대한 pixel space 내에서 복잡한 고주파 신호와 저주파 semantics를 동시에 모델링하는 것은 여전히 어려운 과제이다.
기존의 많은 연구들에서는 고해상도 입력에서 고주파 신호를 재구성하고 저해상도 입력에서 저주파 semantics를 모델링하는 것이 더 효과적이라는 것을 보여주었다. 또한 DiT는 저주파 semantics를 잘 포착하는 경향이 있지만 고주파 신호에는 어려움을 겪는 것으로 나타났다.
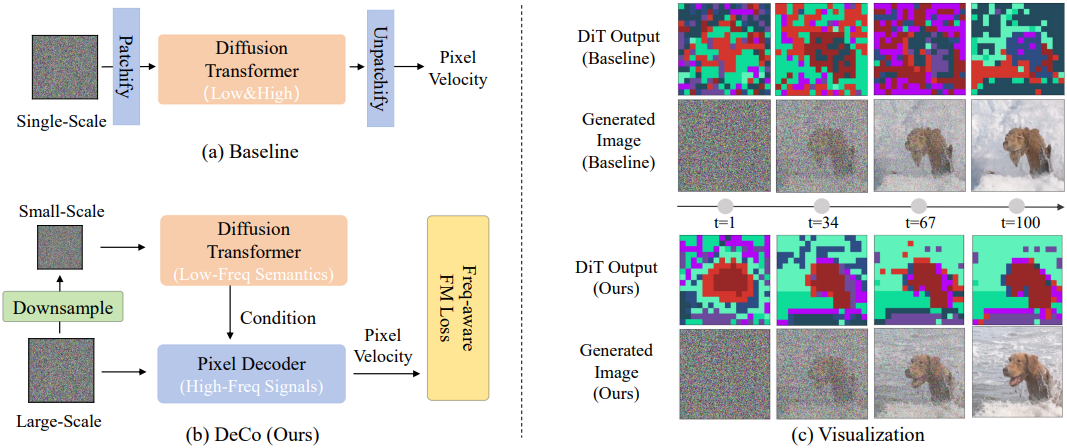
따라서 본 논문은 고주파 성분과 저주파 성분의 생성을 분리할 것을 제안하였다. DeCo는 DiT를 활용하여 다운샘플링된 입력을 사용하여 저주파 semantics 모델링을 전문적으로 수행한다. 이 semantics 신호는 가벼운 픽셀 디코더와 통합되어 고주파 신호를 재구성한다. 즉, 픽셀 디코더는 DiT의 저주파 semantics를 조건으로 사용하여 고해상도 입력으로 pixel velocity를 예측한다.
저자들은 시각적으로 두드러지는 주파수를 더욱 강조하고 중요하지 않은 고주파 성분을 억제하기 위해 JPEG에서 영감을 받은 frequency-aware flow-matching (FM) loss를 도입하였다. 모든 주파수를 동등하게 처리하는 표준 FM loss와 달리, 본 논문의 loss는 discrete cosine transform (DCT)을 사용하여 pixel velocity를 주파수 도메인으로 변환하고 각 주파수 대역에 적응형 가중치를 할당한다. 이 적응형 가중치는 다양한 주파수의 시각적 중요도에 대한 prior를 담고 있는 JPEG quantization table에서 파생된다. 이 loss는 최적화 과정을 단순화하고 시각적 충실도를 향상시킨다.
Method
1. Overview
Conditional Flow Matching
Conditional flow matching은 단순한 Gaussian 분포의 샘플을 레이블 $y$와 시간 $t$로 컨디셔닝된 데이터 분포로 이동시키는 velocity field \(v_\theta (x, t, y)\)를 학습하는 continuous-time 생성 모델링 프레임워크를 제공한다. 깨끗한 이미지 $x_0$와 noise $x_1$ 사이의 linear interpolation을 통해 생성된 forward 궤적 $x_t$가 주어졌을 때, conditional flow matching의 목표는 모델이 예측한 velocity \(v_\theta (x_t, t, y)\)를 GT velocity $v_t$와 일치시키는 것이다.
\[\begin{equation} \mathcal{L}_\textrm{FM} = \mathbb{E}_{x_t, t, y} \left[ \| v_\theta (x_t, t, y) - v_t \|^2 \right], \quad \textrm{where} \; x_t = (1 - t) x_0 + t x_1 \end{equation}\]GT velocity $v_t$는 $x_t$의 시간 미분인 $x_t^\prime$으로부터 도출할 수 있다.
\[\begin{equation} v_t = x_t^\prime = x_1 - x_0 \end{equation}\]Pixel diffusion baseline에서는 이미지를 다운샘플링하기 위해 VAE를 사용하는 대신, 일반적으로 patch embedding layer를 통해 궤적 $x_t$를 먼저 토큰으로 patchify한다. Patchify된 궤적 \(\bar{x}_t\)는 DiT에 입력되며, 이후 unpatchify layer를 통해 pixel velocity를 예측한다. 이때 DiT는 고주파 신호와 저주파 semantics를 동시에 모델링해야 한다. 특히 고주파 신호는 모델링하기 까다로우며, 이는 DiT가 저주파 semantics를 학습하는 데 방해가 될 수 있다.
DeCo
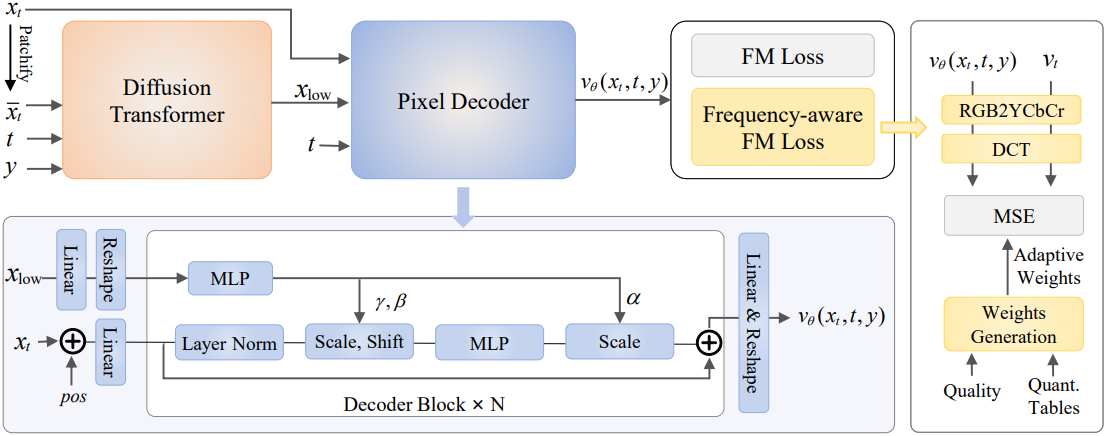
고주파 생성과 저주파 semantics 모델링을 분리하기 위해, 본 논문에서는 주파수 분리 프레임워크인 DeCo를 제안하였다. DiT는 다운샘플링된 저해상도 입력 \(\bar{x}_t\)로부터 저주파 semantics \(x_\textrm{low}\)를 생성하는 데 다음과 같이 활용된다.
\[\begin{equation} x_\textrm{low} = \textrm{DiT} (\bar{x}_t, t, y) \end{equation}\]($t$는 시간, $y$는 레이블 또는 텍스트 프롬프트)
가벼운 픽셀 디코더는 DiT로부터 얻은 저주파 semantics \(x_\textrm{low}\)를 조건으로 입력받아, 전체 해상도의 입력 $x_t$를 활용해 추가적인 고주파 디테일을 생성하며, 다음과 같이 최종 pixel velocity를 예측한다.
\[\begin{equation} v_\theta (x_t, t, y) = \textrm{Dec} (x_t, t, x_\textrm{low}) \end{equation}\]이 새로운 패러다임은 픽셀 디코더를 활용하여 고주파 디테일을 생성함으로써 DiT가 semantics 모델링에 특화될 수 있도록 한다. 이러한 분리를 통해 서로 다른 주파수 모델링이 서로 다른 모듈로 분리되어 학습 속도가 빨라지고 시각적 충실도가 향상된다.
저자들은 시각적으로 두드러지는 주파수를 더욱 강조하고 중요하지 않은 고주파 성분을 무시하기 위해, frequency-aware flow-matching (FM) loss \(\mathcal{L}_\textrm{FreqFM}\)을 도입하였다. 이 loss는 JPEG perceptual prior에서 파생된 적응형 가중치를 사용하여 서로 다른 주파수 성분에 가중치를 다시 부여한다. 표준 flow-matching loss, REPA 정렬 loss와 결합하면 최종 loss는 다음과 같이 나타낼 수 있다.
\[\begin{equation} \mathcal{L} = \mathcal{L}_\textrm{FM} + \mathcal{L}_\textrm{FreqFM} + \mathcal{L}_\textrm{REPA} \end{equation}\]2. Pixel Decoder
픽셀 디코더는 $N$개의 linear decoder block과 다수의 linear projection layer로 구성된, attention을 사용하지 않는 가벼운 네트워크이다. 모든 연산은 로컬하고 선형적이므로, self-attention에 따른 연산 부담 없이 효율적인 고주파 모델링이 가능하다.
Dense Query 구성
픽셀 디코더는 다운샘플링 없이 원본 해상도의 noise가 포함된 이미지 $x_t$를 직접 입력으로 받는다. 모든 픽셀은 해당 위치 임베딩 $\textrm{pos}$와 concat된 후 \(W_\textrm{in}\)에 의해 linear projection되어 dense query 벡터 $h_0$를 형성한다.
\[\begin{equation} h_0 = W_\textrm{in} (\textrm{Concat} (x_t, \textrm{pos})), \quad \textrm{where} \; h_0 \in \mathbb{R}^{B \times H \times W \times d} \end{equation}\]Decoder Block
각 decoder block에서 DiT 출력 \(x_\textrm{low}\)는 $x_t$의 공간 해상도에 맞춰 linearly upsampling 및 reshape되어 \(x_\textrm{low}^\textrm{up}\)을 생성한다. 이어서 MLP가 AdaLN을 위한 변조 파라미터 $\alpha$, $\beta$, $\gamma$를 생성한다.
\[\begin{equation} \alpha, \beta, \gamma = \textrm{MLP} (\sigma (x_\textrm{low}^\textrm{up} + t)) \end{equation}\]($\sigma$는 SiLU activation function)
각 block 내의 dense query를 변조하기 위해 다음과 같이 AdaLN-Zero를 사용한다.
\[\begin{equation} h_n = h_{n-1} + \alpha \cdot (\textrm{MLP} ((1 + \gamma) \cdot h_{n-1} + \beta)) \end{equation}\]여기서 MLP는 SiLU를 적용한 두 개의 linear layer를 포함한다.
Velocity 예측
마지막으로, linear projection과 재배열 연산을 거쳐 디코더 출력이 pixel space로 매핑됨으로써 예측 velocity \(v_\theta (x_t, t, y)\)가 산출된다. 이 velocity에는 픽셀 디코더가 생성한 고주파 디테일과 DiT로부터 얻은 semantic 단서가 모두 포함된다.
3. Frequency-aware FM Loss
픽셀 디코더가 시각적으로 중요한 주파수에 집중하고 중요하지 않은 noise를 억제하도록 더욱 유도하기 위해, frequency-aware flow-matching (FM) loss를 사용한다.
공간-주파수 변환
먼저 예측된 pixel velocity와 GT pixel velocity를 모두 공간 도메인에서 주파수 도메인으로 변환한다. 구체적으로, JPEG 방식에 따라 색 공간을 YCbCr로 변환한 뒤 block-wise 8$\times$8 discrete cosine transform (DCT)을 적용한다. 이 변환을 $\mathcal{T}$라고 하면 다음과 같다.
\[\begin{equation} \mathbb{V}_\theta = \mathcal{T} (v_\theta (x_t, t, y)), \quad \mathbb{V}_t = \mathcal{T}(v_t) \end{equation}\]Perceptual Weighting
JPEG quantization table을 visual prior로 활용하여 적응형 가중치를 생성한다. Quantization 간격이 작을수록 해당 주파수 성분은 시각적으로 더 중요하다. 따라서 품질 $q$에 해당하는 scaled quantization table \(Q_\textrm{cur}\)의 역수를 정규화한 값을 적응형 가중치 $w$로 사용한다.
\[\begin{equation} w = \frac{1}{Q_\textrm{cur}} / \mathbb{E} (\frac{1}{Q_\textrm{cur}}) \end{equation}\]품질 $q$가 50에서 100 사이인 경우, 해당 품질의 \(Q_\textrm{cur}\)은 JPEG의 사전 정의된 규칙에 따라 다음과 같이 구할 수 있다.
\[\begin{equation} Q_\textrm{cur} = \max \left( 1, \left\lfloor \frac{Q_\textrm{base} \cdot (100 - q) + 25}{50} \right\rfloor \right) \end{equation}\](\(Q_\textrm{base}\)는 JPEG 규격에 정의된 표준 base quantization table)
적응형 가중치 $w$를 사용할 때, frequency-aware FM loss는 다음과 같이 정의된다.
\[\begin{equation} \mathcal{L}_\textrm{FreqFM} = \mathbb{E}_{x_t, t, y} \left[ w \| \mathbb{V}_\theta - \mathbb{V}_t \|^2 \right] \end{equation}\]4. Empirical Analysis
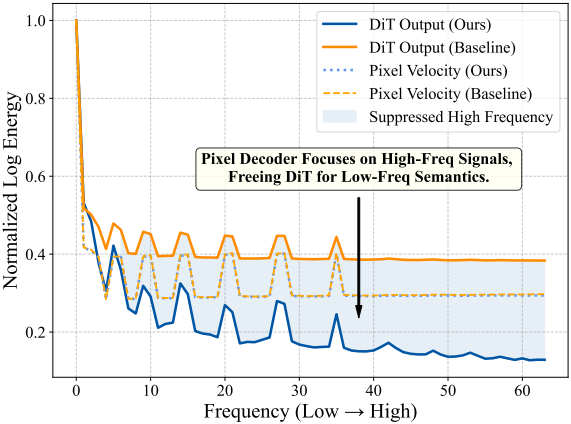
DeCo가 주파수를 효과적으로 분리하는지 확인하기 위해, 저자들은 DiT 출력과 pixel velocity의 DCT 에너지 스펙트럼을 분석하였다. Baseline과 비교했을 때, 픽셀 디코더는 pixel velocity의 모든 주파수 성분을 성공적으로 유지한다. 반면, DeCo의 DiT 출력은 baseline에 비해 고주파 에너지가 현저히 낮게 나타나는데, 이는 고주파 성분이 DiT에서 픽셀 디코더로 이동했음을 시사한다. 이러한 결과는 DeCo가 효과적인 주파수 분리를 수행함을 입증한다.
Experiments
1. Comparison with Baselines
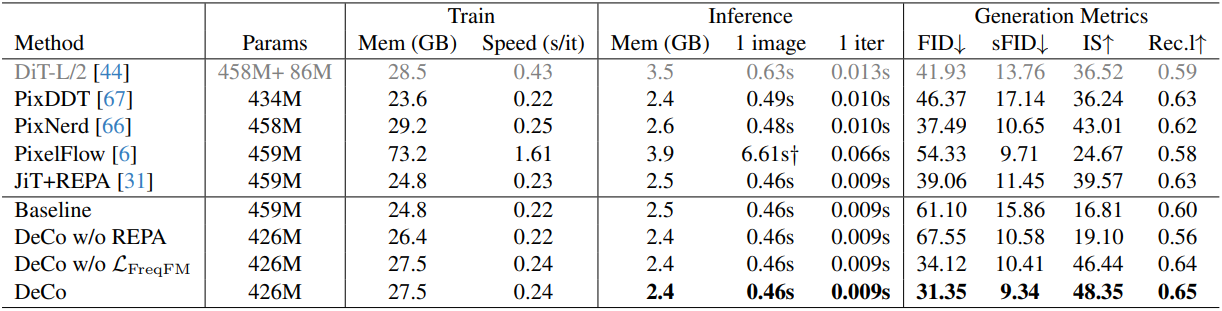
다음은 baseline 및 다른 최신 방법들과 비교한 결과이다. (DiT-L/2는 VAE 필요)
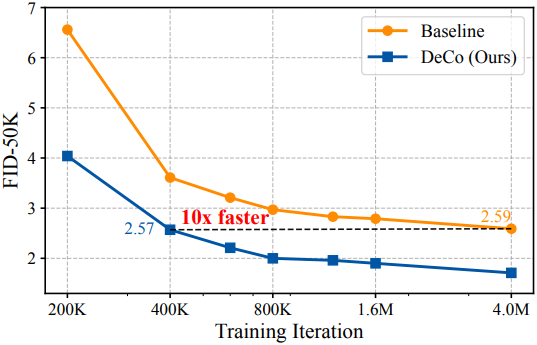
다음은 baseline과 training curve를 비교한 결과이다.
2. Class-to-Image Generation
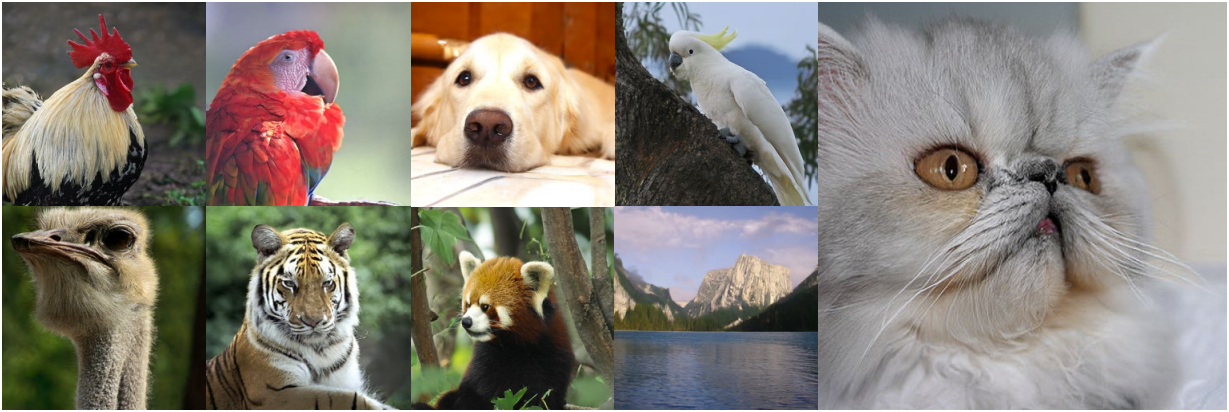
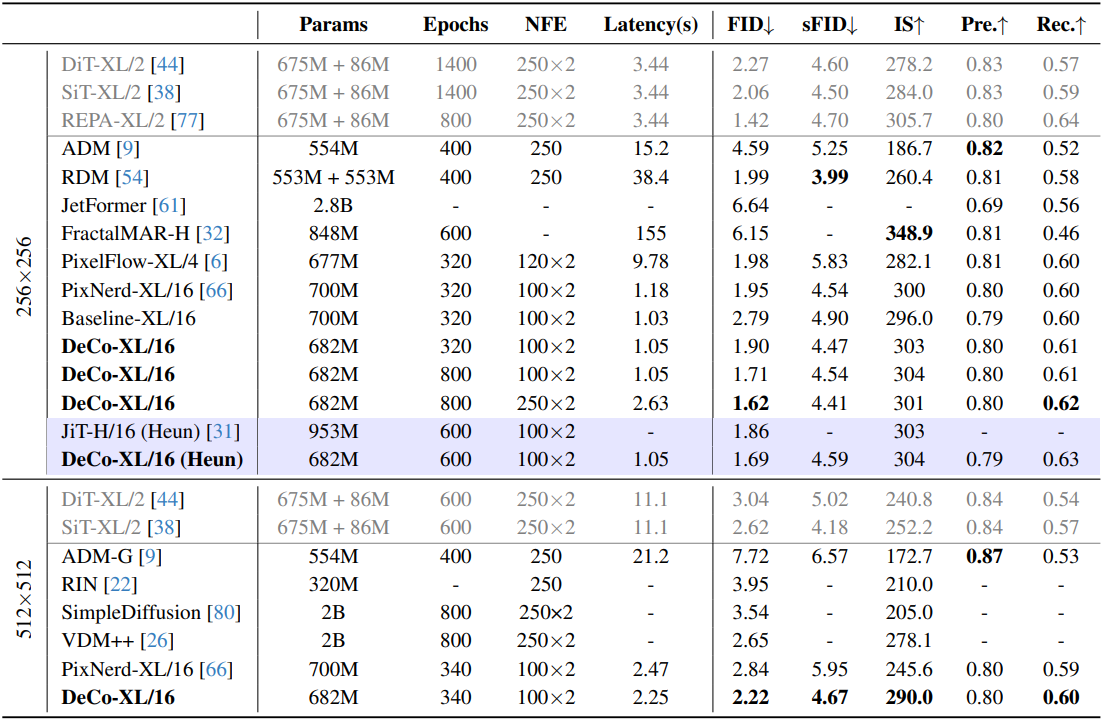
다음은 ImageNet에서의 class-to-image 생성에 대한 비교 결과이다. (표에서 파란 배경색은 Heun sampler로 50 step 샘플링)
3. Text-to-Image Generation
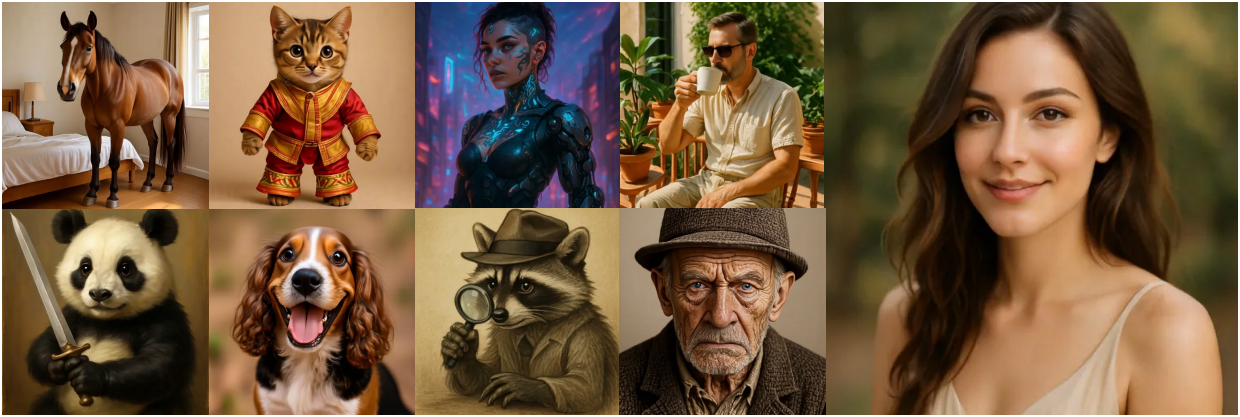
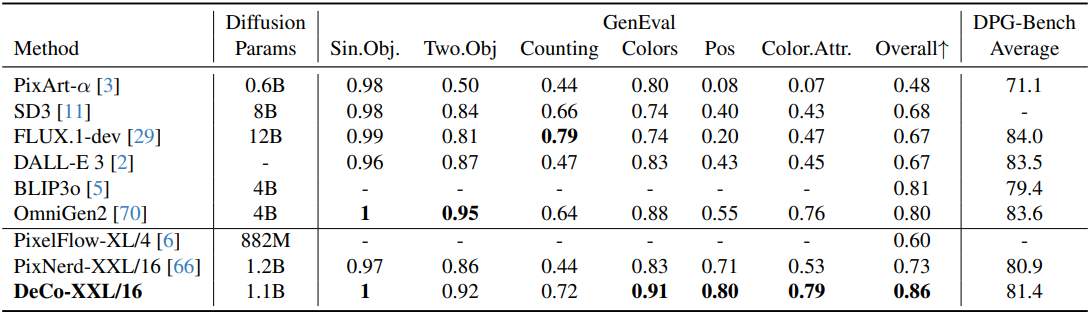
다음은 text-to-image 생성에 대한 비교 결과이다.
4. More Ablations
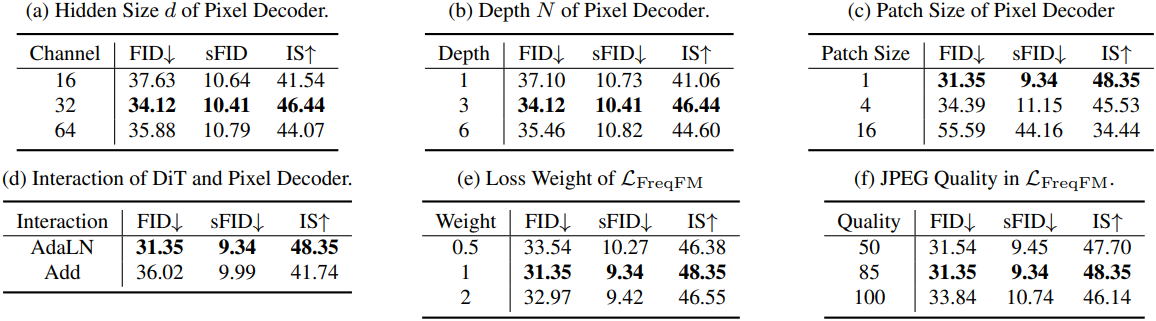
다음은 아키텍처 디자인과 hyperparameter에 대한 ablation 결과이다.