[논문리뷰] Infinity-RoPE: Action-Controllable Infinite Video Generation Emerges From Autoregressive Self-Rollout
CVPR 2026. [Paper] [Page] [Github]
Hidir Yesiltepe, Tuna Han Salih Meral, Adil Kaan Akan, Kaan Oktay, Pinar Yanardag
Virginia Tech | fal
25 Nov 2025
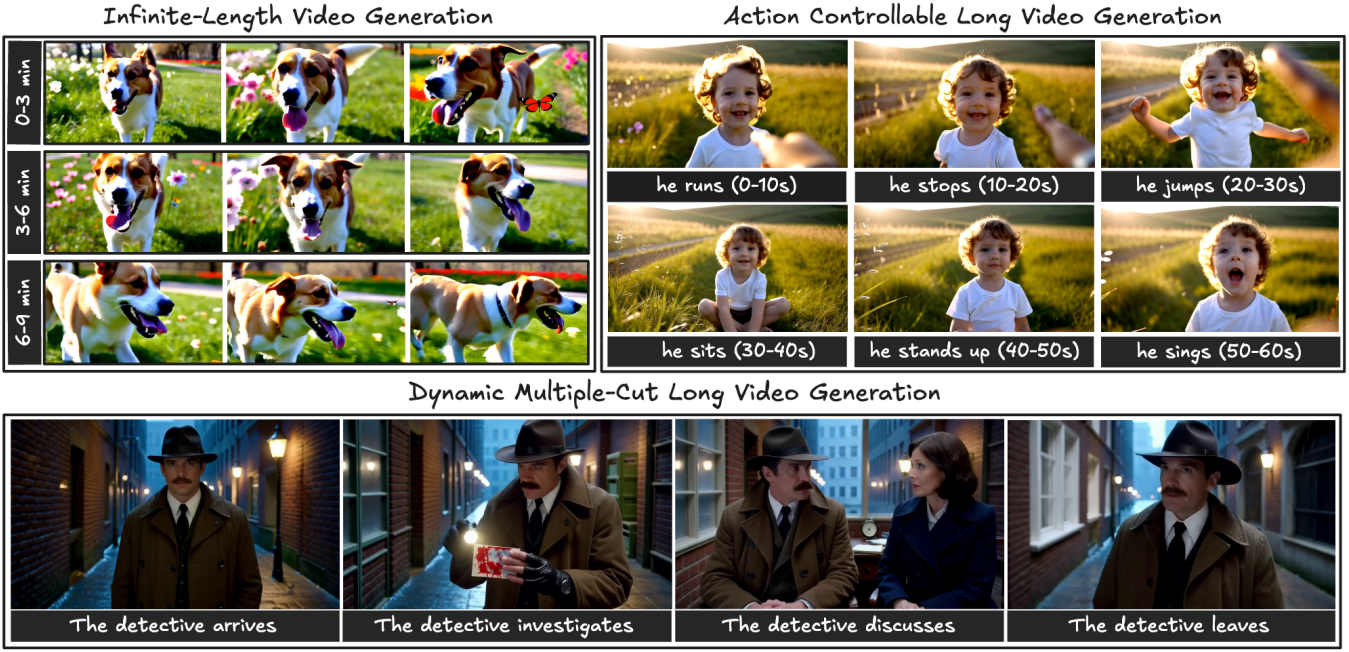
Introduction
본 논문에서는 근본적으로 다른 관점에서 긴 동영상 생성 문제를 재검토하였다. 기존의 autoregressive diffusion 프레임워크는 더 긴 self-rollout이나 긴 동영상 데이터에 대한 재학습을 통해 시간적 확장성을 확보했지만, 3D-RoPE의 절대 프레임 인덱싱 방식과 비압축 KV 캐시의 과도한 메모리 사용량이라는 한계에 직면했다.
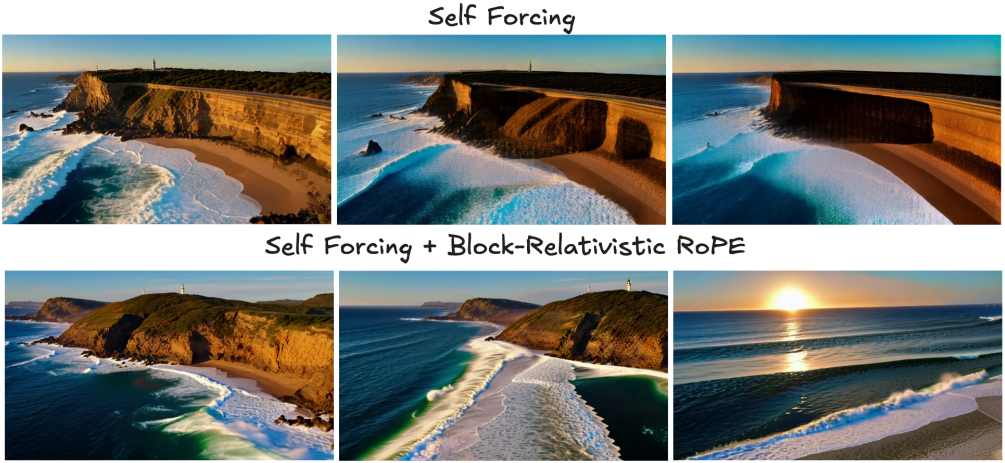
본 논문에서는 긴 동영상에 대한 supervision 없이 상대론적 적응과 학습이 필요 없는 아키텍처 reparameterization을 통해 이러한 병목 현상을 극복할 수 있는지 탐구하였다. 위 그림에서 보여주는 바와 같이, Self-Forcing 패러다임에서 5초 클립만으로 학습된 autoregressive DiT는 이미 무한 horizon 생성 능력을 갖추고 있다.
이러한 문제들을 해결하기 위해, 본 논문에서는 학습이 필요 없는 상대론적 위치 인코딩 방식인 Block-Relativistic RoPE를 제안하였으며, 시간 좌표를 이동하는 레퍼런스 프레임으로 재정의하였다. 이를 통해 새로 생성된 각 block은 base model의 최대 프레임 범위에 대해 회전할 수 있으며, 이전 block들은 상대적인 geometry를 유지하기 위해 역방향으로 회전한다. 이러한 방식은 고정된 시간적 위치를 제거하고 RoPE의 1024 프레임 한계를 훨씬 뛰어넘는 연속적인 생성을 가능하게 한다.
또한, 본 논문에서는 KV Flush를 제안하였다. KV Flush는 이러한 상대론적 기하학적 구조를 활용하여 KV 캐시를 갱신하고 과거 시간 인덱스부터 생성을 재개함으로써, 일정한 메모리 용량으로 즉각적인 반응형 제어를 제공한다. 마지막으로, RoPE Cut은 시간 좌표에 제어된 불연속성을 부여하여 단일 rollout 내에서 영화적인 멀티컷 전환을 구현한다. 이러한 모든 구성 요소를 통해 짧은 동영상을 만드는 Self-Forcing 모델을 무한 프레임 범위의 생성 모델로 변환할 수 있다.
Method
1. Block-Relativistic RoPE
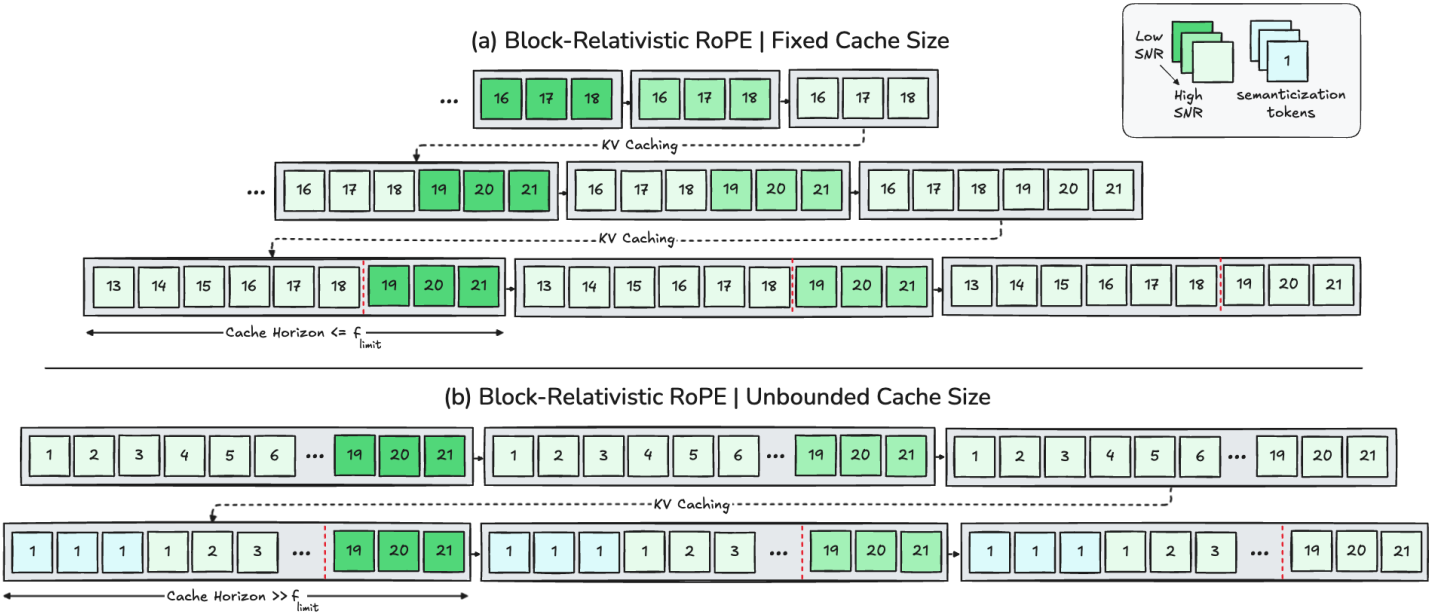
고정 캐시 크기
먼저 KV 캐시 horizon이 base model의 고유 생성 horizon인 \(f_\textrm{limit}\)보다 작거나 같은 경우를 고려해보자. Base model은 \(f_\textrm{limit} = 21\)개의 latent 프레임에 해당하는 5초 길이의 클립으로 학습되었다. Autoregressive self-rollout 과정에서 동영상 생성은 3개의 latent 프레임으로 구성된 block 단위로 진행된다.
\[\begin{equation} \textbf{B}_f = \{f - 2, f - 1, f\} \end{equation}\]캐시가 가득 차면 가장 오래된 세 개의 latent 프레임이 제거되고 새로 생성된 block으로 대체된다. 본 설계에서는 KV 캐시에 항상 고정된 크기의 latent 프레임만 상주하지만, 현재 block에 할당된 RoPE 시간 인덱스는 캐시 크기에 제한되지 않는다. 대신, base model의 전체 생성 용량인 \(f_\textrm{limit}\)개의 latent 프레임 범위 내에서 결정된다.
결과적으로 캐시 내에서 토큰이 순환되더라도 시간 임베딩은 캐시 길이를 넘어 계속 진행될 수 있으며, 이를 통해 teacher 모델의 생성 horizon 내에 존재하는 글로벌한 시간적 연속성을 온전히 활용할 수 있다. 기존의 3D-RoPE 방식에서는 시간 인덱스가 글로벌하게 정의된다. 시간 인덱스가 \(i \gg f_\textrm{limit}\)이고 현재 생성 block이 \(\textbf{B}_i = \{i - 2, i - 1, i\}\)인 경우, 다음과 같이 정의된다.
\[\begin{equation} \textrm{RoPE}_\textrm{3D} \left[ \textbf{x}_{(\textbf{B}_i, h, w)} \right] = \left[ \textrm{RoPE} (\textbf{x}_{\textbf{B}_i}) \, \| \, \textrm{RoPE}_\textrm{2D} \left[ \textbf{x}_{(h, w)} \right] \right] \end{equation}\]반면, Block-Relativistic RoPE는 공간 좌표를 고정한 채 이동하는 로컬 기준계 내에서 시간 좌표를 정의한다.
\[\begin{equation} \tilde{\textbf{B}}_i = \begin{cases} \textbf{B}_i = \{i - 2, i - 1, i\}, & \textrm{if} \; i \le f_0 \\ \textbf{B}_{f_0} = \{f_0 - 2, f_0 - 1, f_0\}, & \textrm{otherwise} \end{cases} \\ \textrm{RoPE}_\textrm{3D} \left[ \textbf{x}_{(\textbf{B}_i, h, w)} \mid f_0 \right] = \left[ \textrm{RoPE} (\textbf{x}_{\tilde{\textbf{B}}_i}) \, \| \, \textrm{RoPE}_\textrm{2D} \left[ \textbf{x}_{(h, w)} \right] \right] \end{equation}\](\(f_0 \le f_\textrm{limit}\)은 현재 cache window의 시작 인덱스)
생성이 진행됨에 따라, 이전에 캐싱된 latent 프레임들은 $f_0$를 기준으로 재설정되며, 이는 결과적으로 RoPE 공간 내에서 해당 프레임들의 시간적 위상을 뒤로 회전시키는 효과를 낳는다.
무제한 캐시 크기
KV 캐시가 teacher model의 horizon인 \(f_\textrm{limit}\)을 넘어서면, 시간 인코딩은 엄격한 시간 체계에서 추상적인 체계로 전환되어야 한다. KV 캐시가 \(f_\textrm{limit}\)을 초과하면 초기 latent 프레임은 Block-Relativistic RoPE 공식 내에서 semanticization 과정을 거친다. 가장 초기 프레임에 고유한 시간 인덱스를 유지하는 대신, 해당 프레임의 시간 좌표를 가장 작은 공유 인덱스로 통합하여 시간적으로 불변하지만 semantic하게 영향력 있는 메모리로 효과적으로 고정한다.
구체적으로, 현재 생성 block이 \(\textbf{B}_i\)이고 \(i > f_\textrm{limit}\)인 경우, 가장 초기에 캐싱된 block은 다음과 같이 재매핑된다.
\[\begin{equation} \textbf{B}_3 = \{1, 2, 3\} \; \rightarrow \; \textbf{B}_{\bar{1}} = \{1, 1, 1\} \end{equation}\]따라서, 발생 시점보다는 이전 프레임에서 발생한 내용을 보존함으로써, 에피소드적 디테일을 지식으로 추상화한다. 결과적으로, 시스템의 시간적 표현은 과거가 현재 생성 과정을 형성하는 맥락적 prior로만 존재하도록 진화한다.
Block-Relativistic RoPE에서 이러한 메커니즘은 시간 축을 무한히 확장할 수 있도록 한다. 또한 현재 활성 window \(\textbf{B}_i\) 내에서 정확한 상대적 인코딩을 유지하는 동시에, 이전의 모든 프레임을 시간적으로 중립적인 통합된 semantic 영역으로 통합한다.
2. Action Control via KV Flush
Autoregressive video diffusion에서 inference 중 프롬프트 간 전환, 즉 동작을 제어 가능한 동영상 생성은 즉각적인 semantic 반응성과 시간적 연속성 사이의 균형을 요구한다.
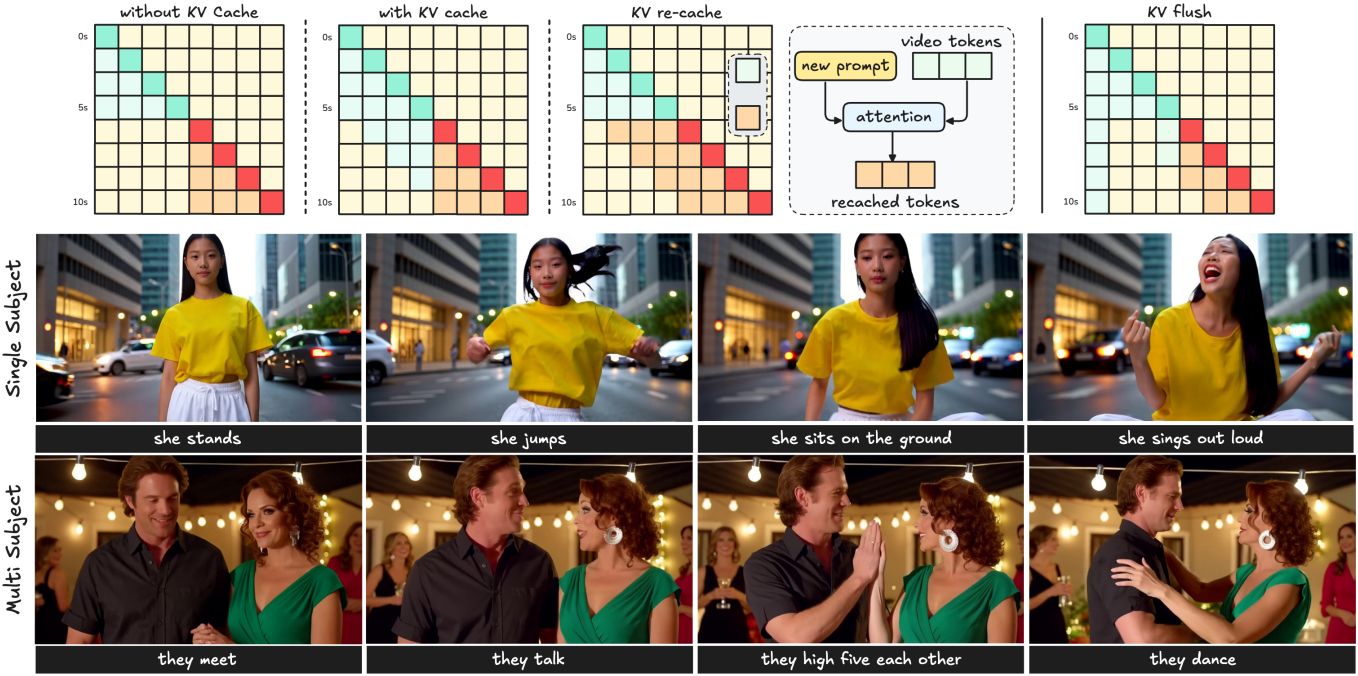
KV Flush 메커니즘은 일정한 메모리 사용량과 latency 없이 캐시를 갱신한다. 새로운 프롬프트가 도착하면 global sink latent 프레임과 마지막으로 생성된 latent 프레임, 두 개의 앵커를 제외한 모든 캐싱된 토큰이 flush된다. 이 두 앵커는 각각 attention 정규화를 안정화하고 로컬한 시간적 연속성을 유지한다. 다음 동작은 이러한 최소 앵커에 직접적으로 의존하여 결정되므로 장면이 부드럽게 움직이며 새로운 semantic을 즉시 적용할 수 있어 기존의 캐시 관리 방식보다 효율성과 제어성 측면에서 우수하다.
3. Multi-Cut Scenes via RoPE Cut
Block-Relativistic RoPE와 KV Flush는 연속적이고 제어 가능한 생성을 가능하게 하지만, 영화적 서사에는 장면 전환, 플래시백, 또는 장소 간 이동과 같은 급격한 시간적 불연속성이 요구되는 경우가 많다. 한 번의 생성 과정 내에서 이러한 불연속성을 구현하기 위해, 저자들은 RoPE 시간 좌표상에서 제어된 불연속적 도약을 수행하는 training-free 연산인 RoPE Cut을 도입하였다.
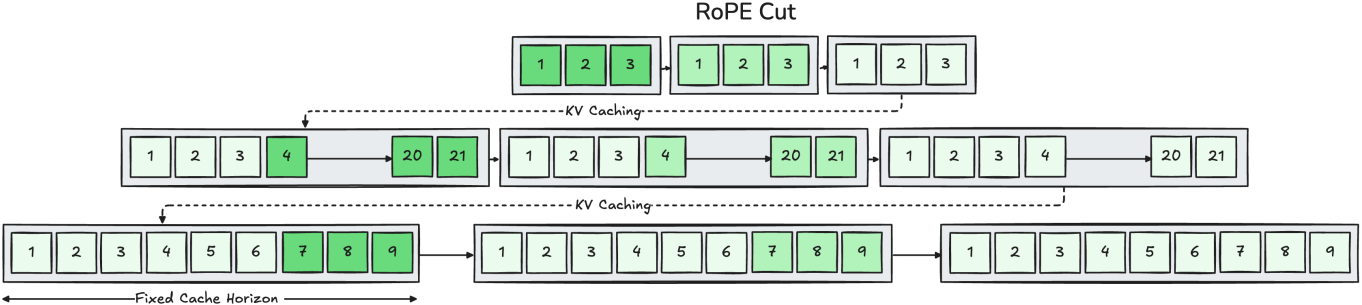
현재 생성 block \(\textbf{B}_f = \{f -2, f -1, f\}\)에 대하여, RoPE Cut은 시간 좌표 매핑을 다음과 같이 재정의한다.
($\Delta$는 현재 장면과 다음 장면 사이의 시간 간격을 나타내는 jump index)
시간 인덱스를 순차적으로 확장하는 대신, 현재 block을 $\Delta$ 프레임만큼 이동시켜 3D-RoPE의 시간 위상을 끊고 재설정한다.
\[\begin{equation} \textrm{RoPE}_\textrm{3D} \left[ \textbf{x}_{(\textbf{B}_f, h, w)} \right] \; \rightarrow \; \textrm{RoPE}_\textrm{3D} \left[ \textbf{x}_{(\textbf{B}_{f \rightarrow f+\Delta}, h, w)} \right] \end{equation}\]불연속적인 도약이 발생할 경우, 이후 프레임은 도약된 부분이 과거의 시간 인덱스로 재배치된 것처럼 생성된다. 이렇게 인덱싱을 다시하여 base model의 horizon \(f_\textrm{limit}\)을 넘지 않고 완전히 재사용할 수 있다. 상대론적 공식 덕분에 시간 축을 따라 고정된 절대적 위치가 존재하지 않으며, 좌표계 자체가 각 컷마다 이동하여 큰 시간적 도약 또는 semantic 도약 후에도 identity를 유지할 수 있다.
4. Mechanistic Interpretation of $\infty$-RoPE
저자들은 프레임 간 self-attention map을 분석하여 $\infty$-RoPE가 긴 시간적 의존성(dependency)을 어떻게 구조화하는지 해석하였다.
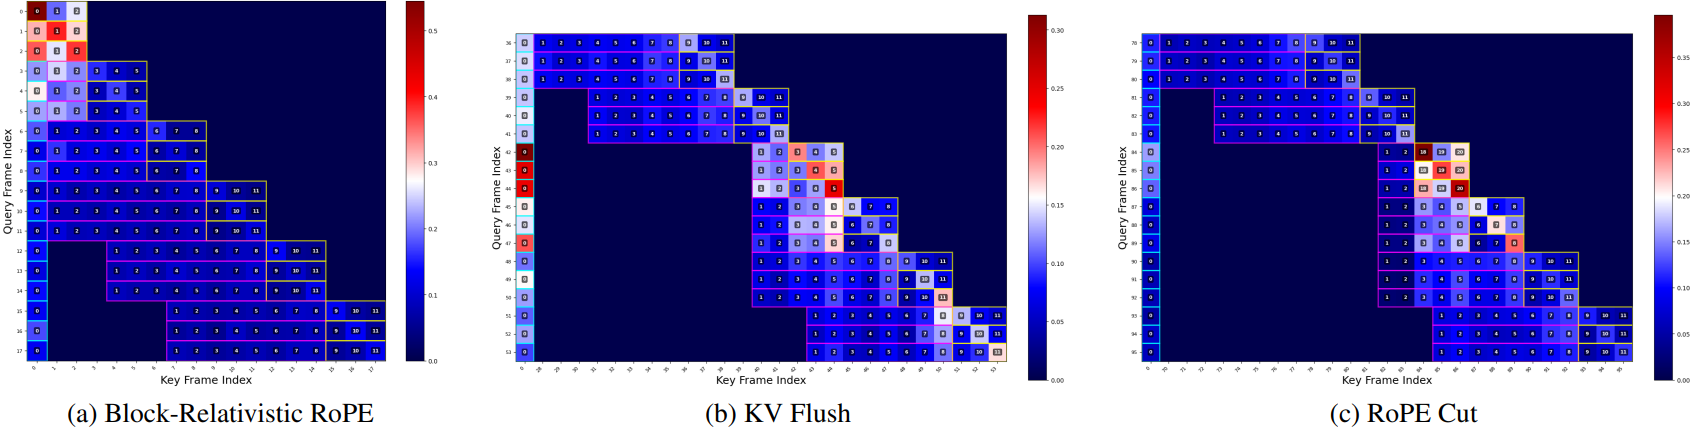
Block-Relativistic RoPE를 이용한 긴 동영상 생성에서 attention은 날카로운 대각선 띠를 형성하는데, 이는 각 프레임이 주로 최근의 이전 프레임에 attention을 하고, 글로벌한 장면 정보를 집계하는 지속적인 초기 sink 열을 형성함을 보여준다. 이러한 패턴은 원래의 3D-RoPE horizon을 훨씬 넘어 안정적으로 유지되는데, 이는 RoPE를 상대론적으로 다시 앵커링하는 것이 상대적인 시간 geometry를 보존하고 attention 붕괴를 방지함을 시사한다.
KV Flush를 사용하면 새로운 프레임에서 중간 과거 프레임으로의 attention이 크게 억제되고, attention이 sink와 flush 전의 마지막 몇 프레임으로 재분배되어 로컬한 모션 연속성을 유지하면서 즉각적인 반응성을 제공한다.
RoPE Cut을 사용하면 attention map이 거의 분리된 두 개의 대각선 블록으로 나뉘는데, 새로운 세그먼트는 자기 자신과 sink에만 집중하여 시간적 컨텍스트를 효과적으로 차단하고 깔끔한 장면 전환을 구현한다.
Experiments
- 구현 디테일
- Base model: Wan2.1-T2V-1.3B에서 distillation한 4-step 모델 (5초, 16 FPS, 832$\times$480)
- KV 캐시 크기: 6
- onset index $f_0 = 21$
- classifier-free guidance scale: 3.0
- timestep shift: 5.0
1. Comparison
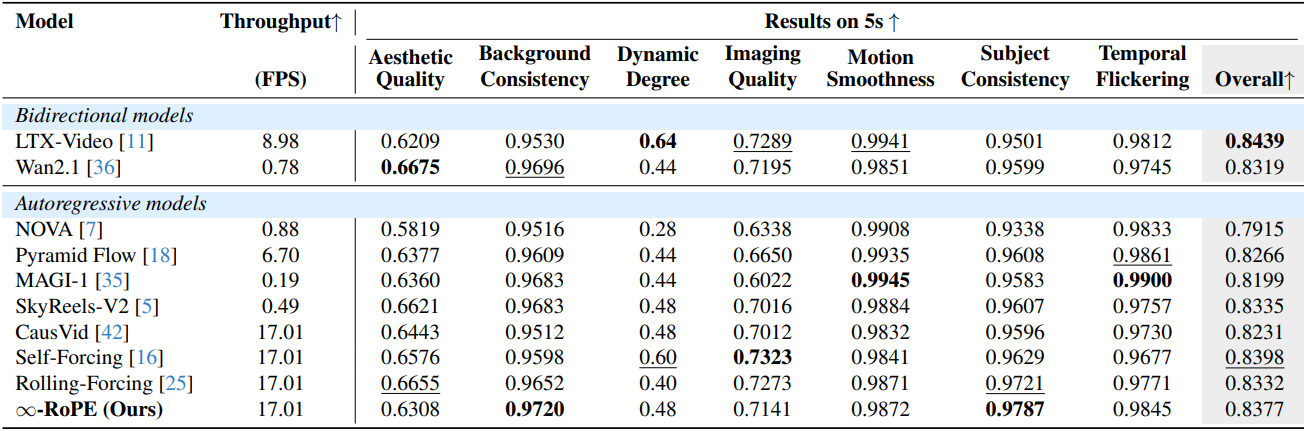
다음은 5초 생성에 대한 비교 결과이다.
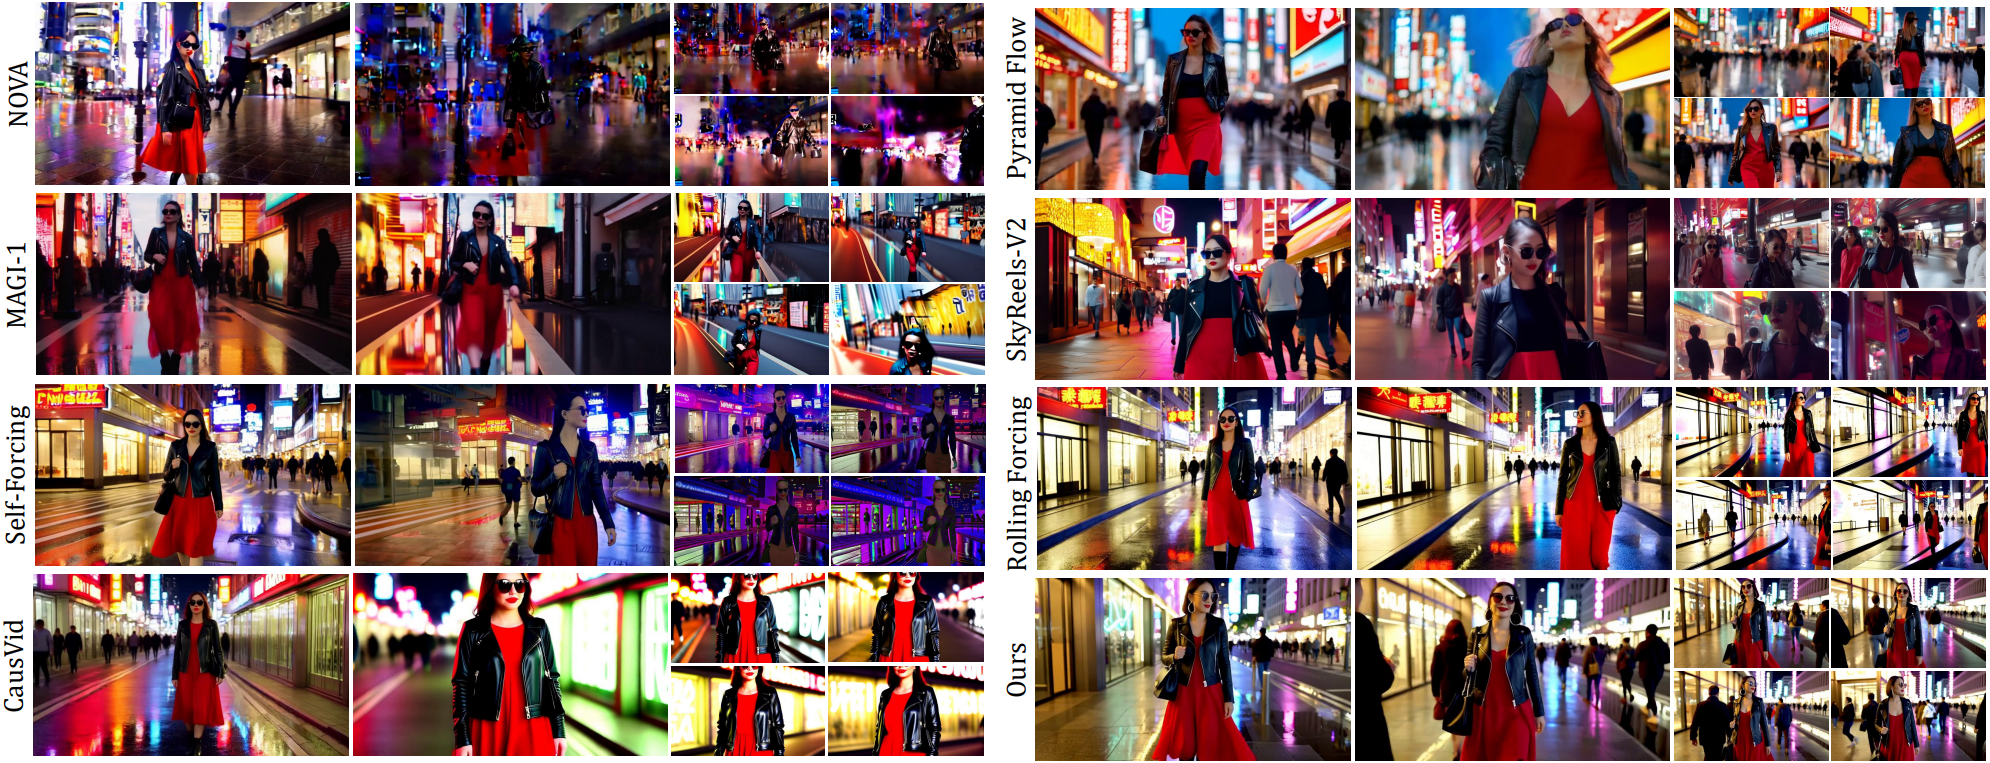
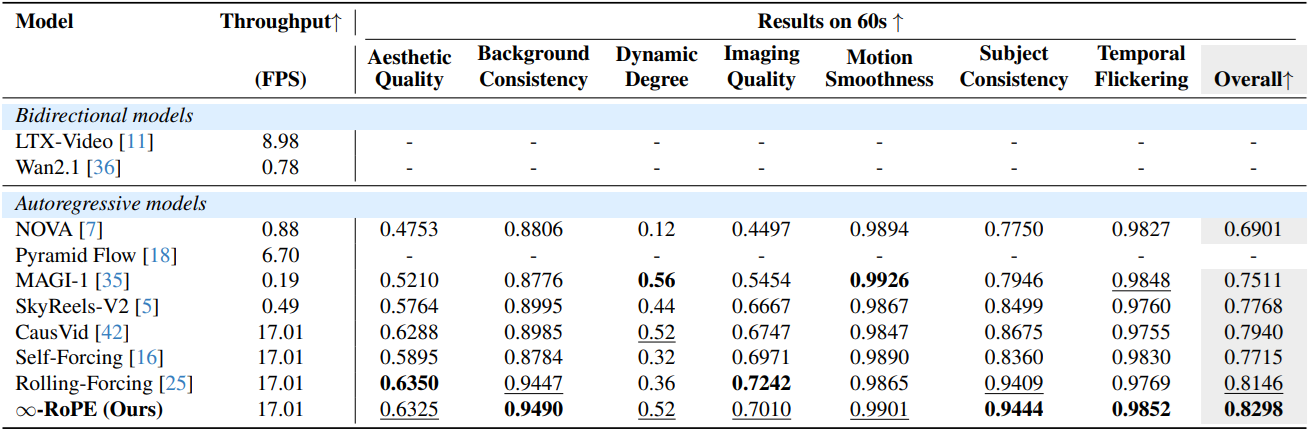
다음은 60초 생성에 대한 비교 결과이다.
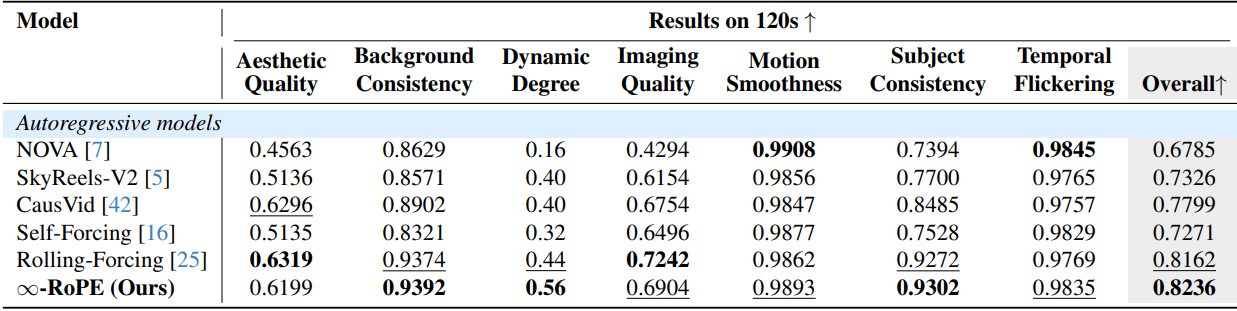
다음은 120초 생성에 대한 비교 결과이다.
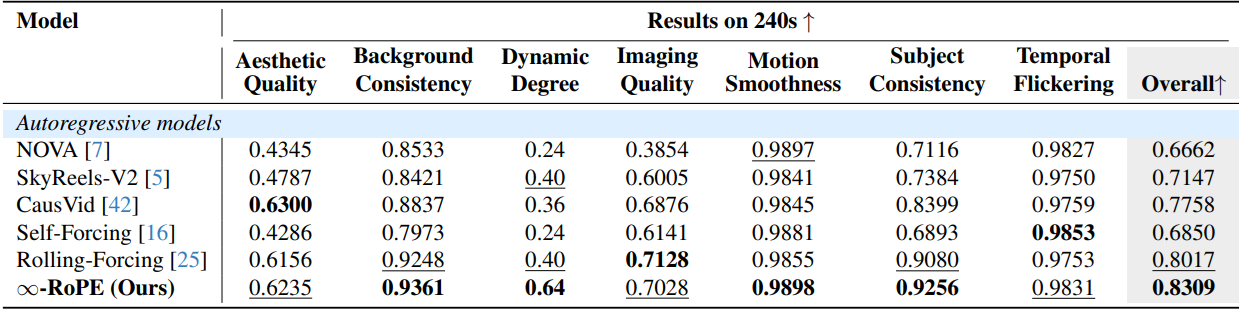
다음은 240초 생성에 대한 비교 결과이다.
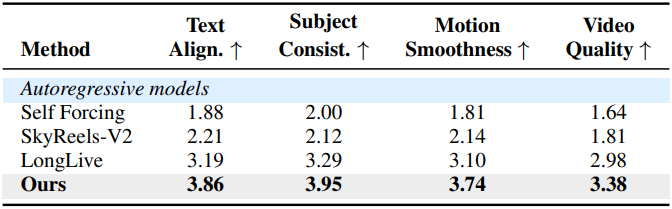
다음은 동작 제어 생성에 대한 비교 결과이다.
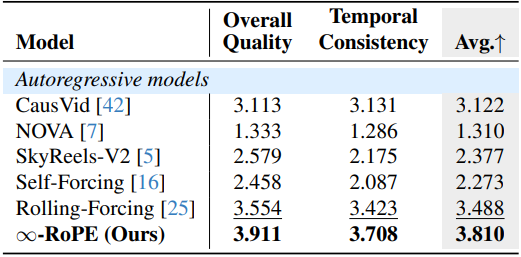
다음은 user study 결과이다.
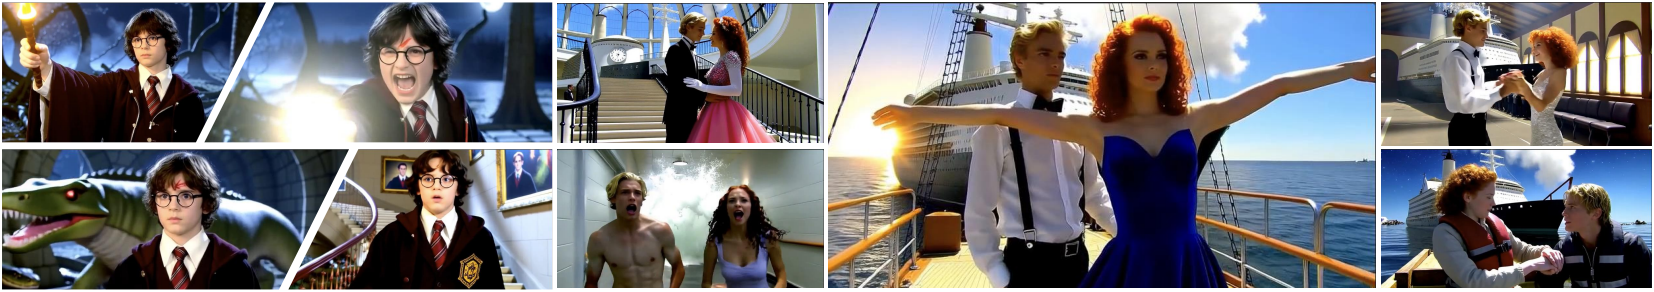
2. Dynamic Scene Cut
다음은 RoPE Cut으로 장면 컷 전환을 한 예시들이다.
3. Ablations
다음은 KV 캐시 크기에 대한 ablation 결과이다.
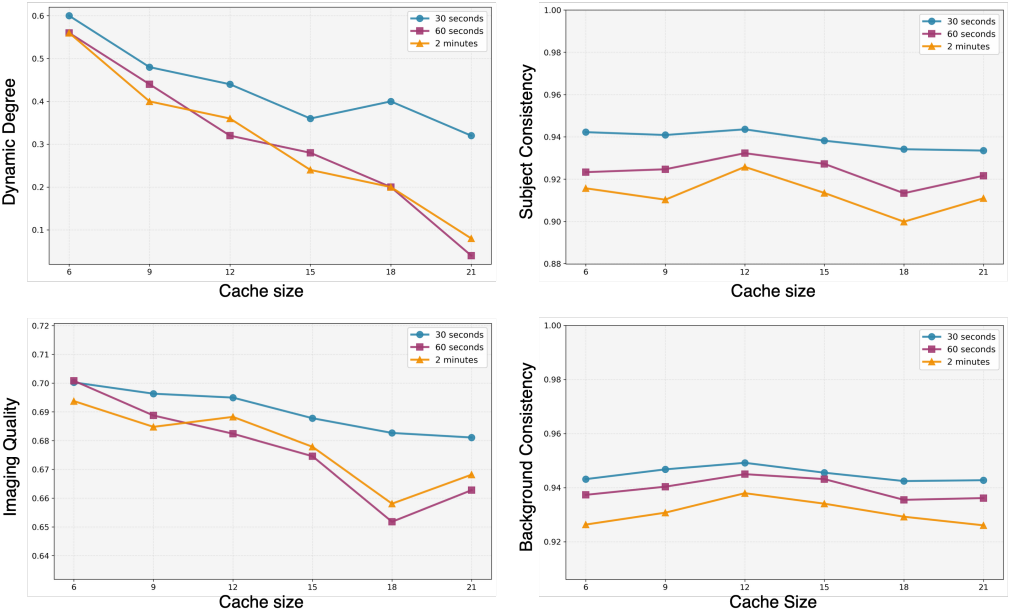
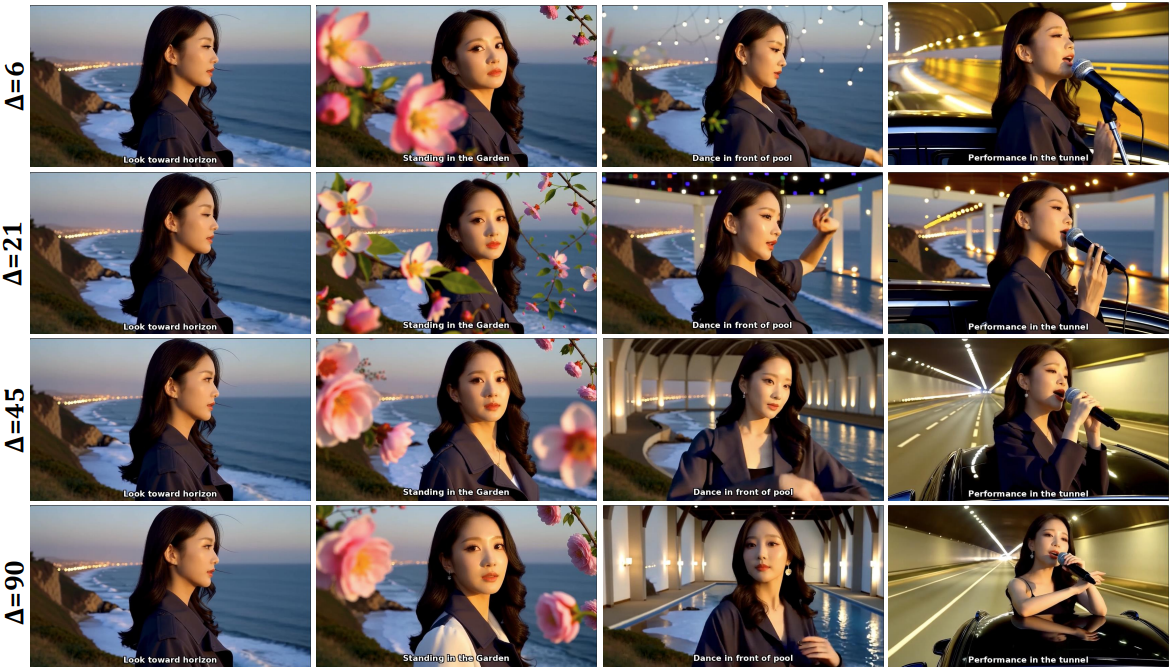
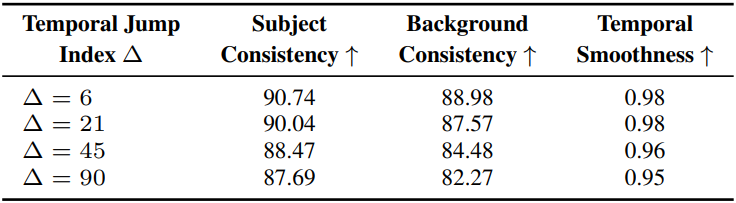
다음은 jump index $\Delta$에 대한 ablation 결과이다.