[논문리뷰] DiP: Taming Diffusion Models in Pixel Space
CVPR 2026. [Paper] [Github]
Zhennan Chen, Junwei Zhu, Xu Chen, Jiangning Zhang, Xiaobin Hu, Hanzhen Zhao, Chengjie Wang, Jian Yang, Ying Tai
Nanjing University | Tencent Youtu Lab | National University of Singapore
24 Nov 2025
Introduction
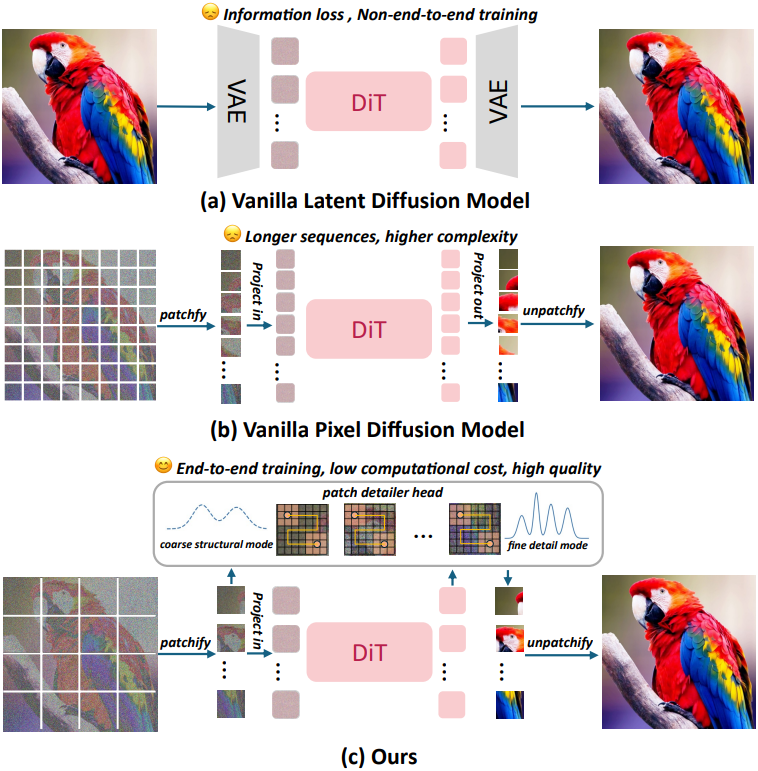
Latent diffusion model (LDM)의 단점을 해소하기 위한 가장 직접적인 해결책은 pixel space에서 diffusion model을 학습시키는 것이다. 그러나 기존의 pixel diffusion model들, 특히 강력한 Transformer 아키텍처를 기반으로 하는 모델들은 심각한 scalability 문제에 직면해 있다. 이러한 모델들은 세밀한 디테일을 포착하기 위해 일반적으로 작은 입력 패치(2$\times$2, 4$\times$4)를 사용하는데, 이로 인해 입력 시퀀스 길이가 이미지 해상도의 제곱에 비례하여 증가하게 된다. 이는 고해상도 데이터에 대한 학습 및 inference를 계산적으로 불가능하게 만든다.
본 논문에서는 이를 해결하기 위해 DiP라 불리는 효율적인 pixel space diffusion 프레임워크를 제안하였다. 저자들은 효율적인 글로벌 구조를 구축하기 위해 DiT Backbone을 도입하였다. 특히, 이 모델은 큰 이미지 패치 16$\times$16으로 작동하도록 설계되었다. 이는 입력 시퀀스 길이를 획기적으로 줄여, VAE를 전혀 사용하지 않으면서도 LDM과 대등한 수준의 연산 효율성을 달성하며, 이미지의 글로벌 레이아웃과 semantic content를 효과적으로 포착할 수 있다.
다만, 큰 패치 단위로만 처리할 경우 고주파 디테일이 결여되어 결과물이 흐릿해지는 문제가 발생한다. 저자들은 이를 해결하기 위해 Patch Detailer Head를 도입하였다. 이 모듈은 전체 파라미터 수를 0.3%만 증가시키는 가벼운 모듈로, 단순한 후처리 단계가 아니라 DiT Backbone과 함께 학습되는 핵심 구성 요소이다. 이 모듈은 각 큰 패치에 대해 DiT로부터 컨텍스트 feature를 전달받고, 강력한 로컬 receptive field를 활용하여 누락된 고주파 정보를 합성해낸다.
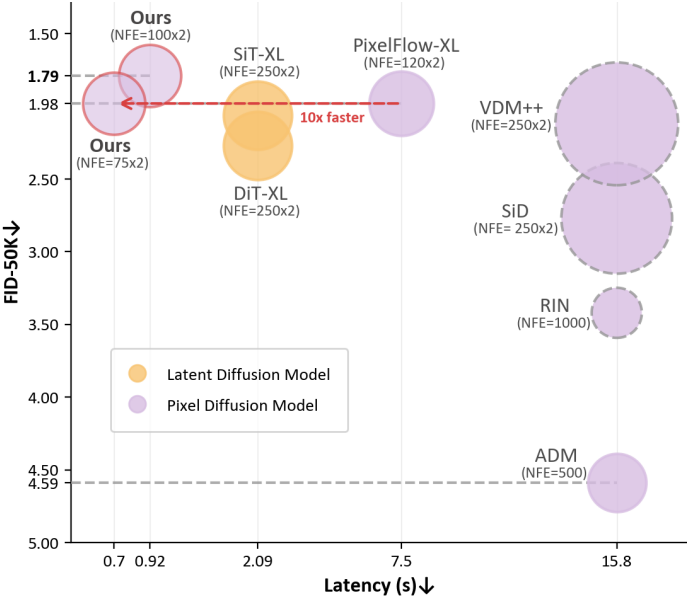
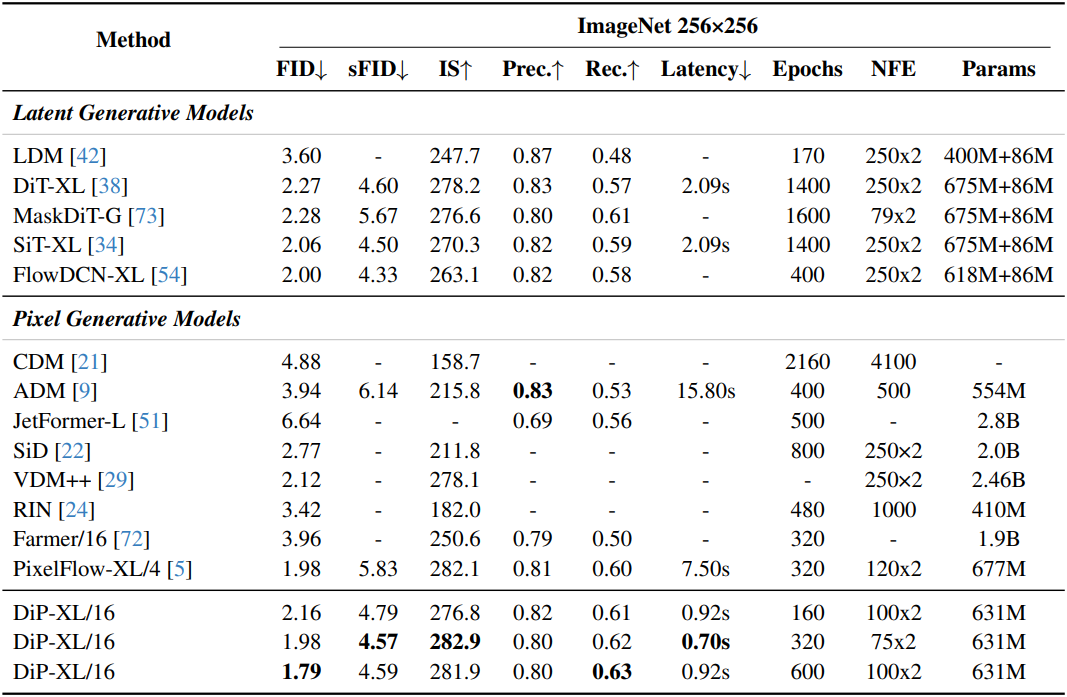
이러한 상호 보완적 설계를 통해 DiT Backbone은 연산 부담이 큰 글로벌 일관성 유지에 집중하고, 효율적인 Patch Detailer Head는 로컬한 텍스처와 디테일 복원을 전담하게 된다. 본 접근 방식은 효율성과 품질 측면에서 새로운 SOTA 성능을 달성하였으며, 기존 방법들보다 훨씬 낮은 latency로 더 우수한 FID를 기록하였다.
Method
1. Motivation
DiT의 self-attention 메커니즘은 패치 간의 거시적 관계를 모델링하는 데는 탁월하지만, 각 패치 내에 담긴 풍부한 공간 정보를 단 하나의 flatten된 토큰으로 압축해 버린다. 이러한 설계에서 모델은 패치들의 거시적인 레이아웃이나 구성은 능숙하게 학습할 수 있지만, 각 패치 내부의 세밀한 텍스처나 고주파 디테일을 모델링하는 데는 어려움을 겪게 되며, 결과적으로 이미지 생성 성능의 상한선이 제한된다.
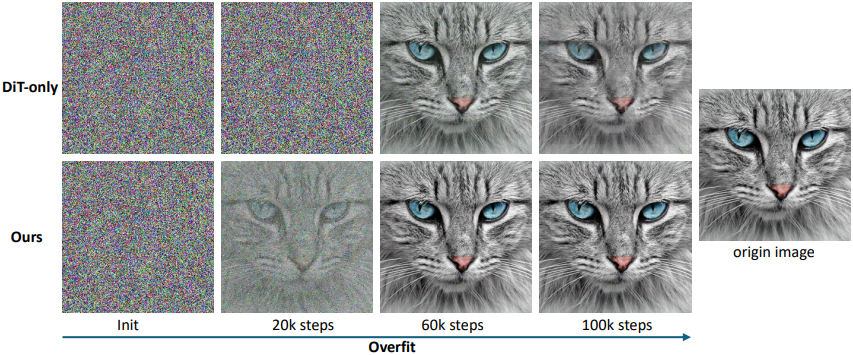
이를 실증적으로 검증하기 위해, 저자들은 pixel space상에서 하나의 고해상도 이미지를 대상으로 DiT 모델을 overfitting시키는 실험을 수행했다. 위 그림에서 볼 수 있듯이, 해당 모델은 전체적인 레이아웃과 색상 팔레트는 성공적으로 포착했으나, 미세한 텍스처와 날카로운 경계는 제대로 구현하지 못해 결과적으로 흐릿한 이미지를 생성했다. 이 결과는 DiT 아키텍처가 이미지에 직접 적용될 경우 로컬한 수준에서의 inductive bias가 부족하여, 각 패치 내에서 정밀한 픽셀 단위의 재구성을 수행하는 데 한계가 있음을 보여준다.
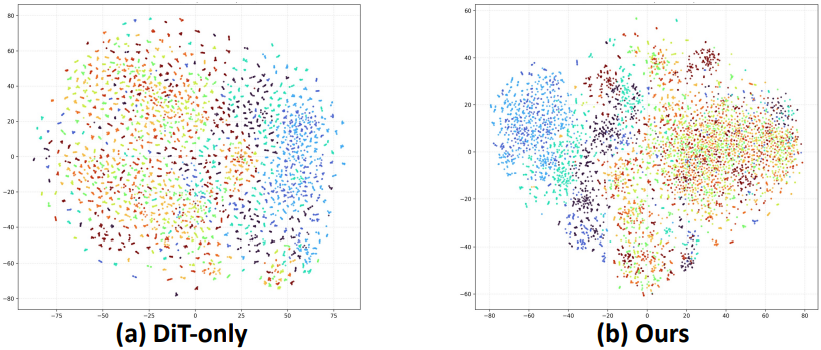
따라서, 로컬 디테일에 필요한 inductive bias를 글로벌 Transformer에 명시적으로 다시 주입하는 전용 모듈을 추가한다. 이러한 방식으로, 모델은 큰 패치 크기가 제공하는 계산 효율성을 활용하는 동시에 세밀한 디테일을 가진 고품질 이미지를 생성할 수 있다. 위 그림에서 볼 수 있듯이, 본 논문의 방법은 클래스 내 클러스터가 더 조밀하고 클래스 간 분리가 더 명확하다. 이는 로컬한 inductive bias의 도입이 pixel space에서 로컬 텍스처와 경계 단서를 더 효과적으로 통합하여 semantic 분리성과 feature 일관성을 향상시킨다는 것을 의미한다. 이러한 개선은 생성 과정에서 더 안정적인 구조적 정렬과 더 나은 디테일을 제공할 것으로 기대된다.
2. Framework
DiP는 먼저 DiT를 활용하여 이미지의 글로벌 구조와 long-range dependency를 모델링한다. 이어서, 가벼운 Patch Detailer Head가 패치 단위로 출력을 정교화하며, 로컬 inductive bias를 도입함으로써 고주파 디테일을 합성해 낸다.
글로벌 구조 구성 (DiT Backbone)
Timestep $t$에서의 noise가 포함된 이미지 $x_t \in \mathbb{R}^{H \times W \times 3}$가 주어지면, 이를 먼저 서로 겹치지 않는 패치들의 시퀀스로 분할한다. 각 패치의 크기는 $P \times P$이며, 결과적으로 $N=(H \times W)/P^2$개의 패치 시퀀스가 생성된다. 이러한 patching 전략을 통해, pixel space 모델은 latent space 기반의 DiT 모델과 유사한 수준의 연산량을 유지할 수 있다. 패치들은 timestep 임베딩 및 위치 임베딩과 함께 일련의 DiT block으로 입력되며, 이를 통해 컨텍스트를 반영한 출력 feature 시퀀스 \(S_\textrm{global} \in \mathbb{R}^{N \times D}\)가 생성된다.
로컬 디테일 정제 (Patch Detailer Head)
Patch Detailer Head는 각 패치에 대해 독립적으로 병렬 처리된다. 각 패치 $i$에 대해 두 가지 입력을 받는다. 하나는 \(S_\textrm{global}\)에서 얻을 수 있는 글로벌 컨텍스트 맵 \(s_i \in \mathbb{R}^{D \times 1 \times 1}\)이고, 다른 하나는 원래 noisy한 픽셀 패치 \(p_i \in \mathbb{R}^{3 \times P \times P}\)이다. Patch Detailer Head의 목표는 \(S_\textrm{global}\)의 글로벌 컨텍스트를 활용하여 $p_i$의 로컬 정보를 정확하게 해석하고, 궁극적으로 해당 패치에 대한 noise 성분 \(\epsilon_i \in \mathbb{R}^{3 \times P \times P}\)를 예측하는 것이다. 모든 $N$개의 패치를 병렬로 처리한 후, 예측된 noise 패치 시퀀스 \(\{\epsilon_i\}_{i=1}^N\)을 재구성하여 전체 해상도의 noise map을 생성한다.
3. Architecture Design
Patch Detailer Head 아키텍처
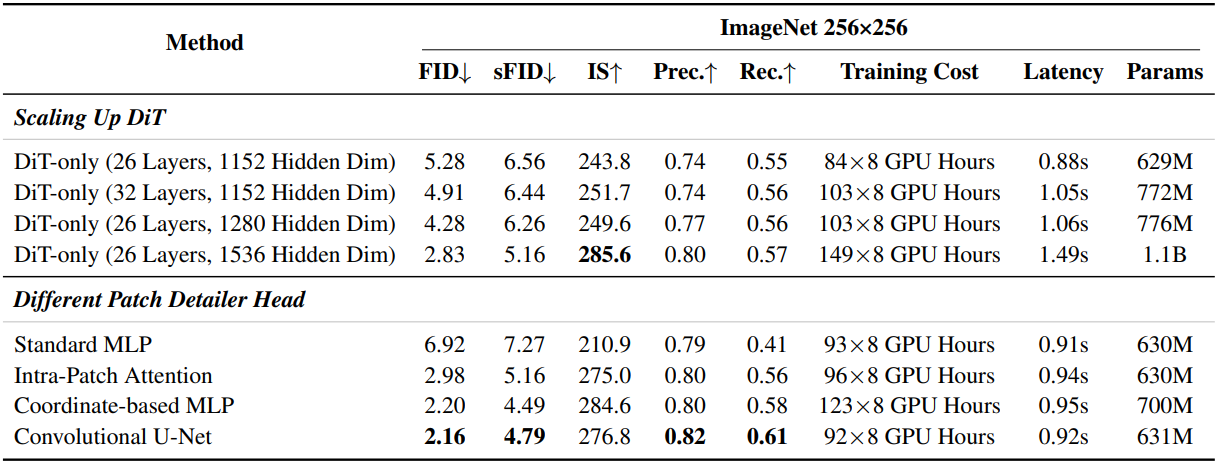
본 논문에서는 Patch Detailer Head에 대해 서로 다른 형태의 inductive bias를 구현하는 여러 아키텍처를 조사했다. 목표는 간단하고 효과적이며 매우 효율적인 설계를 찾는 것이다.
- 표준 MLP: $s_i$와 flatten된 $p_i$를 입력으로 받는 MLP. 간단하지만, 패치 내의 모든 픽셀을 순서가 없는 집합으로 처리하기 때문에 본질적인 inductive bias가 부족하다.
- 좌표 기반 MLP: 공간 인식을 도입하기 위해 $p_i$ 내의 각 픽셀에 대해 정규화된 2D 좌표를 concat한다. $s_i$는 작은 좌표 기반 MLP의 가중치를 동적으로 생성하는 데 사용된다. Convolution이 제공하는 로컬 텍스처 및 구조에 대한 강력한 prior가 부족하다.
- 패치 내 attention: 각 패치 내의 픽셀에 대해 작은 Transformer를 사용하는 방식. 각 패치는 $P^2$개의 픽셀 토큰 시퀀스로 처리된다. 픽셀 간의 복잡한 상호 작용이 가능하지만, 계산 집약적이며 로컬 패턴 학습에 있어 convolution만큼 효율적이지 않을 수 있다.
저자들의 최종 선택은 가벼운 convolution U-Net을 사용하는 것이다. 다운샘플링 및 업샘플링 경로의 계층적 구조와 skip connection의 조합은 멀티스케일 공간 feature를 포착하고 로컬 연속성을 보장하는 데 매우 적합하다. Convolution의 고유한 inductive bias, 즉 locality와 translation 등변성은 로컬 텍스처와 경계의 denoising에 매우 효과적이다.
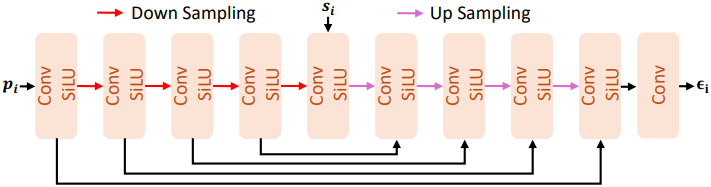
저자들은 4개의 downsampling block과 4개의 upsampling block을 포함하는 얕은 U-Net으로 Patch Detailer Head를 구현했다. 각 block은 convolution, SiLU activation, pooling layer의 순서로 구성된다. $s_i$는 bottleneck에서 다운샘플링 출력과 채널별로 concat된다.
Patch Detailer Head 배치
저자들은 세 가지 배치 전략을 조사했다.
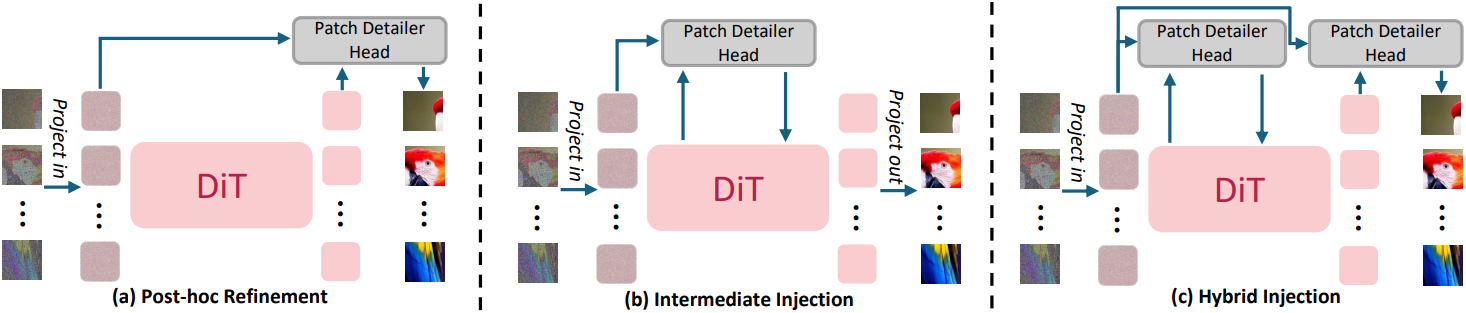
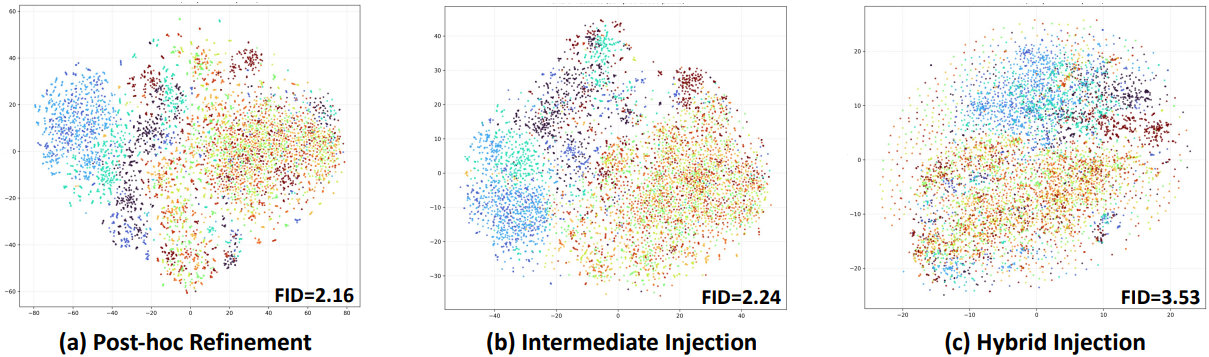
- Post-hoc Refinement: Patch Detailer Head는 최종 DiT block 이후에만 배치된다. 이를 통해 DiT는 글로벌 모델링을 전담하고, Patch Detailer Head는 로컬한 정교화를 전담하게 된다.
- Intermediate Injection: Patch Detailer Head는 DiT block들 사이에 삽입된다. 이후 정교화된 패치 표현들은 다시 projection되어 다음 DiT block들로 전달된다.
- Hybrid Injection: Patch Detailer Head는 DiT의 중간 단계와 최종 단계 모두에 배치된다.
세 가지 전략 모두 비슷한 수준의 성능 향상을 가져온다. 하지만 Post-hoc Refinement 전략은 DiT 내부 구조를 전혀 변경할 필요가 없어 구현이 매우 간편하며, 이미 학습된 DiT 체크포인트를 그대로 사용할 수 있다는 이점이 있다. 따라서 저자들은 최종 아키텍처로 Post-hoc Refinement 전략을 채택했다.
Experiments
1. Main Result
다음은 ImageNet 256$\times$256에서의 성능 비교 결과이다.
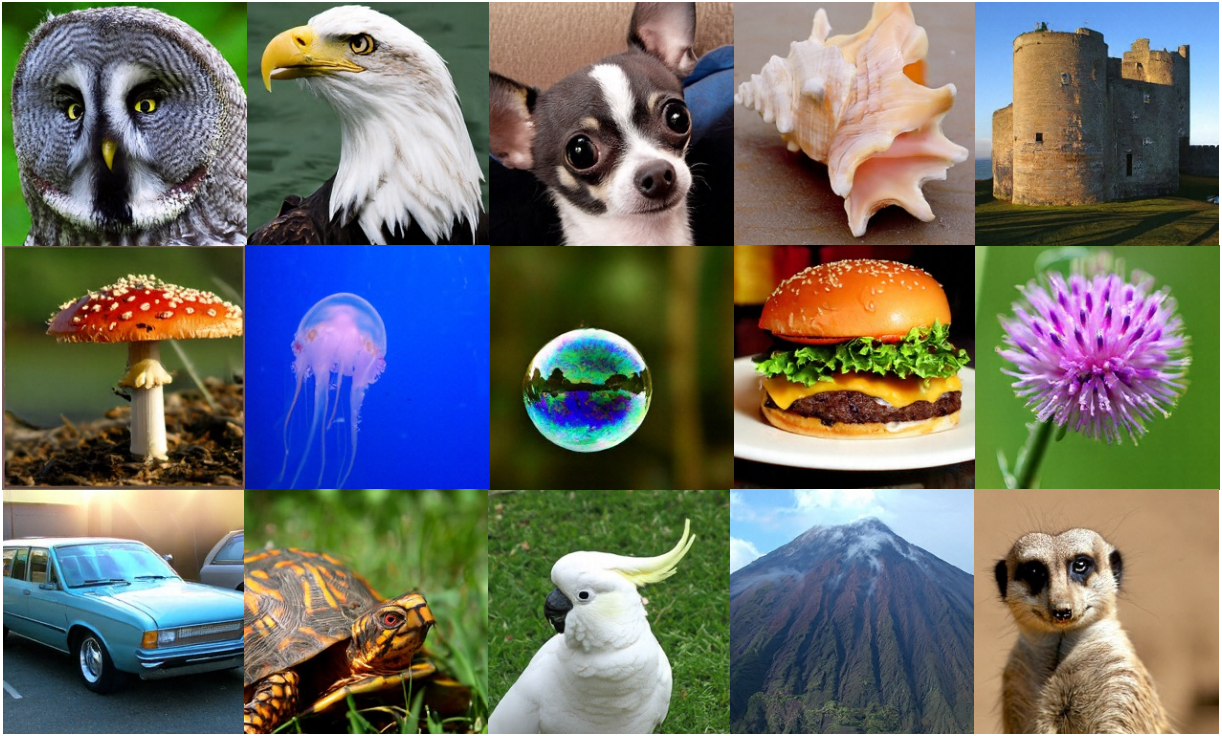
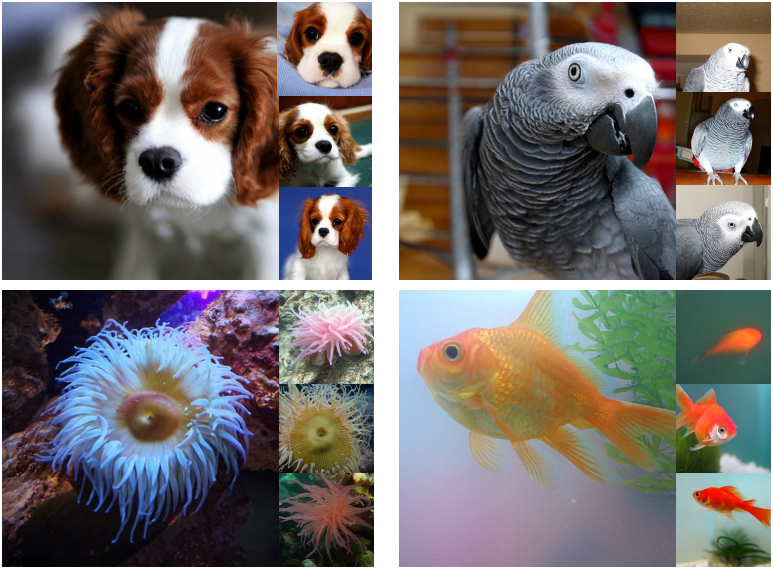
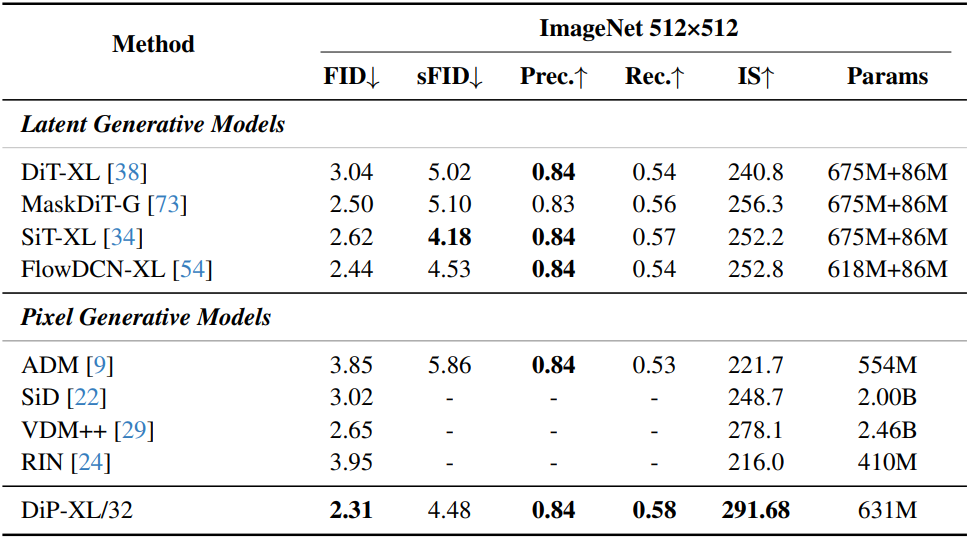
다음은 ImageNet 512$\times$512에서의 성능 비교 결과이다.
2. Analysis
다음은 다양한 디자인 체계에 따른 계산 오버헤드와 성능을 비교한 결과이다.
다음은 Patch Detailer Head 배치 전략에 따른 feature space를 t-SNE로 시각화한 결과이다.
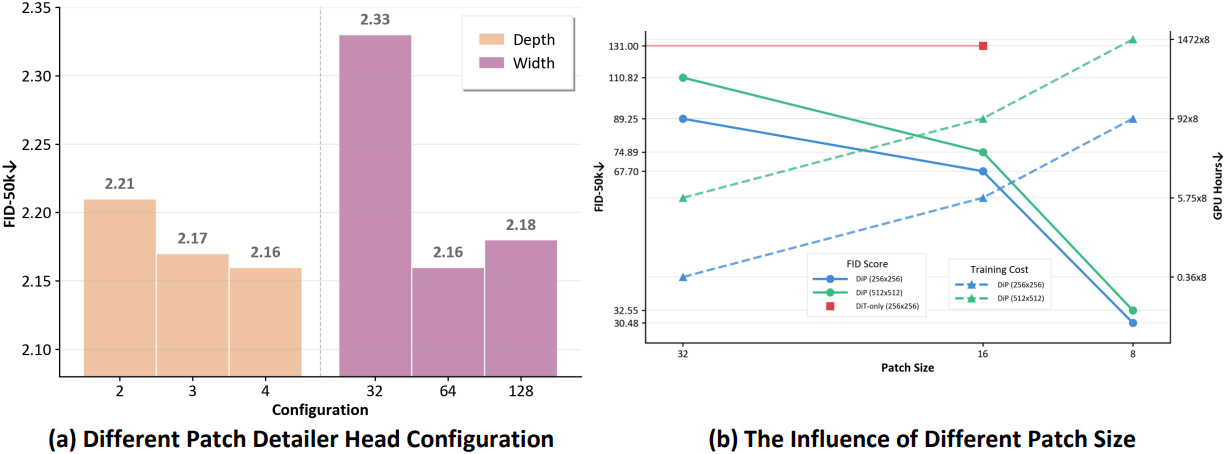
다음은 (a) Patch Detailer Head 구성과 (b) 패치 크기에 따른 성능 비교 결과이다.