[논문리뷰] GRPO-Guard: Mitigating Implicit Over-Optimization in Flow Matching via Regulated Clipping
CVPR 2026. [Paper] [Page] [Github]
Jing Wang, Jiajun Liang, Jie Liu, Henglin Liu, Gongye Liu, Jun Zheng, Wanyuan Pang, Ao Ma, Zhenyu Xie, Xintao Wang, Meng Wang, Pengfei Wan, Xiaodan Liang
Shenzhen Campus of Sun Yat-Sen University | Kuaishou Technology | CUHK MMLab | Tsinghua University | HKUST | USTB | UCAS
25 Oct 2025
Introduction
LLM에서 입증된 GRPO의 성공을 바탕으로, 최근 Flow-GRPO나 DanceGRPO와 같은 연구들은 GRPO 방식의 RL을 diffusion model에 적용했다. 이를 통해 미적 품질, 지시 사항 준수 능력, 텍스트 렌더링 측면에서 주목할 만한 개선을 이루어냈다.
GRPO 프레임워크에서 importance ratio clipping 메커니즘은 주로 학습 안정화에 기여한다. 새로운 policy가 레퍼런스 모델에서 과도하게 벗어날 때 policy 업데이트를 제한함으로써, clipping은 gradient 폭발을 억제하고 denoising step 전반에 걸쳐 제어된 최적화를 유지한다. 이상적으로 importance ratio는 1을 중심으로 유지되어야 하며, 이를 통해 positive 업데이트와 negative 업데이트가 대칭적으로 제한된다. 즉, 과도하게 확신하는 샘플의 gradient를 효과적으로 잘라내고 policy 학습의 균형을 유지한다.
그러나 분석 결과, 이러한 안정화 메커니즘이 diffusion model에서 의도한 대로 작동하지 않는 것으로 나타났다. Importance ratio 분포는 평균값이 지속적으로 1보다 낮고, 분산은 timestep에 따라 크게 변동한다. 이러한 편향 및 불균등한 분포는 양의 advantage를 제공하는 샘플이 clipping 영역에 진입하는 것을 막아, 지나치게 확신에 찬 positive 업데이트가 대부분 제약 없이 이루어지도록 한다.
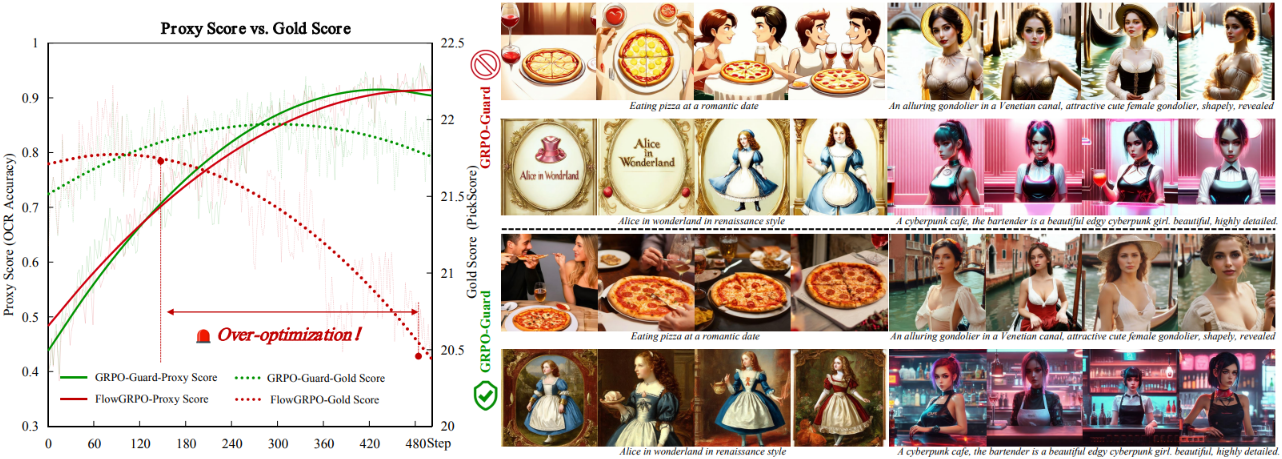
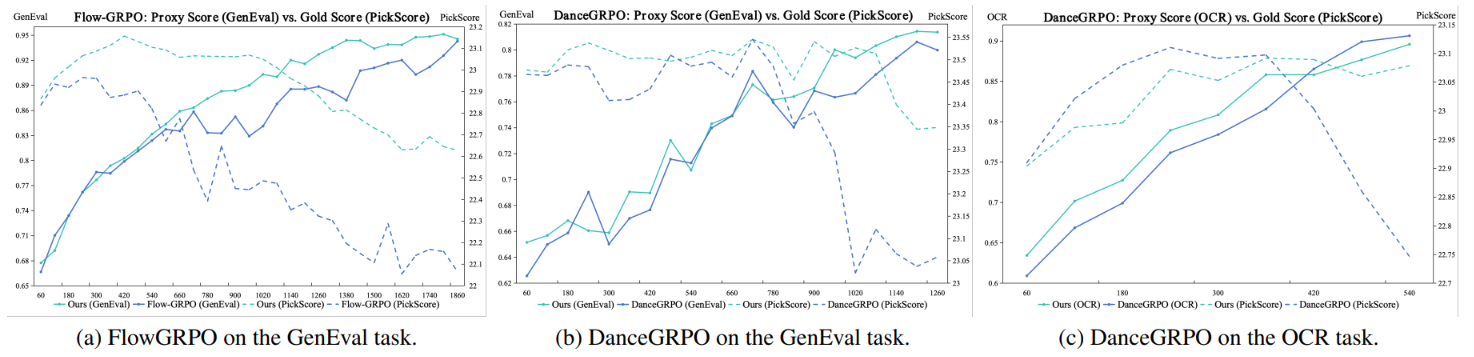
학습이 진행됨에 따라 policy 모델은 점차 over-optimization 상태에 진입하게 된다. Proxy reward는 계속 증가하는 반면, 이미지 충실도나 프롬프트 정렬과 같은 필수 지표는 급격히 저하되어 학습된 policy가 실제 사용에 부적합해진다. 또한, timestep에 따른 분산의 불일치는 이러한 불균형을 악화시킨다. Noise가 높은 step에서는 clipping이 거의 활성화되지 않는 반면, noise가 낮은 step에서는 과도하게 발생하여 noise가 높은 step에서 지속적인 over-optimization을 초래한다. 이는 Flow-GRPO에서 관찰되는 reward hacking의 근본 원인이다.
본 논문에서는 이러한 비정상적인 동작의 원인을 근본적인 설계 불일치에서 찾았다. Diffusion model은 Gaussian 확률을 계산하는 반면, LLM은 discrete한 토큰 확률에 의존한다. 그런데 Flow-GRPO나 DanceGRPO는 적절한 수정 없이 GRPO 공식을 그대로 계승했다. 이러한 문제를 해결하기 위해, 본 논문에서는 기존 GRPO 프레임워크를 효과적으로 개선한 GRPO-Guard를 제안하였다.
GRPO-Guard는 각 denoising step에서 importance ratio 분포를 표준화하는 RatioNorm 절차를 도입하여 평균이 1에 가깝고 분산이 timestep 전반에 걸쳐 일정하게 유지되도록 한다. 이러한 조정은 clipping 메커니즘이 과도하게 확신하는 positive 샘플에서 발생하는 gradient를 잘라내는 기능을 복원하여 불균형으로 인한 over-optimization을 완화하고 policy 학습을 안정화한다.
이러한 수정에도 불구하고 policy gradient는 여전히 timestep에 따라 크게 변동한다. Noise가 적은 step에서는 gradient가 불균형적으로 크게 나타나 policy 모델이 특정 noise 조건에 overfitting되며, 초기 step 탐색과 다양성을 간과하게 된다. 이러한 불균형은 궁극적으로 모델을 하나의 step에 집중된 over-optimization으로 몰아넣는다. 저자들은 이 문제를 완화하기 위해, 모든 step의 gradient를 보다 균일하게 처리하는 gradient balancing 전략을 제안하였다.
GRPO-Guard는 timestep 전반에 걸쳐 건전한 importance ratio 분포와 일관된 clipping을 복원함으로써, KL divergence를 사용하지 않는 기존 baseline과 대등한 수준의 빠른 수렴을 달성하는 동시에 over-optimization을 크게 줄여준다. 또한, GRPO-Guard는 다양한 GRPO 변형, 여러 backbone, 다양한 task 전반에서 일관되게 reward hacking 문제를 완화한다.
Method
1. Preliminary: Flow-GRPO and DanceGRPO
Flow-GRPO와 DanceGRPO는 Flow Matching에 사용되는 ODE 기반의 deterministic flow를 SDE 형태로 변환하여 샘플링 과정에 확률성을 도입하였다. Flow-GRPO와 DanceGRPO에서의 SDE 샘플링 과정은 다음과 같이 나타낼 수 있다.
\[\begin{equation} x_{t + dt} = \underbrace{x_t + \left[ v_\theta (x_t, t) + \frac{\sigma_t^2}{2t} (x_t + (1-t) v_\theta (x_t, t)) \right] dt}_{\mu_\theta (x_t, t)} + \sigma_t \sqrt{dt} \epsilon, \quad \epsilon \sim \mathcal{N}(0, I) \end{equation}\]Flow-GRPO에서 noise level \(\sigma_t\)는 \(\sigma_t = \eta \sqrt{\frac{t}{1-t}}\)로 정의된다. 반면, DanceGRPO는 상수 noise level $\sigma = \eta$를 채택한다.
이어서, 동일한 조건 입력 $c$가 주어지면 SDE 샘플링 과정을 통해 다양한 샘플 그룹 \(\{x_0^i\}_{i=1}^G\)가 생성된다. 각 샘플은 reward model을 통해 평가되며, reward model은 각 샘플에 스칼라 점수 \(R(x_0^i)\)를 부여한다. 이후, 그룹 내 상대적 advantage는 다음과 같이 계산된다.
\[\begin{equation} \hat{A}_t^i = \frac{R (x_0^i) - \textrm{mean} (\{R (x_0^i)\}_{i=1}^G)}{\textrm{std}(\{R (x_0^i)\}_{i=1}^G)} \end{equation}\]그런 다음, GRPO 알고리즘은 다음과 같은 objective를 최대화함으로써 policy 모델을 최적화한다.
\[\begin{equation} \mathcal{J}_\textrm{policy} (\theta) = \frac{1}{G} \sum_{i=1}^G \frac{1}{T} \sum_{t=0}^{T-1} \left( \min (r_t^i (\theta) \hat{A}_t^i, \textrm{clip} (r_t^i (\theta), 1 - \epsilon, 1 + \epsilon) \hat{A}_t^i) \right) \\ \textrm{where} \quad r_t^i (\theta) = \frac{p_\theta (x_{t-1}^i \vert x_t^i, c)}{p_{\theta_\textrm{old}} (x_{t-1}^i \vert x_t^i, c)} \end{equation}\]Flow-GRPO에서는 reward hacking을 완화하기 위해 추가적인 KL 페널티 \(D_\textrm{KL} (\pi_\theta \vert \vert \pi_\textrm{ref})\)를 도입하였으며, 이를 통해 policy 모델이 레퍼런스 flow model과 유사한 상태를 유지하도록 제약한다. DanceGRPO는 동일한 그룹 내의 샘플들에 사용되는 초기 랜덤 noise \(\{x_1^i\}_{i=1}^G\)가 모두 동일하도록 강제함으로써, 동일한 출발점에서 비롯되도록 보장한다.
2. Inherent Distributional Anomalies
이상적으로는 importance ratio가 1을 중심으로 유지되어야 하며, 이를 통해 positive 업데이트와 negative 업데이트가 대칭적으로 제한될 수 있다. 즉, 지나치게 확신하는 샘플로부터의 gradient를 절삭함으로써 균형 잡힌 policy 학습을 유지하는 것이다. 그러나 diffusion model에서는 importance ratio 분포가 종종 비정상적으로 이동하는 현상이 발생하며, 이로 인해 positive 샘플에 대한 clipping 메커니즘이 제대로 작동하지 않게 된다.
Flow matching에서 policy 모델 $\theta$에 대한 log-probability \(\log p_\theta (x_{t-1} \vert x_t, c)\)는 Gaussian 확률 공식을 사용하여 계산된다.
\[\begin{aligned} \log p_\theta (x_{t-1} \vert x_t, c) &= - \frac{\| x_{t-1} - \mu_\theta (x_t, t) \|^2}{2 \sigma_t^2 dt} - C_t \\ &= - \frac{\| \mu_{\theta_\textrm{old}} (x_t, t) + \sigma_t \sqrt{dt} \epsilon - \mu_\theta (x_t, t) \|^2}{2 \sigma_t^2 dt} - C_t \end{aligned}\]결과적으로, log-importance ratio $\log r_t (\theta)$에 대한 식을 다음과 같이 유도할 수 있다.
\[\begin{aligned} \log r_t (\theta) &= \log p_\theta (x_{t-1} \vert x_t, c) - \log p_{\theta_\textrm{old}} (x_{t-1} \vert x_t, c) \\ &= - \frac{\| \mu_{\theta_\textrm{old}} (x_t, t) - \mu_\theta (x_t, t) + \sigma_t \sqrt{dt} \epsilon \|^2}{2 \sigma_t^2 dt} + \frac{\| \mu_{\theta_\textrm{old}} (x_t, t) - \mu_{\theta_\textrm{old}} (x_t, t) + \sigma_t \sqrt{dt} \epsilon \|^2}{2 \sigma_t^2 dt} \\ &= - \frac{\| \Delta \mu_\theta + \sigma_t \sqrt{dt} \epsilon \|^2}{2 \sigma_t^2 dt} + \frac{\| \epsilon \|^2}{2} \\ &= - \frac{\| \Delta \mu_\theta \|^2}{2 \sigma_t^2 dt} - \frac{ \Delta \mu_\theta \cdot \epsilon}{\sigma_t \sqrt{dt}} \end{aligned}\](간단하게 \(\Delta \mu_\theta = \mu_{\theta_\textrm{old}} (x_t, t) - \mu_\theta (x_t, t)\)로 표현)
$\epsilon \sim \mathcal{N}(0,I)$에 대한 기댓값을 구하면 다음과 같다.
\[\begin{equation} \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} [\log r_t (\theta)] = - \frac{\| \Delta \mu_\theta \|^2}{2 \sigma_t^2 dt} \end{equation}\]이 이차항은 log-importance ratio에 timestep에 따라 달라지는 음의 편향을 유발한다. Importance ratio 기댓값이 일반적으로 1보다 작기 때문에 양의 advantage를 가진 샘플은 clipping 경계 상한을 거의 넘지 않는다. 결과적으로, 지나치게 확신에 찬 positive 예측에서 발생하는 gradient는 대부분 유지되는 반면, negative 샘플에서 발생하는 gradient는 더 심하게 제약되어 policy가 over-optimization될 가능성이 높아진다.
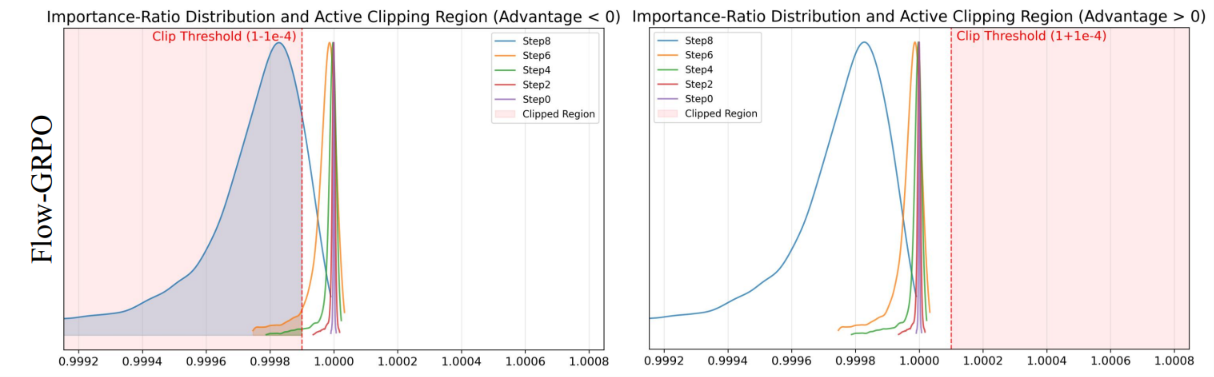
또한, importance ratio의 분산은 \(\sigma_t\)나 $dt$와 같은 denoising scheduler 파라미터에 따라 달라지며, 이로 인해 timestep별로 큰 차이를 보이게 된다. 이러한 분산의 불일치는 clipping 불균형을 더욱 심화시킨다. 즉, noise가 적은 단계에서는 clipping threshold를 초과하는 경우가 잦은 반면, noise가 많은 단계에서는 clipping이 거의 발생하지 않게 되며, 이는 결과적으로 policy가 특정 timestep에 over-optimization되는 방향으로 나아가게 만든다.
3. Regulated Clipping
가장 간단한 접근 방식은 각 timestep마다 전용 clipping 범위를 설계하는 것이다. 그러나 이 방법은 수많은 hyperparameter를 조정하고 특정 모델과 task에 대해 최적에 가까운 범위를 찾기 위해 광범위한 실험을 수행해야 한다.
이러한 과정을 단순화하고 importance ratio 분포의 평균과 분산에서 timestep에 따른 차이를 신속하게 줄이기 위해, $\log r_t (\theta)$를 정규화한다. 이 정규화는 평균을 0에 가깝게 이동시키고 denoising scheduler 파라미터의 영향을 제거하는 동시에 \(\Delta \mu_\theta\)의 부호와 상대적 크기를 유지한다. 구체적으로, 이 연산은 다음과 같이 정의된다.
\[\begin{aligned} \log \hat{r}_t (\theta) &= \sigma_t \sqrt{dt} (\log r_t (\theta) + \frac{\| \Delta \mu_\theta \|^2}{2 \sigma_t^2 dt}) \\ &= - \Delta \mu_\theta \cdot \epsilon \end{aligned}\]정규화를 수행한 후, importance ratio의 분포는 아래 그래프와 같이 나타나며, 이때 평균값은 0에 가까워진다.
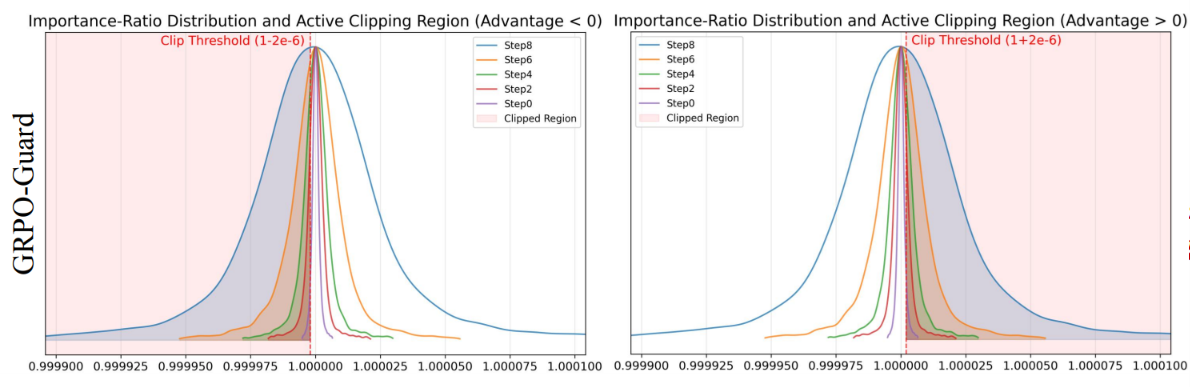
결과적으로 clipping 경계가 효과적으로 작동할 수 있게 되어, Flow-GRPO의 학습 안정성이 향상된다.
그러나 log ratio는 여전히 timestep에 따라 상당한 분산 차이를 보이며, 이로 인해 단일 clipping 범위를 적용할 경우 clipping이 불균일하게 발생한다. Noise가 많은 timestep에서는 gradient가 거의 clipping되지 않으며, 양의 advantage와 큰 ratio 값을 가진 샘플들은 gradient에 대한 기여도가 그대로 유지되어 over-optimization 문제가 발생한다.
4. Gradient Analysis
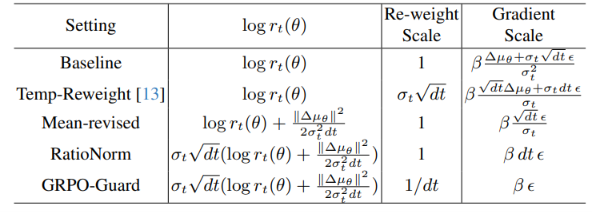
이러한 분산의 불일치는 주로 noise 항과 관련된 계수들에서 기인하는데, 이 계수들은 diffusion model의 timestep 특성과 본질적으로 연관되어 있다. 이를 해결하기 위해 본 논문에서는 noise 계수의 영향을 제거함으로써 timestep 간의 분산을 줄이고, reward hacking 현상을 완화하였다. Log ratio는 denoising process와 관련된 곱셈 및 덧셈 연산을 거치게 되며, 이는 policy gradient에 추가적인 영향을 미친다.
먼저, Flow-GRPO에서의 policy gradient를 다시 살펴보자. Policy 모델의 샘플링 및 학습 과정을 고려할 때, Flow-GRPO나 DanceGRPO에서의 policy gradient는 다음과 같다. (clipping 연산, min 연산, KL 페널티 생략)
\[\begin{aligned} \nabla_\theta \mathcal{J} (\theta) &= \sum_{t=0}^{T-1} \hat{A}_t \nabla_\theta r_t (\theta) = \sum_{t=0}^{T-1} \hat{A}_t r_t (\theta) \nabla_\theta \log r_t (\theta) \\ &= \sum_{t=0}^{T-1} \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} \left[ \hat{A}_t r_t (\theta) \nabla_\theta \log p_\theta (x_{t-1} \vert x_t) \right] \\ &= \sum_{t=0}^{T-1} \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} \left[ \frac{\Delta \mu_\theta + \sigma_t \sqrt{dt} \epsilon}{\sigma_t^2 dt} \hat{A}_t r_t (\theta) \nabla_\theta \mu_\theta (x_t \vert t) \right] \\ &= \sum_{t=0}^{T-1} \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} \left[ \frac{\Delta \mu_\theta + \sigma_t \sqrt{dt} \epsilon}{\sigma_t^2 dt} \hat{A}_t r_t (\theta) \cdot \left( 1 + \frac{\sigma_t^2 (1-t)}{2t} \right) dt \nabla_\theta v_\theta (x_t \vert t) \right] \\ &= \sum_{t=0}^{T-1} \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} \left[ \frac{\Delta \mu_\theta + \sigma_t \sqrt{dt} \epsilon}{\sigma_t^2} \hat{A}_t r_t (\theta) \cdot \left( 1 + \frac{\sigma_t^2 (1-t)}{2t} \right) \nabla_\theta v_\theta (x_t \vert t) \right] \end{aligned}\]Flow-GRPO에서 \(\sigma_t = \eta \sqrt{\frac{t}{1-t}}\)이므로, 계수 \((1 + \frac{\sigma_t^2 (1-t)}{2t}) = 1 + \frac{\eta^2}{2}\)는 timestep에 걸쳐 거의 일정하게 유지된다. 따라서 이를 상수항 $\beta$로 단순화한다.
\[\begin{equation} \nabla_\theta \mathcal{J} (\theta) = \sum_{t=0}^{T-1} \mathbb{E}_{\epsilon \sim \mathcal{N}(0,I)} \left[ \beta \frac{\Delta \mu_\theta + \sigma_t \sqrt{dt} \epsilon}{\sigma_t^2} \hat{A}_t r_t (\theta) \nabla_\theta v_\theta (x_t \vert t) \right] \end{equation}\]여기서 \(\beta \frac{\Delta \mu_\theta + \sigma_t \sqrt{dt} \epsilon}{\sigma_t^2}\)은 advantage 항과는 독립적인 gradient scale로 정의된다. 아래 그래프는 다양한 timestep에 걸쳐 Flow-GRPO의 policy gradient와 그에 대응하는 gradient scale을 시각화한 것이다. 이 둘은 timestep에 강한 상관관계를 보이며, noise level이 감소함에 따라 gradient의 크기가 커지는 일관된 경향을 나타낸다.
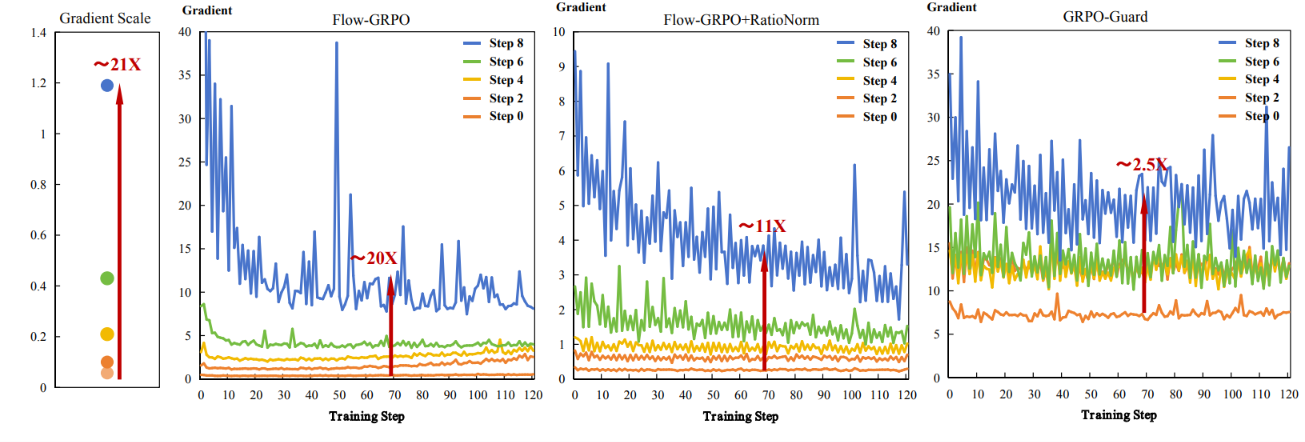
RatioNorm을 적용한 후에는 다음 식에서 볼 수 있듯이 policy gradient가 덜 민감해진다.
여기서 $r_t (\theta)$와 \(\hat{r}_t (\theta)\)는 일반적으로 [0.999, 1.001] 범위 내에 위치하므로, 이들이 gradient에 미치는 직접적인 영향은 무시할 수 있을 정도이다. RatioNorm을 적용하면 \(\Delta \mu_\theta\)나 \(\sigma_t\)와 같은 요소들로부터 발생하는 간섭이 제거되어, policy gradient가 더욱 정확해진다.
그러나 gradient scale은 여전히 timestep에 의존하는 계수 $dt$의 영향을 받는다. 이러한 현상은 최적화 과정에서 특정 step들이 지나치게 큰 영향력을 행사하게 만든다. Policy 업데이트가 전체 샘플링 궤적 내의 단일 noise 조건에 집중되는 경향이 있어, 결과적으로 over-optimization의 위험이 커지기 때문이다.
Over-optimization 문제를 더욱 완화하기 위해, policy loss에 reweighting 계수 \(\delta = 1/dt\)를 도입한다. 이러한 조정은 서로 다른 timestep 간의 gradient 크기를 효과적으로 정규화하여, 더욱 안정적인 최적화 과정을 가능하게 한다. DanceGRPO의 경우 $\beta$가 상수가 아니므로, reweighting 계수는 $\delta = 1/(\beta dt)$로 정의된다.
Policy loss의 최종 형태는 다음과 같이 표현된다.
\[\begin{equation} \mathcal{J}_\textrm{policy} (\theta) = \frac{1}{G} \sum_{i=1}^G \frac{1}{T} \sum_{t=0}^{T-1} \left( \delta \min \left(\hat{r}_t^i (\theta) \hat{A}_t^i, \textrm{clip} (\hat{r}_t^i (\theta), 1 - \epsilon, 1 + \epsilon) \hat{A}_t^i \right) \right) \end{equation}\]Experiments
1. Main Results
다음은 다양한 gold score에 대한 비교 결과이다.
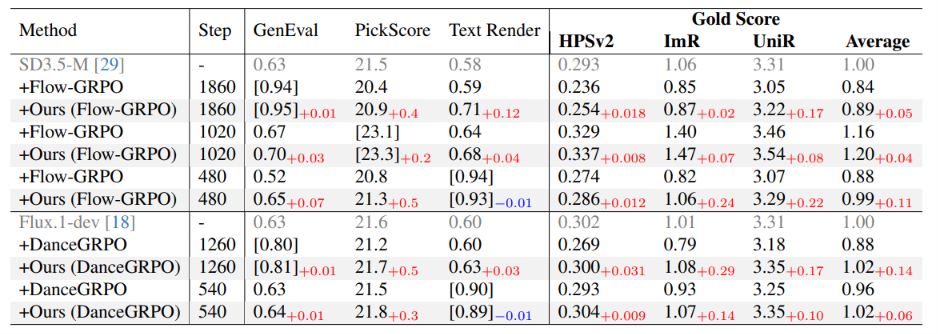
다음은 GenEval(실선)과 PickScore(점선)에 대한 validation curve를 비교한 그래프들이다.
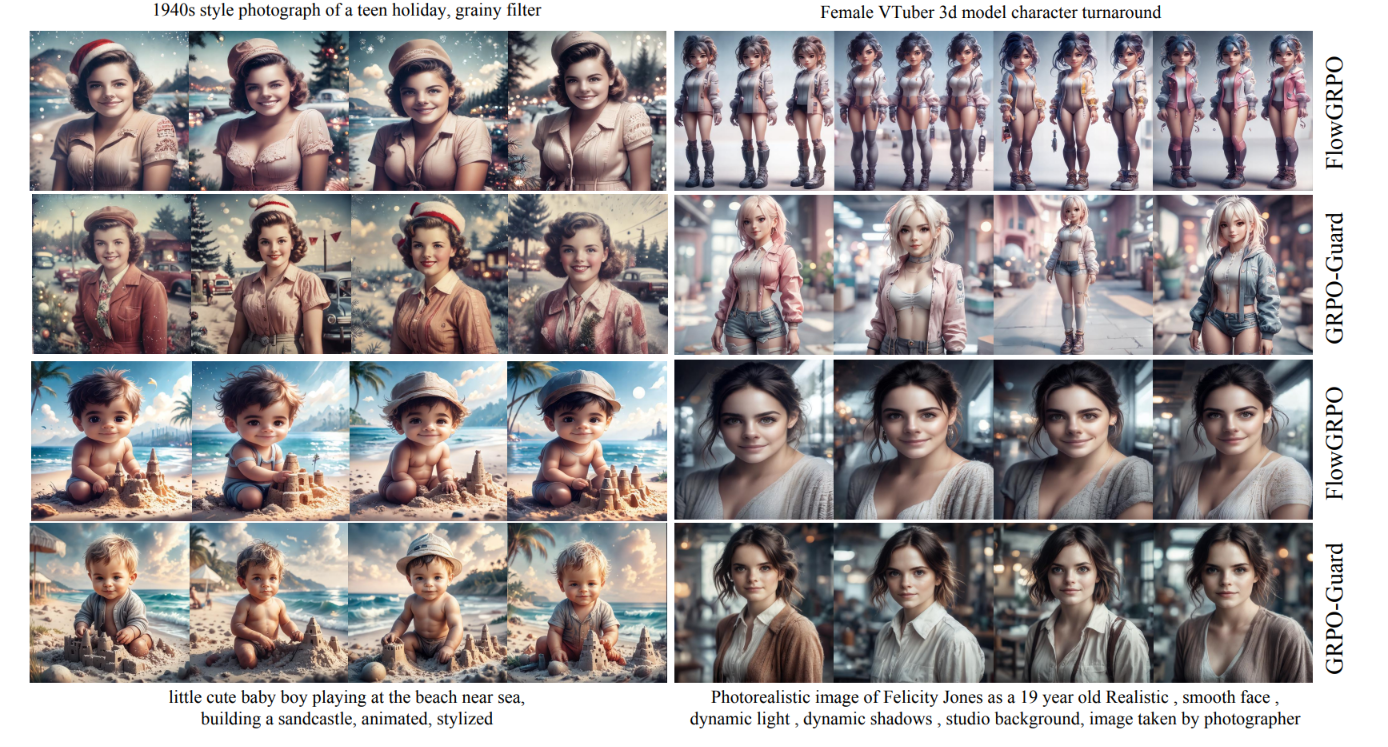
다음은 Flow-GRPO와의 시각적 비교 결과이다.
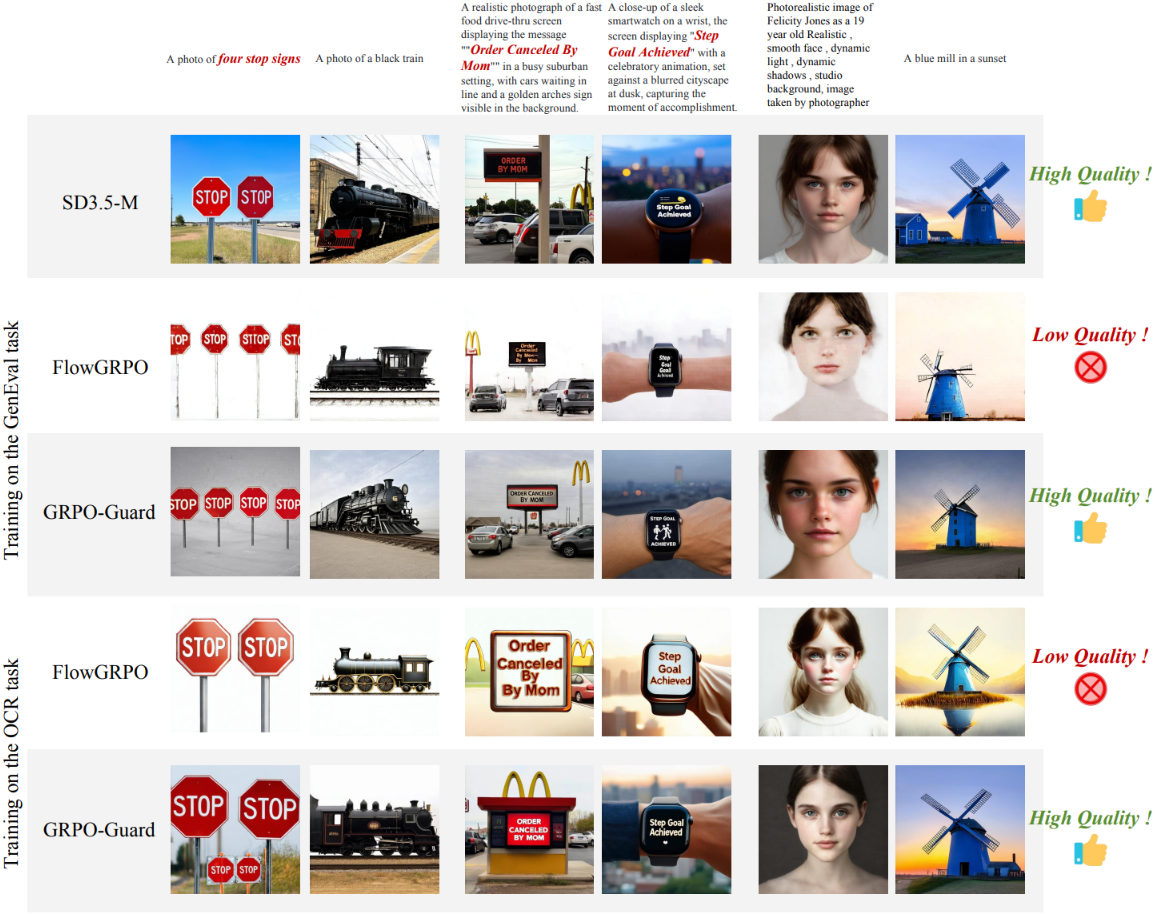
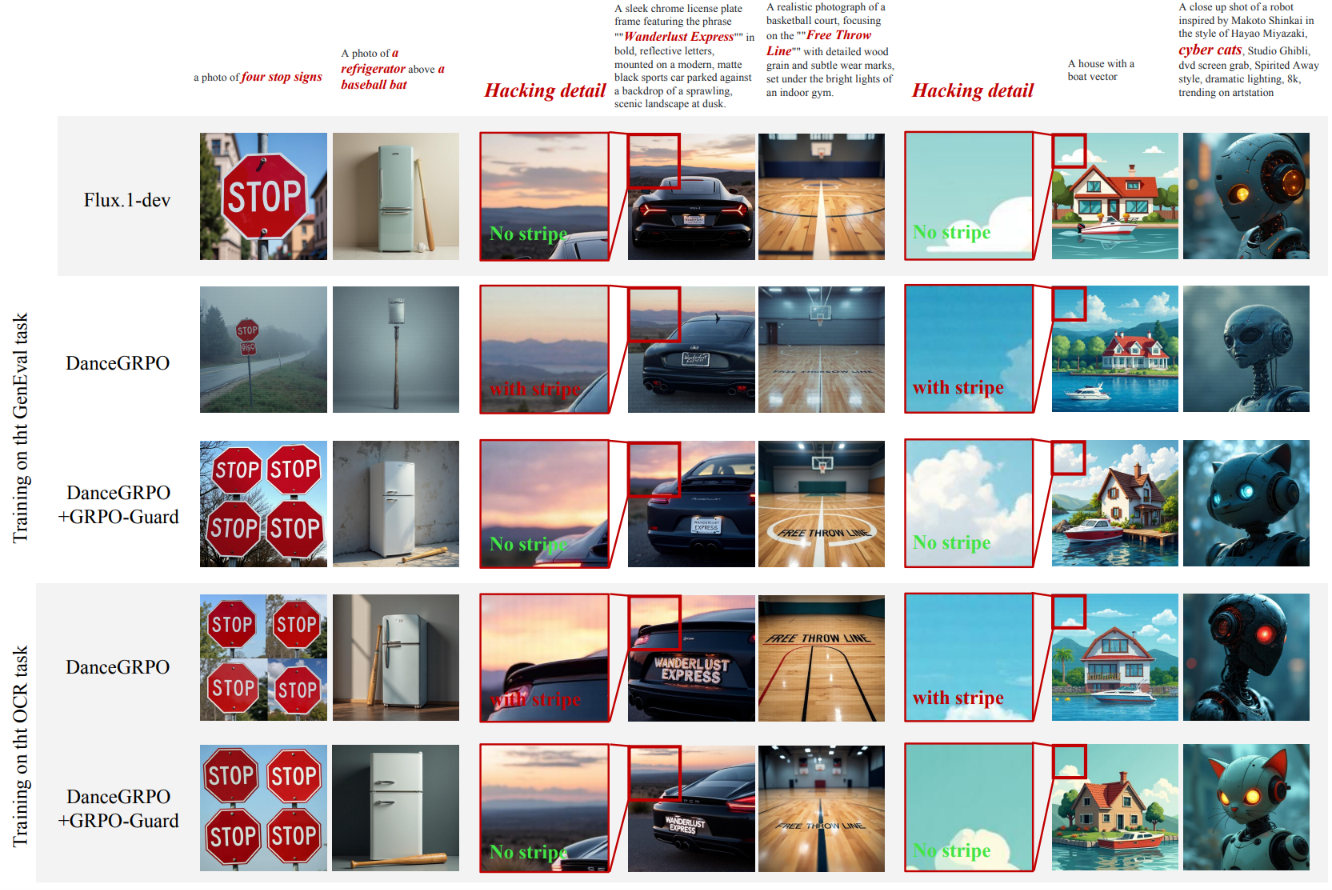
다음은 DanceGRPO와의 시각적 비교 결과이다.
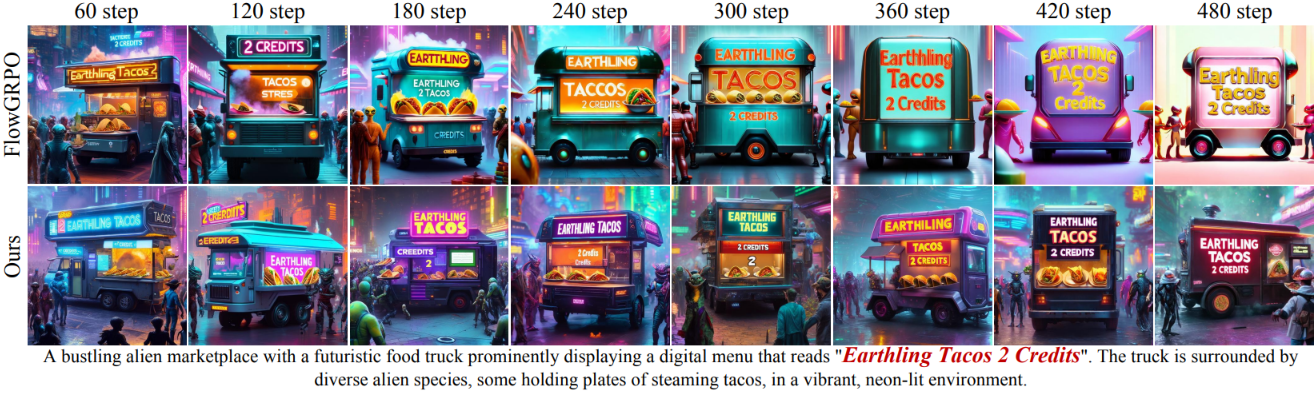
다음은 학습이 진행됨에 따른 생성 결과를 Flow-GRPO와 비교한 것이다.
2. Ablation Study
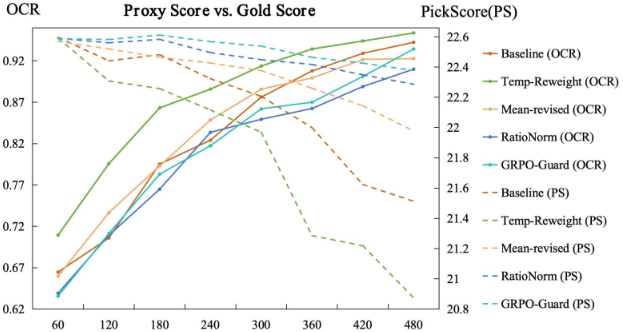
다음은 ablation study 결과이다.
3. Human Evaluation
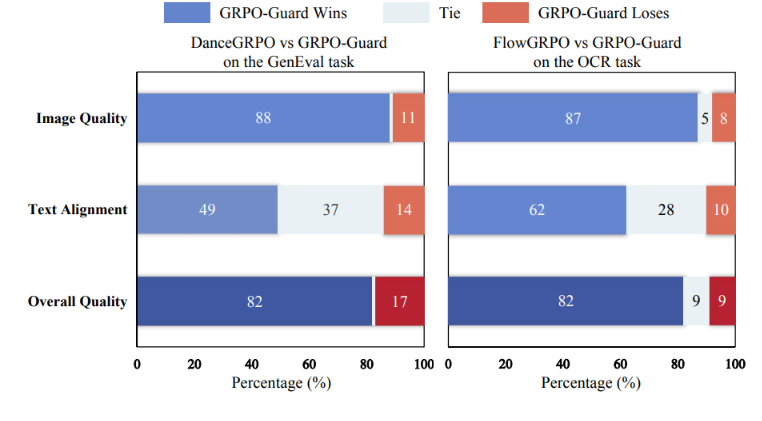
다음은 인간 선호도 평가 결과이다.