[논문리뷰] Training Diffusion Models with Reinforcement Learning
ICLR 2024. [Paper] [Page] [Github]
Kevin Black, Michael Janner, Yilun Du, Ilya Kostrikov, Sergey Levine
UC Berkeley | MIT
22 May 2023
Introduction
Diffusion model의 대부분의 활용 사례는 likelihood 자체보다는 인간이 인지하는 이미지 품질과 같은 downstream task를 달성하는 데 초점을 맞추고 있다. 본 논문에서는 데이터 분포를 단순히 모사하는 대신, 이러한 목적을 직접적으로 충족하도록 diffusion model을 학습시키는 문제를 다룬다.
Diffusion model을 이용한 정확한 likelihood 계산은 계산적으로 불가능하여 기존의 많은 RL 알고리즘을 적용하기 어렵다. 이에 대한 대안으로, 저자들은 전체 denoising process에서 유도된 근사 likelihood 대신 각 denoising step에서의 정확한 likelihood를 활용하여 denoising process를 다단계 의사결정 문제로 재구성하는 방안을 제안하였다. 또한, black-box reward function만을 사용하여 downstream task를 위해 diffusion model을 최적화할 수 있는 policy gradient 알고리즘인 denoising diffusion policy optimization (DDPO)를 제시하였다.
저자들은 대규모 text-to-image diffusion model의 fine-tuning에 DDPO를 적용하였다. 초기 평가에서는 프롬프트만으로는 명시하기 어려운 task (ex. 이미지 압축성)이나 인간의 피드백을 통해 도출되는 task (ex. 미적 품질)에 초점을 맞추었다. 그러나 관심 대상이 되는 많은 reward function은 프로그래밍 방식으로 정의하기 어렵기 때문에, fine-tuning 과정에서 reward 신호를 얻기 위해 대규모 인간 라벨링 작업에 의존하는 경우가 많다. 저자들은 이러한 인간 라벨링 작업을 VLM으로부터 얻은 피드백으로 대체하는 방법을 제안하였다.
Reinforcement Learning Training of Diffusion Models
1. Problem Statement
사전 학습되었거나 랜덤하게 초기화될 수 있는, 기존의 diffusion model을 가정한다. 샘플러가 고정되어 있다고 가정할 때, 이 diffusion model은 샘플 분포 \(p_\theta (\textbf{x}_0 \mid \textbf{c})\)를 유도한다. 선택한 특정 컨텍스트 분포 $p(\textbf{c})$에 대해, denoising diffusion RL의 목적은 샘플과 컨텍스트를 기반으로 정의된 reward 신호 $r$을 최대화하는 것이다.
\[\begin{equation} \mathcal{J}_\textrm{DDRL} = \mathbb{E}_{\textbf{c} \sim p(\textbf{c}), \textbf{x}_0 \sim p_\theta (\textbf{x}_0 \mid \textbf{c})} [r (\textbf{x}_0, \textbf{c})] \end{equation}\]2. Reward-Weighted Regression
표준 diffusion model 학습에 최소한의 변경만을 가하여 \(\mathcal{J}_\textrm{DDRL}\)을 최적화하기 위해, denoising loss \(\mathcal{L}_\textrm{DDPM}\)을 사용할 수 있다.
\[\begin{equation} \mathcal{L}_\textrm{DDPM} (\theta) = \mathbb{E}_{(\textbf{x}_0, \textbf{c}) \sim p(\textbf{x}_0, \textbf{c}), t \sim \mathcal{U}\{0, T\}, \textbf{x}_t \sim q (\textbf{x}_t \vert \textbf{x}_0)} \left[ \| \tilde{\boldsymbol{\mu}} (\textbf{x}_0, t) - \boldsymbol{\mu}_\theta (\textbf{x}_t, \textbf{c}, t) \|^2 \right] \end{equation}\]이때 학습 데이터는 \(\textbf{x}_0 \sim p_\theta (\textbf{x}_0 \mid \textbf{c})\)를 따르도록 구성하며, reward \(r(\textbf{x}_0, \textbf{c})\)에 따른 가중치를 추가한다. 일반적으로 이러한 접근 방식은 샘플링과 학습을 번갈아 수행하는 과정을 여러 라운드에 걸쳐 반복함으로써 online RL 방법으로 확장될 수 있다. 이러한 일반적인 알고리즘을 reward-weighted regression (RWR)이라고 부른다.
표준 가중치 체계는 가중치가 음수가 되지 않도록 reward에 지수 함수를 적용한다.
\[\begin{equation} w_\textrm{RWR} (\textbf{x}_0, \textbf{c}) = \frac{1}{Z} \exp \left( \beta r (\textbf{x}_0, \textbf{c}) \right) \end{equation}\]($\beta$는 inverse temperature, $Z$는 정규화 상수)
또한 바이너리 가중치를 사용하는 간소화된 가중치 체계도 고려할 수 있다.
\[\begin{equation} w_\textrm{sparse} (\textbf{x}_0, \textbf{c}) = \unicode{x1D7D9} [r (\textbf{x}_0, \textbf{c}) \ge C] \end{equation}\]($C$는 reward threshold)
Supervised learning의 관점에서 볼 때, 이는 모델에서 생성된 학습 데이터에 대해 필터링을 거친 fine-tuning을 반복적으로 수행하는 것과 동일하다.
RL에서 RWR 절차는 다음과 같은 1-step MDP에 대응한다.
\[\begin{equation} \textbf{s} = \textbf{c}, \quad \textbf{a} = \textbf{x}_0, \quad \pi (\textbf{a} \mid \textbf{s}) = p_\theta (\textbf{x}_0 \mid \textbf{c}), \\ \rho_0 (\textbf{s}) = p (\textbf{c}), \quad R(\textbf{s}, \textbf{a}) = r (\textbf{x}_0, \textbf{c}) \end{equation}\]Transition kernel $P$는 즉시 종료 state로 이어진다. 따라서, \(\mathcal{J}_\textrm{DDRL} (\theta)\)를 최대화하는 것은 해당 MDP에서 RL objective \(\mathcal{J}_\textrm{RL} (\pi)\)를 최대화하는 것과 동일하다.
Log-likelihood objective에 \(w_\textrm{RWR}\)을 가중치로 부여하는 것은 policy $\pi$에 대한 KL divergence 제약 조건 하에서 \(\mathcal{J}_\textrm{RL} (\pi)\)를 근사적으로 최대화하는 것으로 알려져 있다. 그러나 \(\mathcal{L}_\textrm{DDPM}\)은 정확한 log-likelihood를 포함하지 않으며, 대신 \(\log p_\theta (\textbf{x}_0 \mid \textbf{c})\)에 대한 variational bound로서 유도된다. 따라서 diffusion model 학습에 RWR 절차를 적용하는 것은 이론적 근거가 부족하며, \(\mathcal{J}_\textrm{DDRL}\)을 매우 대략적인 근사치 수준에서만 최적화할 뿐이다.
3. Denoising Diffusion Policy Optimization
RWR은 denoising process의 순차적 특성을 무시하고 최종 샘플인 \(\textbf{x}_0\)만을 사용하기 때문에, 근사적인 log-likelihood에 의존한다. 본 논문에서는 denoising process를 multi-step MDP로 재구성하였으며, policy gradient estimator를 통해 \(\mathcal{J}_\textrm{DDRL}\)을 직접 최적화할 수 있다. 저자들은 임의의 downstream objective를 최적화하고자 하였기 때문에, 임의의 reward function을 허용하는 일반적인 프레임워크를 제시하였다. 이러한 알고리즘을 Denoising Diffusion Policy Optimization (DDPO)라 부르며, 저자들은 특정 gradient estimator를 기반으로 하는 두 가지 변형을 제안하였다.
Multi-step MDP로서의 denoising
반복적인 denoising process를 다음과 같은 MDP로 매핑한다.
\[\begin{equation} \textbf{s}_t = (\textbf{c}, t, \textbf{x}_t), \quad \pi (\textbf{a}_t \mid \textbf{s}_t) = p_\theta (\textbf{x}_{t-1} \mid \textbf{x}_t, \textbf{c}), \quad P(\textbf{s}_{t+1} \mid \textbf{s}_t, \textbf{a}_t) = (\delta_{\textbf{c}}, \delta_{t-1}, \delta_{\textbf{x}_{t-1}}) \\ \textbf{a}_t = \textbf{x}_{t-1}, \quad R(\textbf{s}_t, \textbf{a}_t) = \begin{cases} r (\textbf{x}_0, \textbf{c}) & \textrm{if} \; t = 0 \\ 0 & \textrm{otherwise} \end{cases}, \quad \rho_0 (\textbf{s}_0) = (p (\textbf{c}), \delta_T, \mathcal{N}(\textbf{0}, \textbf{I})) \end{equation}\](\(\delta_y\)는 $y$에서만 0이 아닌 density를 갖는 디랙 델타 분포)
궤적은 $T$개의 timestep으로 구성되며, 그 이후 종료 state에 도달하게 된다. 각 궤적의 누적 reward는 \(r (\textbf{x}_0, \textbf{c})\)와 같으므로, \(\mathcal{J}_\textrm{DDRL} (\theta)\)를 최대화하는 것은 이 MDP에서 \(\mathcal{J}_\textrm{RL} (\pi)\)를 최대화하는 것과 동일하다.
이러한 formulation의 장점은, \(p_\theta (\textbf{x}_{t-1} \mid \textbf{x}_t, \textbf{c})\)를 사용하는 표준 샘플러를 적용할 경우, policy $\pi$가 isotropic Gaussian 분포가 된다는 점이다. 이는 RWR에서 policy $\pi$가 매우 복잡하고 임의적인 분포인 \(p_\theta(\textbf{x}_0 \mid \textbf{c})\)로 나타나는 것과는 대조적이다. 이러한 단순화 덕분에 정확한 log-likelihood를 계산할 수 있으며, diffusion model의 파라미터에 대한 log-likelihood의 gradient 또한 구할 수 있게 된다.
Policy gradient 추정
Likelihood와 likelihood gradient를 활용하면 \(\nabla_\theta \mathcal{J}_\textrm{DDRL}\)에 대한 직접적인 몬테카를로 추정치를 구할 수 있다. RWR과 마찬가지로, DDPO는 샘플링을 통해 denoising 궤적들 \(\{\textbf{x}_T, \textbf{x}_{T-1}, \ldots, \textbf{x}_0\}\)을 수집하는 과정과 gradient descent를 통해 파라미터를 업데이트하는 과정을 번갈아 수행한다.
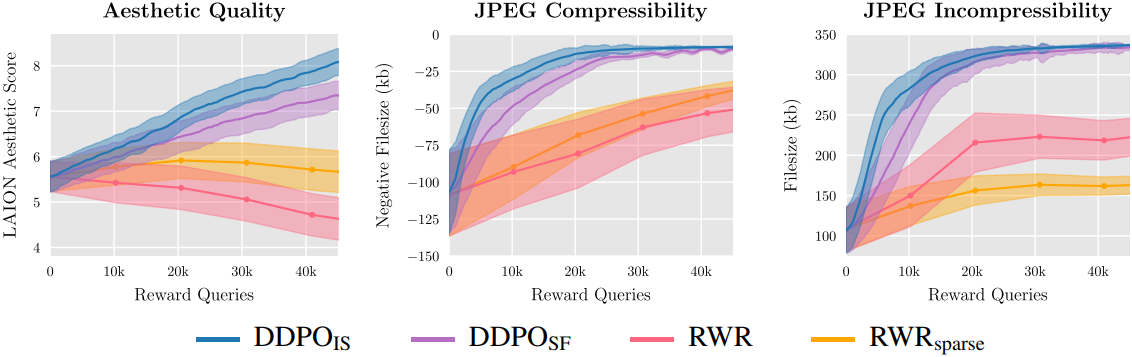
DDPO의 첫 번째 변형인 DDPOSF는 score function policy gradient estimator를 사용하는데, 이는 likelihood ratio method 또는 REINFORCE라고도 불린다.
\[\begin{equation} \nabla_\theta \mathcal{J}_\textrm{DDRL} = \mathbb{E} \left[ \sum_{t=0}^T \nabla_\theta \log p_\theta (\textbf{x}_{t-1} \mid \textbf{x}_t, \textbf{c}) \, r (\textbf{x}_0, \textbf{c}) \right] \end{equation}\]여기서 기댓값은 현재 파라미터 $\theta$에 의해 생성된 denoising 궤적들을 대상으로 계산된다.
하지만 이 추정량은 데이터 수집 라운드당 단 한 번의 최적화 step만 수행할 수 있는데, 이는 현재 파라미터로 생성된 데이터를 사용하여 gradient를 계산해야 하기 때문이다. DDPO의 두 번째 변형인 DDPOIS는 여러 번의 최적화 step을 수행하기 위해 importance sampling 추정량을 사용한다.
\[\begin{equation} \nabla_\theta \mathcal{J}_\textrm{DDRL} = \mathbb{E} \left[ \sum_{t=0}^T \frac{p_\theta (\textbf{x}_{t-1} \mid \textbf{x}_t, \textbf{c})}{p_{\theta_\textrm{old}} (\textbf{x}_{t-1} \mid \textbf{x}_t, \textbf{c})} \nabla_\theta \log p_\theta (\textbf{x}_{t-1} \mid \textbf{x}_t, \textbf{c}) \, r (\textbf{x}_0, \textbf{c}) \right] \end{equation}\]여기서 기댓값은 파라미터 \(\theta_\textrm{old}\)에 의해 생성된 denoising 궤적에 대해 계산된다. \(p_\theta\)가 \(p_{\theta_\textrm{old}}\)에서 너무 멀리 벗어나면 정확도가 떨어지기 때문에, PPO에서처럼 clipping을 통해 신뢰 영역을 구현하고 업데이트 크기를 제한함으로써 해결한다.
Reward Functions for Text-to-Image Diffusion
본 논문에서는 text-to-image diffusion model을 대상으로 DDPO를 평가하였다. Text-to-image diffusion은 대규모 사전 학습 모델을 활용할 수 있고, 다양하면서도 시각적으로 흥미로운 reward function을 폭넓게 적용할 수 있다는 점에서 RL을 위한 유용한 테스트 환경이다.
1. Compressibility and Incompressibility
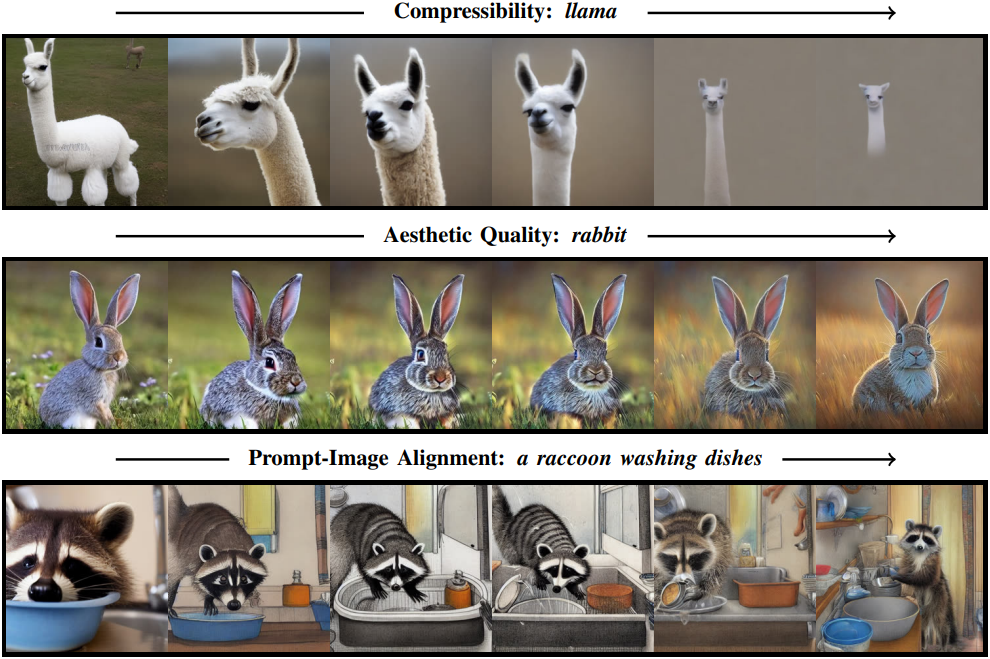
Text-to-image diffusion model의 능력은 학습 데이터 분포 내에 존재하는 텍스트와 이미지의 동시 출현 빈도에 의해 제한된다. 예를 들어, 이미지에 파일 크기가 캡션으로 포함되는 경우는 거의 없기 때문에, 프롬프트를 통해 원하는 파일 크기를 지정하는 것은 불가능하다. 이러한 제약으로 인해 파일 크기를 기준으로 하는 reward function은 적절한 연구 대상이다. 계산은 간단하지만, 기존의 likelihood 최대화나 프롬프트 엔지니어링 같은 방식으로는 제어할 수 없기 때문이다.
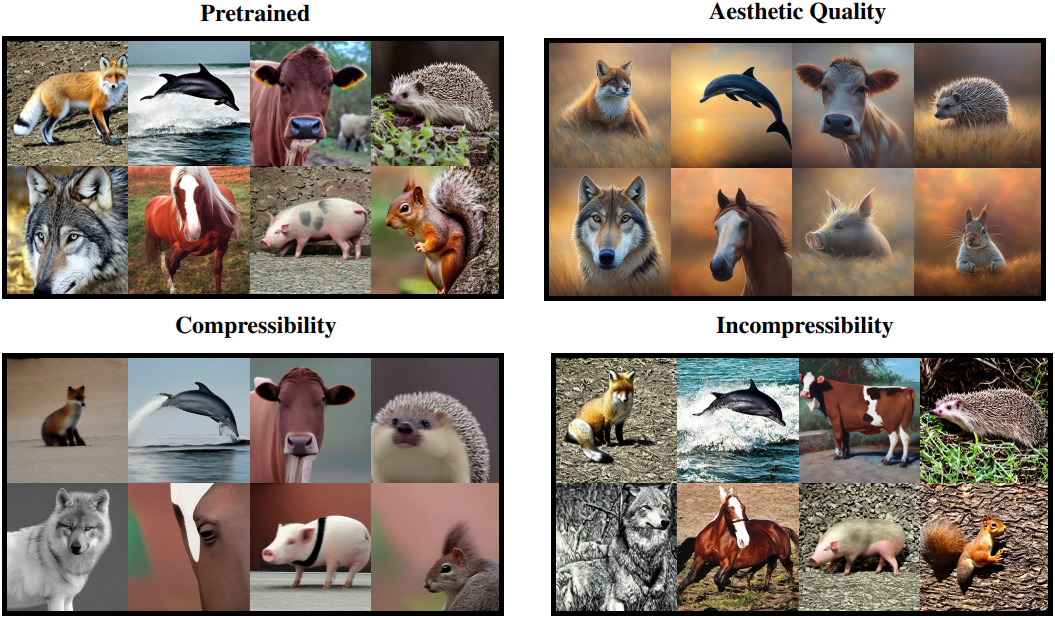
저자들은 샘플의 해상도를 512$\times$512로 고정하여, 파일 크기가 오직 이미지의 압축 가능성에 의해서만 결정되도록 했다. 구체적으로, JPEG 압축 후의 이미지 파일 크기를 최소화하는 compressibility task와, 반대로 최대화하는 incompressibility task를 정의했다.
2. Aesthetic Quality
사용자에게 유용한 reward function을 얻기 위해, 저자들은 미적 품질을 기반으로 하는 task를 정의하였다. 이를 위해 17만 6천 개의 인간 이미지 평가 데이터를 바탕으로 학습된 LAION aesthetics predictor를 사용하였다. 이 predictor는 CLIP 임베딩을 입력으로 하는 선형 모델 형태로 구현되어 있다. 평가 점수는 1점에서 10점까지이며, 가장 높은 점수를 받은 이미지들에는 주로 예술 작품이 포함되어 있다.
3. Automated Prompt Alignment with Vision-Language Models
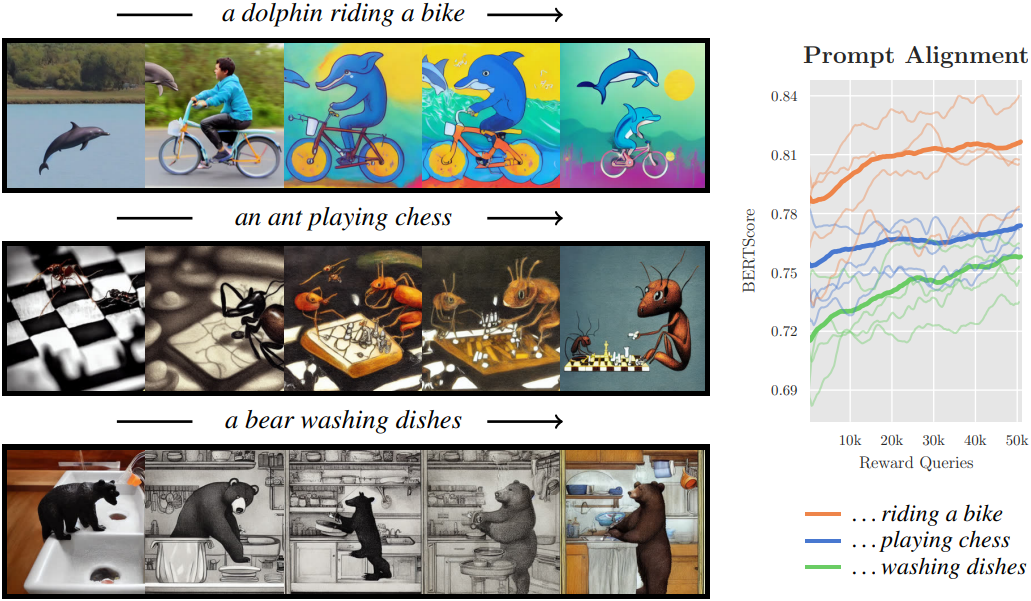
Text-to-image 생성 모델을 학습시킬 때 매우 범용적으로 활용할 수 있는 reward function은 프롬프트 정렬이다. 하지만 프롬프트와 이미지의 일반적인 정렬 상태를 포착하는 reward를 구체적으로 정의하기란 어려우며, 기존에는 대규모의 인간 라벨링 작업에 의존했다. 본 논문에서는 인간의 라벨링 작업 대신, 기존의 VLM을 활용하는 방식을 제안하였다.
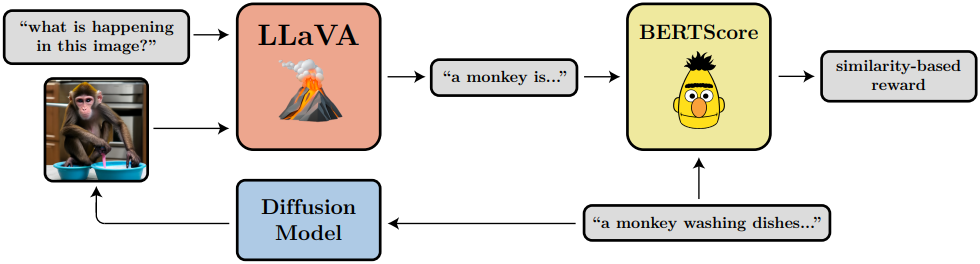
저자들은 LLaVA를 사용하여 이미지를 설명하도록 하였다. 이때 fine-tuning을 위한 reward로는 의미적 유사성을 측정하는 BERTScore recall을 사용하며, 프롬프트를 기준 문장으로, VLM이 생성한 설명을 후보 문장으로 활용한다. 프롬프트에 담긴 디테일을 더 충실하게 포함하고 있는 샘플일수록 더 높은 reward를 받게 된다.
Experiments
1. Algorithm Comparisons
다음은 DDPO 샘플들이다.
다음은 RL 알고리즘에 따른 fine-tuning 효과를 비교한 그래프이다.
2. Automated Prompt Alignment
다음은 프롬프트 정렬 결과이다.
3. Generalization
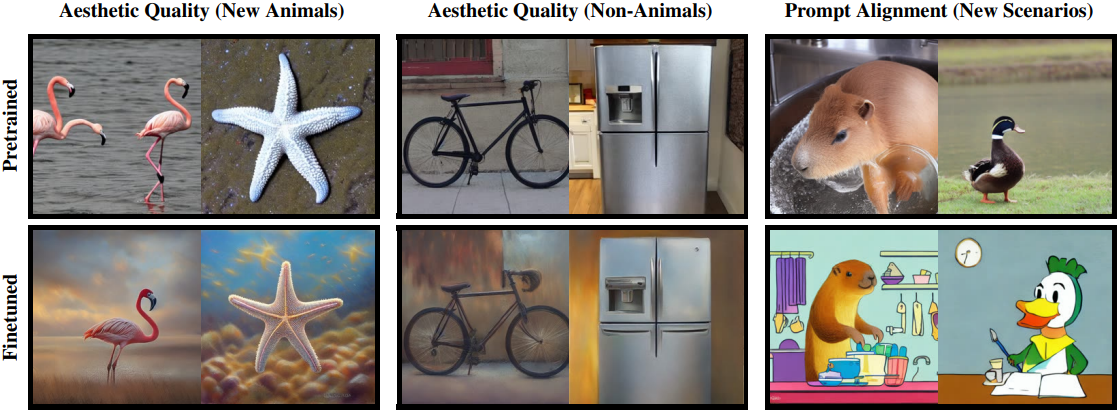
다음은 제한된 동물 데이터셋으로 fine-tuning한 후, 새로운 동물과 일상적인 사물들에 대해 생성한 결과이다.