[논문리뷰] Text-Conditional JEPA for Learning Semantically Rich Visual Representations
ICML 2026. [Paper]
Chen Huang, Xianhang Li, Vimal Thilak, Etai Littwin, Josh Susskind
Apple
5 May 2026
Introduction
이미지 기반 Self-Supervised Learning (SSL) 분야는 크게 두 가지 접근 방식의 발전과 함께 상당한 진전을 이루었다. Invariance 기반 방법론은 augmentation된 이미지 뷰 간의 불변성을 학습함으로써 고수준의 semantic 표현을 생성한다. 그러나 특정 이미지 augmentation 기법은 서로 다른 불변성을 요구하는 downstream task에서의 일반화 성능을 저하시킬 수도 있다. 반면, Masked Image Modeling (MIM) 방식은 사전 지식에 대한 의존도가 낮으며, pixel space 또는 latent space에서 마스킹된 이미지 패치를 복원하는 과정을 통해 시각적 표현을 학습한다. MIM은 통상적으로 로컬 구조를 중시하는 패치 단위의 feature를 학습하는데, I-JEPA와 같은 latent space 기반 MIM 방식은 로컬 정보와 semantic 정보를 모두 포착할 수 있다는 장점 덕분에 최근 더욱 주목받고 있다.
JEPA의 핵심 과제인 컨텍스트 기반 feature 추출은 여전히 어려운 문제로 남아 있다. 즉, 임의의 마스킹된 위치에서 feature를 예측하는 것은 큰 불확실성을 수반한다. 이러한 내재적인 예측 불확실성 때문에 I-JEPA는 마스킹 전략에 민감하다. 컨텍스트와 마스킹된 부분 사이의 상호 정보가 너무 낮으면 feature 예측이 어려워지고, 유용한 semantic 정보를 인코딩하지 못한 채 표현이 붕괴될 수 있다.
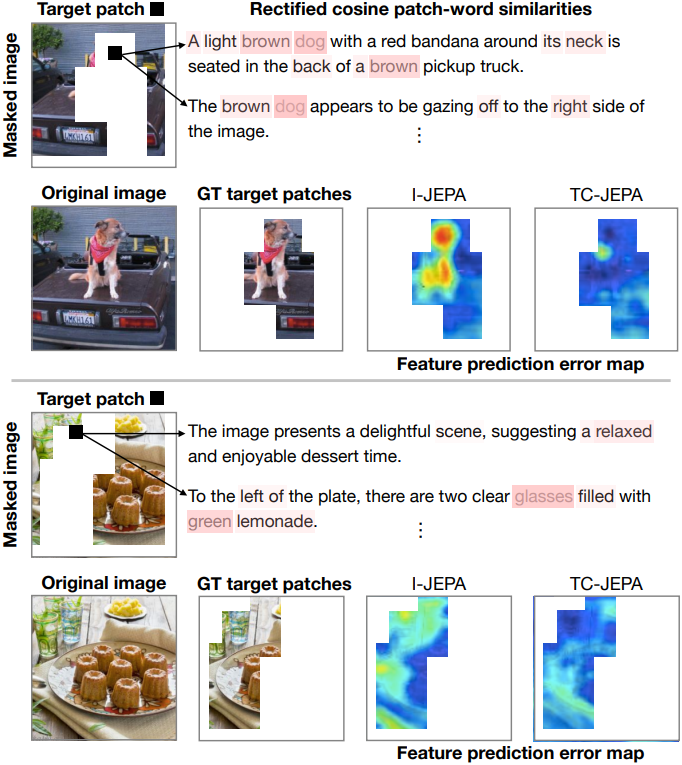
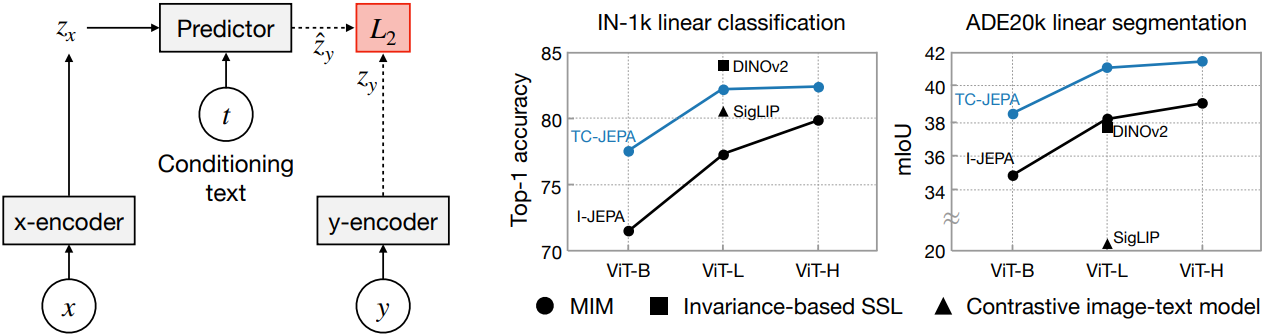
본 논문은 사람이나 LMM이 생성한 이미지 캡션을 활용하여 feature 예측을 보조하는 방식을 제안하였다. 이 캡션은 feature 사전 학습 단계에서만 필요하며, 테스트 시에는 사용되지 않는다. 직관적으로 볼 때, 장면 구성에 관한 캡션은 컨텍스트와 타겟 간의 공간적 관계를 드러낼 수 있다. 이러한 텍스트 정보를 활용해 feature predictor를 보강하면 feature 예측의 불확실성을 상당히 줄일 수 있다. 따라서 저자들은 JEPA의 예측 능력과 텍스트 조건부 입력을 결합한 Text-Conditional JEPA (TC-JEPA)를 제안하였으며, I-JEPA를 텍스트 조건부 표현 학습 모델로 발전시켰다. 이 모델에서 패치 표현은 텍스트에 의한 프롬프트가 주어질 때 예측하거나 변환할 수 있게 되며, 결과적으로 언어와 더 잘 정렬되고 semantic하게 더 유의미한 표현이 된다.
강력한 텍스트 컨디셔닝을 위해, 본 논문에서는 새로운 세밀한 텍스트 컨디셔닝 기법을 도입하였다. 구체적으로, 텍스트 토큰에 대한 cross-attention을 활용하여 예측 모델의 여러 layer에서 예측된 패치 feature를 변조한다. 이는 이미지 패치와 단어 토큰 간의 세밀한 대응 관계를 식별하는 데 도움을 주며, SSL 방식으로 최적화되어 feature 예측을 극대화한다. 또한, 저자들은 sparsity 및 consistency 제약 조건을 사용하여 패치-단어 유사도에 대한 유용한 정규화 기법을 제안하였다.
Method
1. I-JEPA Baseline
I-JEPA의 목표는 동일한 이미지 내의 컨텍스트 패치 \(x = \{x_i \mid i \in B_x\}\)가 주어졌을 때, 마스킹된 이미지 부분, 즉 타겟 패치 \(y = \{y_j \mid j \in B_y\}\)의 표현을 예측하는 것이다. 이때 서로 겹치지 않는 패치 $x$와 $y$를 생성하기 위해 multi-block masking 전략이 사용된다.
컨텍스트 및 타겟 인코딩
컨텍스트 패치 표현 \(z_{x} = \{z_{x_i}\}_{i \in B_x}\)는 ViT 인코더 $f_\theta$를 통해 추출된다. 여기서 각 $z_{x_i} \in \mathbb{R}^d$에는 위치 임베딩 $p_i \in \mathbb{R}^d$가 더해진다. GT 타겟 패치 feature $z_{y_j} = f_{\bar{\theta}} (y_j) \in \mathbb{R}^d$는 $f_\theta$의 EMA인 $f_{\bar{\theta}}$에 의해 처리된다.
타겟 예측
ViT로 구현된 predictor $g_\phi$를 통해 타겟 feature \(\hat{z}_y = \{\hat{z}_{y_j}\}_{j \in B_y}\)를 예측한다. 구체적으로, predictor는 모든 컨텍스트 feature $z_x$를 입력으로 받고 위치 마스크 토큰 시퀀스 \(m = \{m_j\}_{j \in B_y}\)를 조건으로 하여, 해당 마스크 토큰이 지정하는 패치 위치에서의 타겟 표현을 예측한다.
\[\begin{equation} \hat{z}_y = g_\phi (z_x, m) \end{equation}\]각 마스크 토큰 $m_j \in \mathbb{R}^d$는 $j$번째 타겟 패치의 위치 임베딩 $p_j$와 학습 가능한 공유 벡터 $\tilde{m}$의 합으로 정의된다.
Loss
인코더 $f_\theta$와 predictor $g_\phi$는 feature 예측 오차를 최소화하는 방식으로 동시에 학습된다.
\[\begin{equation} \mathcal{L}_\textrm{predict} = \frac{1}{\vert B_y \vert} \sum_{j \in B_y} \| \hat{z}_{y_j} - \textrm{sg} (f_{\bar{\theta}} (y_j)) \|_2 \end{equation}\]($\textrm{sg}$는 stop-gradient)
2. Text-Conditional JEPA
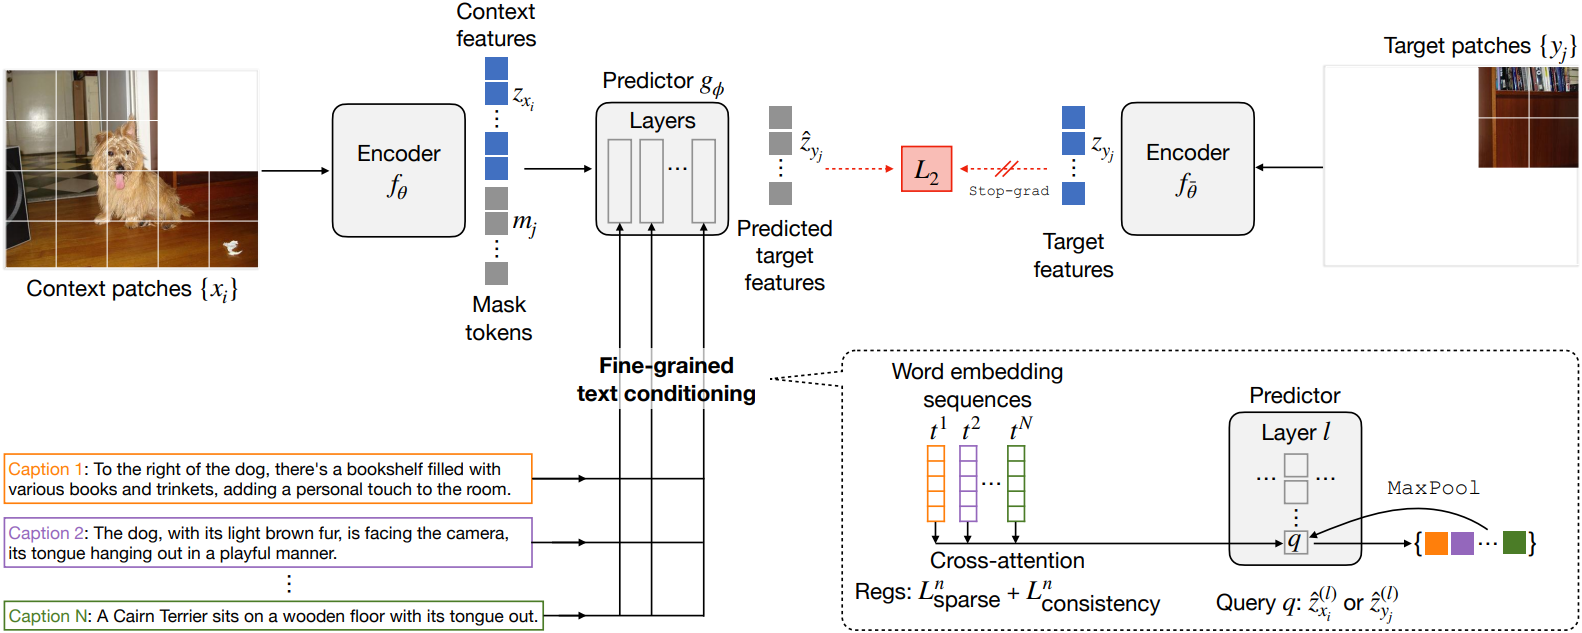
본 논문에서는 위치 마스크 토큰 외에도 이미지 캡션으로 predictor $g_\phi$를 컨디셔닝하여 JEPA 예측 정확도를 향상시키는 방법을 제안하였다. 이미지 캡션은 컨텍스트 패치와 타겟 패치 간의 상호 정보가 낮은 경우, 특히 장면 구성이나 물체 상호 작용에 대한 텍스트 설명을 활용할 때 유용하다.
입력 이미지와 연관된 텍스트 캡션 $c$가 주어지면, 먼저 사전 학습된 T5를 사용하여 $c$를 단어 임베딩 시퀀스 $t = [t_1, \ldots, t_S] \in \mathbb{R}^{d_t \times S}$로 매핑한다 ($S$는 시퀀스 길이). T5는 자연어 캡션의 구성 및 순서 정보를 더 잘 표현할 수 있기 때문에, CLIP의 텍스트 인코더 대신 언어 모델인 T5를 사용한다.
단순히 $t$를 $g_\phi$의 입력 시퀀스에 추가적인 토큰으로 덧붙이는 sequence conditioning은 predictor가 처리해야 할 시퀀스 길이를 증가시키며, 이에 따라 메모리 및 연산 측면에서 무시할 수 없는 오버헤드와 함께 추가적인 모델 용량이 요구된다. 게다가 이러한 컨디셔닝은 predictor의 입력 layer에서만 적용되므로, 더 깊은 layer로 갈수록 그 효과가 급격히 사라지게 된다.
단어 시퀀스에 대한 cross-attention
위의 단점을 해결하기 위해, 본 논문에서는 $g_\phi$의 여러 layer에서 단어 시퀀스에 대한 cross-attention을 사용하여 predictor $g_\phi$를 컨디셔닝하는 것을 제안하였다. Query $q \in \mathbb{R}^d$를 $g_\phi$의 $l \in [1, L]$번째 layer에서 예측된 각 패치 feature라 하자. 즉, \(q \in \{\hat{z}_x^{(l)}, \hat{z}_y^{(l)}\}\)이다. 그러면 $q$는 단어 임베딩 시퀀스 $t$에 cross-attention을 적용하여 다음과 같은 결과를 얻는다.
\[\begin{equation} q^{(l)} = W_Q^{(l)} \cdot q, \quad K^{(l)} = W_K^{(l)} \cdot t, \quad V^{(l)} = W_V^{(l)} \cdot t \\ \textrm{Attention} (q^{(l)}, K^{(l)}, V^{(l)}) = \sum_{s=1}^S \textrm{softmax} \left( q^{(l) \top} \cdot K_{:,s}^{(l)} \right) \cdot V_{:,s}^{(l)} \\ q \leftarrow q + \textrm{Attention} (q^{(l)}, K^{(l)}, V^{(l)}) \end{equation}\](\(W_Q^{(l)} \in \mathbb{R}^{d \times d}\), \(W_K^{(l)} \in \mathbb{R}^{d \times d_t}\), \(W_V^{(l)} \in \mathbb{R}^{d \times d_t}\)는 layer $l$에서의 학습 가능한 query, key, value 행렬)
각 cross-attention layer는 residual 구조를 가지며, 그 출력은 $q$에 다시 더해진 뒤 MLP 네트워크와 LayerNorm을 거친다.
이러한 방식으로 predictor $g_\phi (z_x, m, t)$는 패치별로 컨디셔닝된다. 텍스트 $t$는 각 컨텍스트 패치 \(\hat{z}_{x_i}^{(l)}\) 또는 타겟 패치 \(\hat{z}_{y_j}^{(l)}\)에 대해 예측된 feature를 개별적으로 업데이트한다. 이러한 attention 방식의 텍스트 컨디셔닝은 모든 패치에 대해 $t$에서 단어 토큰을 선택적으로 사용할 수 있도록 한다.
학습 과정을 더욱 개선하기 위해, 저자들은 패치-단어 코사인 유사도 \(O_i^{(l)} = \max (\cos (q^{(l)}, K^{(l)}), 0) \in \mathbb{R}^S\)가 양수일 때, 즉 semantic하게 관련된 패치-단어 쌍 사이의 값일 때 이를 정규화한다. 그런 다음, 관련 단어에 대한 패치 feature의 선택성을 극대화하기 위해 $O_i^{(l)}$에 sparsity 제약을 부과한다. 또한 각 패치에 대해 layer 간 유사한 단어 선택 결과를 얻기 위해 $O_i^{(l)}$의 layer 간 일관성을 강제한다. 이를 위해 $O_i^{(l)}$와 layer 간 평균 \(\bar{O}_i = \frac{1}{L} \sum_{l=1}^L O_i^{(l)}\) 사이의 편차에 페널티를 부여한다.
\[\begin{aligned} \mathcal{L}_\textrm{sparse} &= \frac{1}{\vert B_x \vert + \vert B_y \vert} \sum_{i \in \{B_x, B_y\}} \frac{1}{L} \sum_{l=1}^L \| O_i^{(l)} \|_1 \\ \mathcal{L}_\textrm{consistency} &= \frac{1}{\vert B_x \vert + \vert B_y \vert} \sum_{i \in \{B_x, B_y\}} \frac{1}{L} \sum_{l=1}^L \| O_i^{(l)} - \bar{O}_i \|_1 \\ \mathcal{L} &= \mathcal{L}_\textrm{predict} + \lambda \mathcal{L}_\textrm{sparse} + \beta \mathcal{L}_\textrm{consistency} \end{aligned}\]여러 캡션을 컨디셔닝
이미지를 설명하는 여러 텍스트 캡션 \(\{c_n\}_{n \in [1, N]}\)을 활용할 수 있는 경우, 이는 시각적 콘텐츠의 풍부한 정보를 더 잘 포착할 수 있게 해주며, 더 많은 텍스트 정보를 통해 컨디셔닝 효과를 한층 더 향상시킬 수 있다. 하나의 텍스트 캡션만 사용하는 것과 비교할 때, 여러 캡션을 사용하면 배경 요소나 배경과 전경 간의 공간적 관계를 포괄할 가능성이 높아지며, 이는 결과적으로 feature 예측을 더 효과적으로 유도할 수 있다.
본 논문에서는 각 캡션 $c_n$을 사용하여 $g_\phi$를 독립적으로 컨디셔닝한 후, feature level에서의 융합 전략을 적용하였다. $t_n$을 $c_n$에 해당하는 단어 시퀀스라고 할 때, $g_\phi$의 $l$번째 layer에 있는 query 패치 feature $q$는 각 $t_n$과 cross-attention을 수행한다. 그 후, $l$번째 layer의 컨디셔닝된 feature 집합 \(\{\hat{z}_{y_{j,n}}^{(l)}\}\) 또는 \(\{\hat{z}_{x_{i,n}}^{(l)}\}\)에 대해 $n$ 차원을 따라 max-pooling을 수행함으로써 $N$개의 캡션에서 가장 유용한 텍스트 정보를 융합한다. 이렇게 얻어진 pooling 결과 \(\hat{z}_{y_j}^{(l)}\) 또는 \(\hat{z}_{x_i}^{(l)}\)는 다음 layer의 입력으로 전달된다.
또한, $l$번째 layer에서 $i$번째 패치를 모든 $n$번째 캡션으로 컨디셔닝할 때 패치-단어 유사도 \(\{O_{i,n}^{(l)}\}\)를 정규화한다. 전체 학습 loss는 다음과 같이 정의된다.
\[\begin{equation} \mathcal{L} = \mathcal{L}_\textrm{predict} + \frac{\lambda}{N} \sum_{n=1}^N \mathcal{L}_\textrm{sparse}^n + \frac{\beta}{N} \sum_{n=1}^N \mathcal{L}_\textrm{consistency}^n \end{equation}\]Experiments
1. Evaluating ImageNet Pretraining
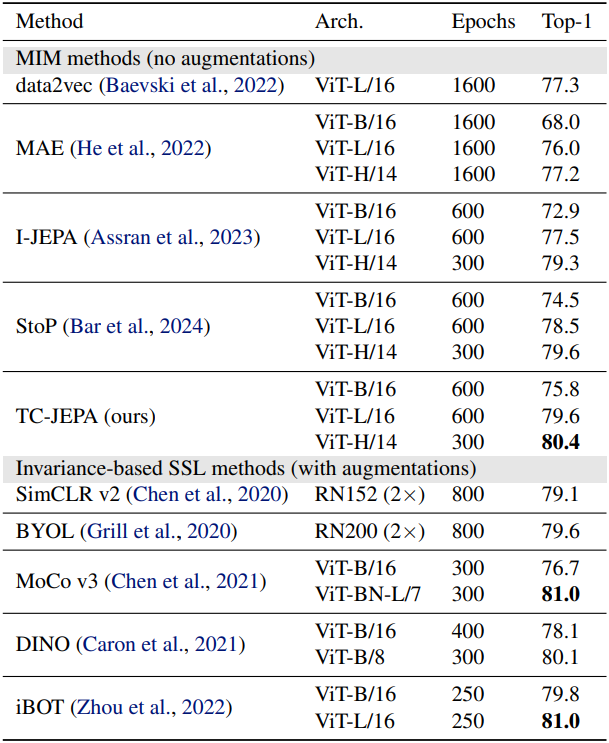
다음은 ImageNet-1K에 대한 linear probing 결과이다. (ImageNet-1K로 사전 학습)
다음은 다른 classification 및 dense task에 대한 성능 비교 결과이다. (ImageNet-1K로 사전 학습)
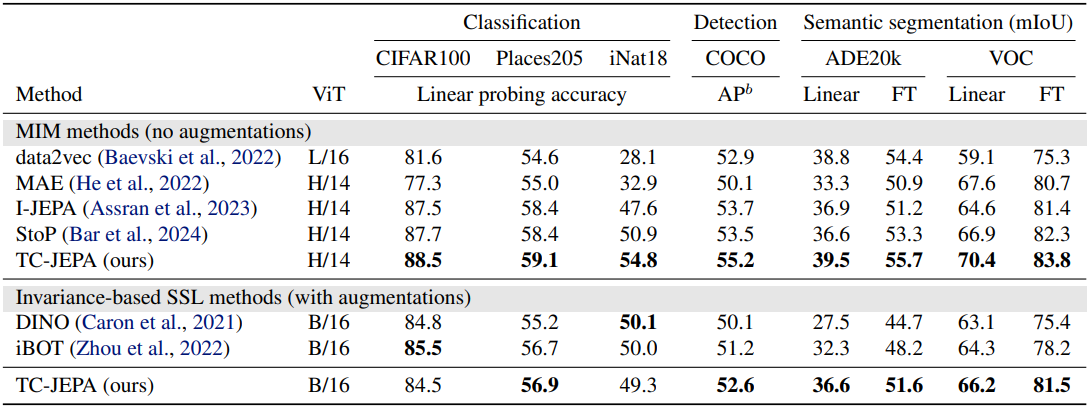
다음은 ImageNet-21K로 사전 학습 데이터를 scaling한 결과이다.
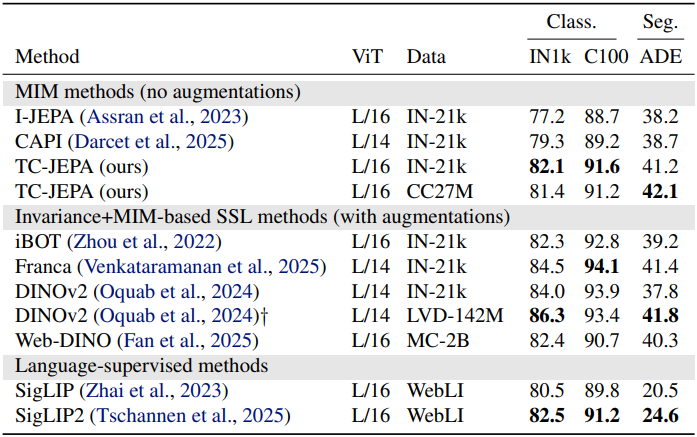
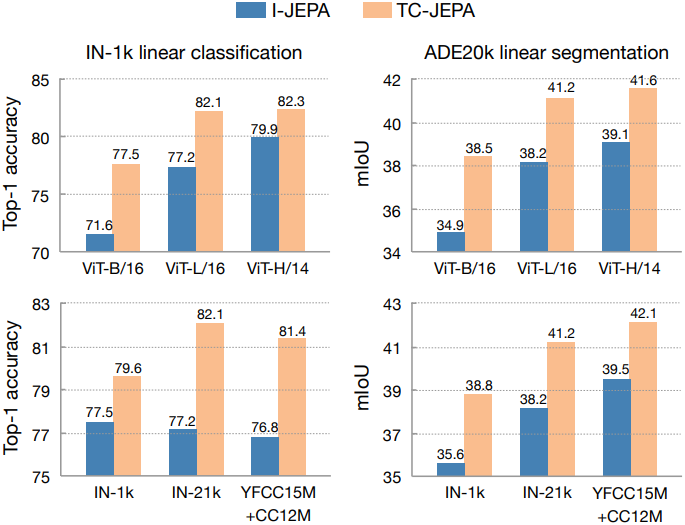
다음은 모델 크기와 학습 데이터 크기에 대한 scaling 결과이다.
2. Evaluating Pretraining with Image-Text Datasets
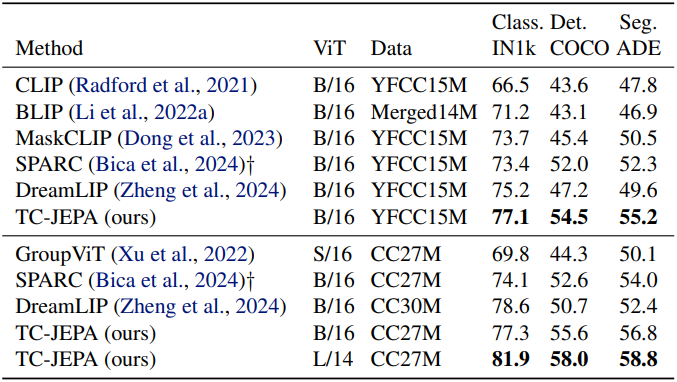
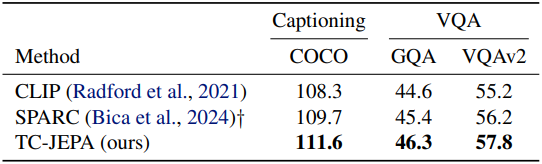
다음은 contrastive learning 기반 방법과 비교한 결과들이다.
3. Analysis
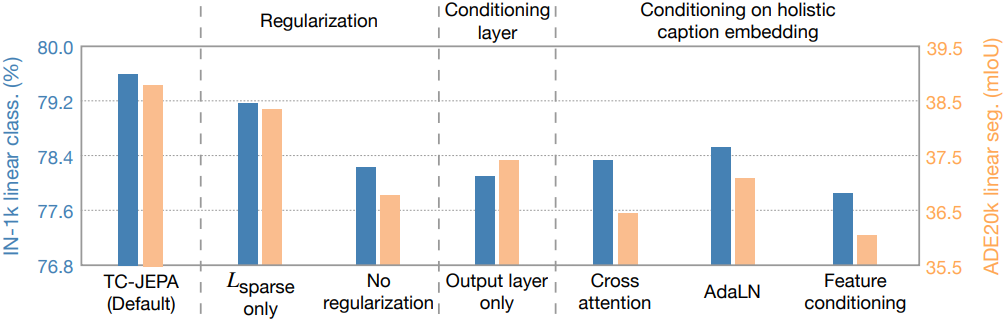
다음은 텍스트 컨디셔닝 방법의 주요 구성요소에 대한 ablation 결과이다.
다음은 feature 예측을 시각화한 예시들이다.