[논문리뷰] InfiniCube: Unbounded and Controllable Dynamic 3D Driving Scene Generation with World-Guided Video Models
ICCV 2025. [Paper] [Page] [Github]
Yifan Lu, Xuanchi Ren, Jiawei Yang, Tianchang Shen, Zhangjie Wu, Jun Gao, Yue Wang, Siheng Chen, Mike Chen, Sanja Fidler, Jiahui Huang
NVIDIA | Shanghai Jiao Tong University | University of Toronto | Vector Institute | University of Southern California
5 Dec 2024
Introduction
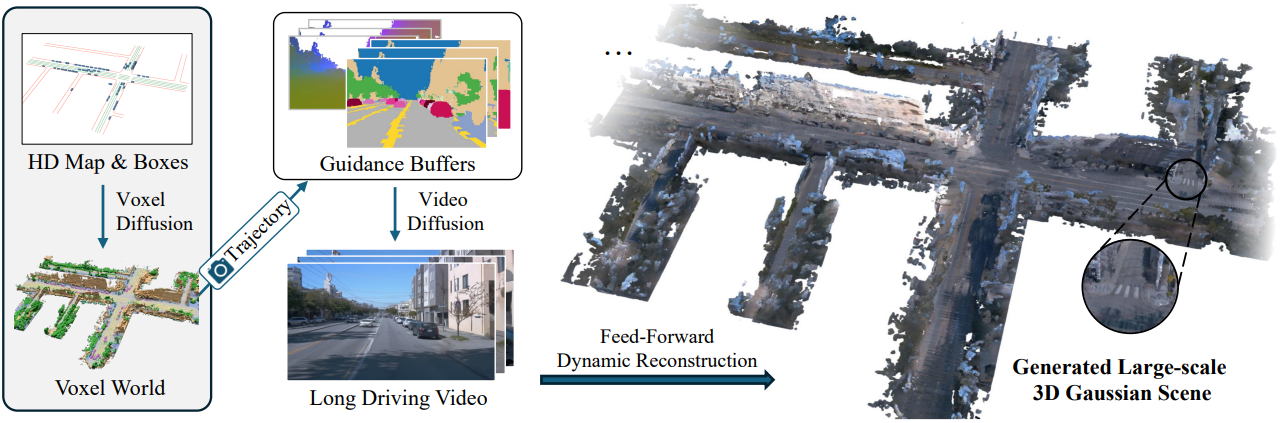
본 논문에서는 대규모 3D 주행 장면 생성을 위해 3D Gaussian 장면을 생성하는 새롭고 scalable한 기법인 InfiniCube를 제안하였다. 구체적으로, 먼저 map 정보를 기반으로 하는 3D voxel 생성 모델을 구축하고, outpainting을 통해 공간적 제약이 없는 voxel world를 생성한다. 생성된 voxel world는 이후 일련의 guidance buffer로 렌더링되어, 동영상 diffusion model을 활용한 외형 합성 및 긴 동영상 생성을 지원한다. 또한, 동적 차량에 대한 제어 가능성을 유지하면서 동영상과 voxel 데이터를 동적 3D Gaussian으로 lifting하는 빠르고 robust한 기법을 제안하였다. InfiniCube는 긴 동영상 생성이 가능할 뿐만 아니라 최대 약 300m$\times$400m 규모의 대형 동적 3D 장면으로 scaling할 수 있다.
Method
1. Unbounded Voxel World Generation
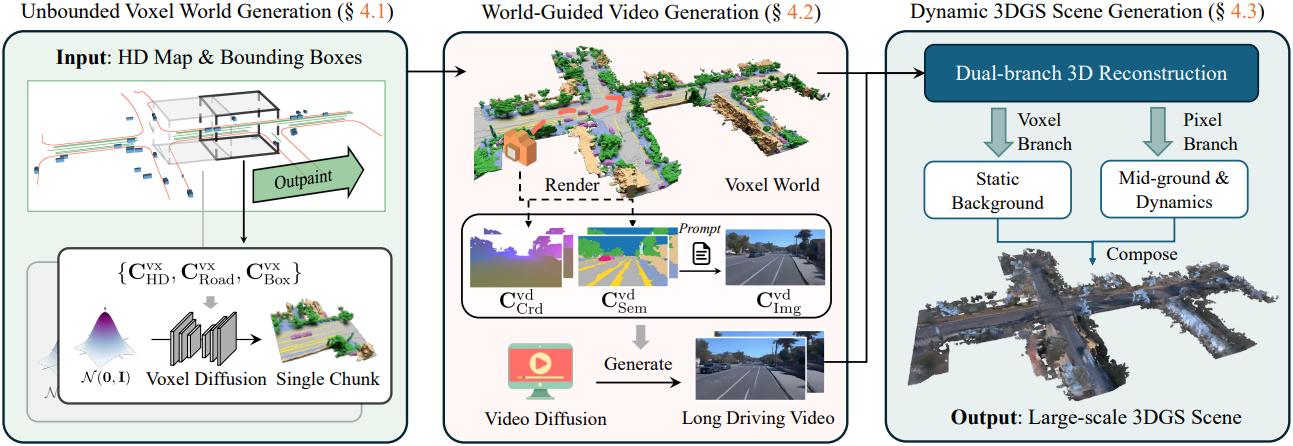
이 단계는 HD map과 차량 bounding box를 입력으로 받아, semantic label이 포함된 3D voxel world를 합성한다. 이를 위해, 본 논문에서는 XCube를 기반으로 한 sparse voxel LDM을 개발하되, outpainting 기법을 적용하여 공간적 제약이 없는 voxel 장면 생성으로 이를 확장하였다.
InfiniCube는 각 voxel이 semantic label을 갖고 있는 sparse voxel grid $\textbf{D}^\textrm{vx}$를 사용한다. XCube는 $\textbf{D}^\textrm{vx}$를 효율적으로 dense latent feature cube \(\textbf{X}^\textrm{vx} = \mathcal{E}^\textrm{vx} (\textbf{D}^\textrm{vx}) \in \mathbb{R}^{N^3 \times C}\)로 인코딩하며, 다시 높은 충실도로 디코딩할 수 있다.
Condition volume 구축
입력 데이터를 바탕으로, 먼저 $\textbf{X}^\textrm{vx}$와 동일한 구조를 갖는 condition volume \(\textbf{C}^\textrm{vx} \in \mathbb{R}^{N^3 \times 4}\)를 생성한다. 이 볼륨은 다음 세 가지 구성요소를 포함한다.
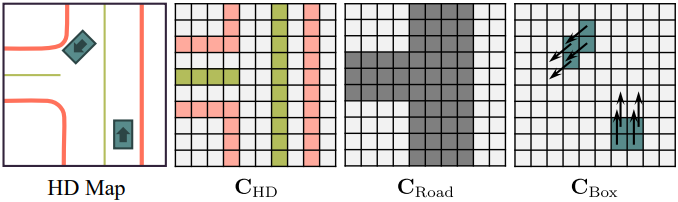
- HD map 조건 \(\textbf{C}_\textrm{HD}^\textrm{vx}\): 입력 HD map은 도로 경계를 정의하는 road edge와 차선을 구분하는 road line이라는 두 가지 3D polyline 세트로 구성된다. 이 polyline들을 조건 \(\textbf{C}_\textrm{HD} \in \mathbb{R}^{N^3 \times 2}\)의 두 개별 채널로 rasterize하는데, 이때 voxel의 일부라도 polyline과 교차하면 voxel 값을 1로, 그렇지 않으면 0으로 설정한다.
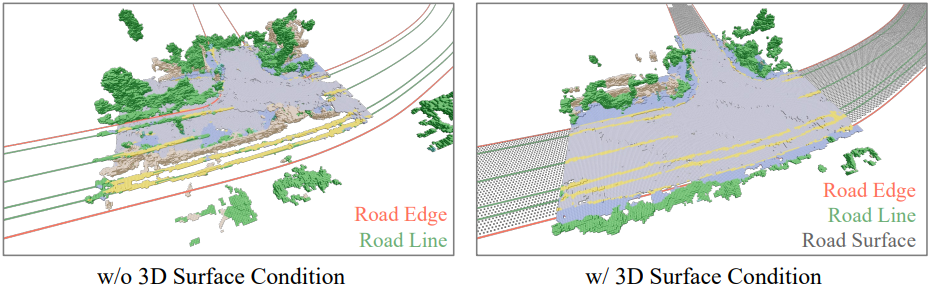
- 도로 표면 조건 \(\textbf{C}_\textrm{Road}^\textrm{vx}\): 로컬 청크를 생성할 때 HD map이 조건 \(\textbf{C}_\textrm{HD}\)에 부분적으로만 포함되는 경우가 발생할 수 있다. 이러한 상황에서 모델이 \(\textbf{C}_\textrm{HD}^\textrm{vx}\)만으로 주행 가능한 도로 영역을 판단하기 어렵다. 따라서 모델에게 주행 가능 영역에 대한 정보를 추가로 제공하기 위해, voxelize된 도로 표면을 나타내는 또 다른 조건 \(\textbf{C}_\textrm{Road}^\textrm{vx} \in \mathbb{R}^{N^3 \times 1}\)을 추가한다. 이는 주어진 road edge와 road line에 3D 평면을 fitting하고 그 도로 표면 부분만을 유지하는 방식으로 구현된다.
- Bounding box 조건 \(\textbf{C}_\textrm{Box}^\textrm{vx}\): Bounding box에는 차량의 포즈에 대한 상세 정보가 포함되어 있다. 그러나 bounding box가 점유하는 영역을 단순히 voxelize할 경우, 정보 손실이 발생할 수 있다. 따라서 차량의 heading angle $\alpha$를 2채널 벡터 $[\sin \alpha, \cos \alpha]$로 인코딩하고, 해당 voxel의 절반 이상이 bounding box에 의해 점유된 경우 \(\textbf{C}_\textrm{Box}^\textrm{vx} \in \mathbb{R}^{N^3 \times 2}\)의 feature를 이 인코딩 값으로 설정한다.
최종 condition volume은 세 가지 조건을 concat하여 구성된다.
\[\begin{equation} \textbf{C}^\textrm{vx} = \{ \textbf{C}_\textrm{HD}^\textrm{vx}, \textbf{C}_\textrm{Road}^\textrm{vx}, \textbf{C}_\textrm{Box}^\textrm{vx} \} \in \mathbb{R}^{N^3 \times 4} \end{equation}\]단일 청크 생성
\(\textbf{C}^\textrm{vx}\)를 Xcube의 샘플링 프로세스에 적용함으로써, 목표로 하는 semantic voxel grid 표현인 \(\textbf{D}^\textrm{vx}\)를 생성한다. 구체적으로, 이 샘플링 프로세스는 $\mathbb{R}^{N^3 \times C}$ 형태의 Gaussian noise에서 시작되며, 여기에 조건 \(\textbf{C}^\textrm{vx}\)가 채널 차원을 따라 concat된다. 이후 3D U-Net이 해당 Gaussian noise를 반복적으로 denoising하여 latent \(\textbf{X}^\textrm{vx}\)를 얻게 되며, 이는 디코딩을 통해 semantic sparse voxel grid로 변환될 수 있다. 본 과정에서는 XCube와 같은 hierarchical upsampling 방식을 적용하지 않는다.
무제한 장면 Outpainting
그러나 LDM 샘플링을 한 번 수행하는 것만으로는 장면의 한 청크만을 생성할 수 있다. 따라서 본 논문은 grid를 확장하여 거대한 voxel world를 생성하는 outpainting 전략을 제안하였다. 여기서는 diffusion model에서 흔히 사용되는 training-free outpainting 기법인 Repaint와 유사한 전략을 사용하여, 장면을 매끄럽게 반복적으로 확장한다.
구체적으로, 새로운 청크를 생성할 때 기존 장면 영역과 충분히 겹치도록 하고, 그 중첩 영역에서 latent \(\textbf{X}_\textrm{exist}^\textrm{vx}\)를 가져온다. Diffusion process 동안 \(\textbf{X}_\textrm{exist}^\textrm{vx}\)는 고정된 상태로 유지하고, 새로 생성되는 부분에 해당하는 latent \(\textbf{X}_\textrm{new}^\textrm{vx}\)만 다음과 같이 업데이트한다.
\[\begin{equation} \textbf{X}_\textrm{new}^\textrm{vx} \leftarrow (1 - \textbf{M}) \odot \hat{\textbf{X}}_\textrm{new}^\textrm{vx} + \textbf{M} \odot \hat{\textbf{X}}_\textrm{exist}^\textrm{vx} \end{equation}\]($\textbf{M}$은 중첩 마스크, $\odot$은 element-wise product)
이를 통해 서로 다른 청크 간에 일관성을 유지하는 대규모 장면을 생성할 수 있다.
2. World-Guided Video Generation
저자들은 동영상 생성을 위한 base model로 Stable Video Diffusion XT (SVD-XT)를 선택했다. 동영상 데이터 \(\textbf{D}^\textrm{vd} \in \mathbb{R}^{H \times W \times T \times 3}\)은 볼륨으로 표현되며, LDM에 의해 모델링되는 동영상의 latent는 공간 해상도가 $h = H/8$, $w = W/8$로 다운샘플링된 형태이다.
\[\begin{equation} \textbf{X}^\textrm{vd} = \mathcal{E}^\textrm{vd} (\textbf{D}^\textrm{vd}) \in \mathbb{R}^{h \times w \times T \times 4} \end{equation}\]Voxel 생성 모델과 유사하게, 모델에 입력되는 조건 \(\textbf{C}^\textrm{vd} \in \mathbb{R}^{h \times w \times T \times M}\)은 \(\textbf{X}^\textrm{vd}\)와 동일한 크기를 갖는다. SVD 모델은 첫 번째 동영상 프레임을 조건으로 사용하는 기능을 지원한다. 이때 조건 \(\textbf{C}_\textrm{Img}^\textrm{vd} \in \mathbb{R}^{h \times w \times T \times 4}\)는 해당 프레임을 $T$회 반복한 뒤 SVD 인코더 \(\mathcal{E}^\textrm{vd}(\cdot)\)로 인코딩하여 생성된다. $T$ 프레임을 초과하는 긴 동영상을 생성하기 위해, 마지막으로 생성된 프레임의 latent를 조건으로 재사용하여 auto-regressive한 방식으로 inference 과정을 반복 수행한다.
그러나 이러한 방식으로 길고 일관된 주행 영상을 생성하는 것은 어려운 과제이다. 특히 3회 이상의 auto-regression 과정을 거칠 경우, 누적 오차로 인해 프레임 품질이 크게 저하되기 때문이다. 이러한 문제를 해결하기 위해, 본 논문에서는 voxel world로부터 렌더링된 3D grounded guidance buffer를 활용하는 방안을 제안하였다. 이 buffer는 동영상 모델이 차량의 움직임과 환경 변화를 더 효과적으로 포착할 수 있도록 돕는 핵심적인 3D 정보와 guidance를 제공함으로써, 누적 오차를 크게 완화해 준다.
Guidance Buffers
Guidance buffer는 주어진 카메라 파라미터를 사용하여 3D world를 동영상 프레임으로 렌더링한 결과물이다. 이들은 다음과 같은 구성요소로 이루어진다.
- Semantic buffer \(\textbf{C}_\textrm{Sem}^\textrm{vd}\): Voxel world의 semantic label을 렌더링한 것이다. Semantic label을 RGB 값에 매핑하기 위해 고정된 색상 팔레트를 사용한다. 동일한 semantic 카테고리에 속하는 개별 차량들을 구별하기 위해 렌더링된 색상에 서로 다른 채도 수준을 부여한다. 이를 통해 buffer 내에서 여러 차량이 서로 겹쳐 있을 때에도 동영상 모델이 개별 차량의 고유한 외형을 유지할 수 있게 한다.
- Coordinate buffer \(\textbf{C}_\textrm{Crd}^\textrm{vd}\): 각 pixel ray가 처음으로 충돌하는 voxel의 3D 좌표이다. 3D 장면 내 동일한 위치의 경우, 서로 다른 픽셀 좌표로 projection될 수는 있지만, 그 3D voxel 좌표는 일관되게 유지된다. $T$개의 프레임에서 충돌한 모든 3D voxel을 수집하고 좌표를 상수로 정규화한 뒤 \(\mathcal{E}^\textrm{vd}(\cdot)\)가 수용할 수 있는 범위로 값을 clamping한다.
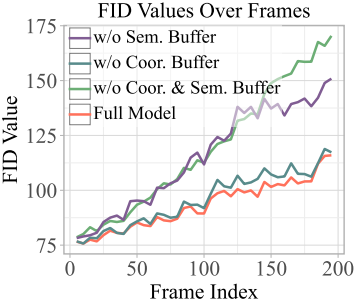
Coordinate buffer는 프레임 간 장면 대응관계를 확립하는 데 도움을 주며, semantic buffer가 반복적인 패턴을 보일 때 유용하다. 결과적으로 동영상 모델 조건의 채널 크기는 $M = 12$가 된다.
\[\begin{equation} \textbf{C}^\textrm{vd} = \{ \textbf{C}_\textrm{Img}^\textrm{vd}, \textbf{C}_\textrm{Sem}^\textrm{vd}, \textbf{C}_\textrm{Crd}^\textrm{vd} \} \in \mathbb{R}^{h \times w \times T \times 12} \end{equation}\]fVDB를 사용하여 voxel world를 렌더링함으로써 매우 효율적으로 guidance buffer를 구축할 수 있다.
텍스트 프롬프트 추가
동영상 모델은 이미지를 조건으로 필요로 한다. 저자들은 이를 위해 semantic buffer를 제어 이미지로 활용하여 초기 프레임을 생성하는 FLUX 기반의 ControlNet을 학습시켰다. 이러한 접근 방식은 장면 생성 시 텍스트 설명을 반영할 수 있게 할 뿐만 아니라, 사전 학습된 이미지 diffusion model을 활용하여 동영상 콘텐츠의 품질과 다양성을 향상시킨다.
3. Dynamic 3DGS Scene Generation
동영상 모델이 이미 사실적이고 일관된 외형을 구현할 수 있기는 하지만, 시뮬레이션 task에서는 여전히 3D 표현이 중요하며 필수적으로 요구된다. 따라서 본 논문에서는 동적 object를 포함한 3DGS 장면을 재구성하기 위해, 전체 파이프라인에 긴밀하게 통합된 새로운 feed-forward 방식을 제안하였다.
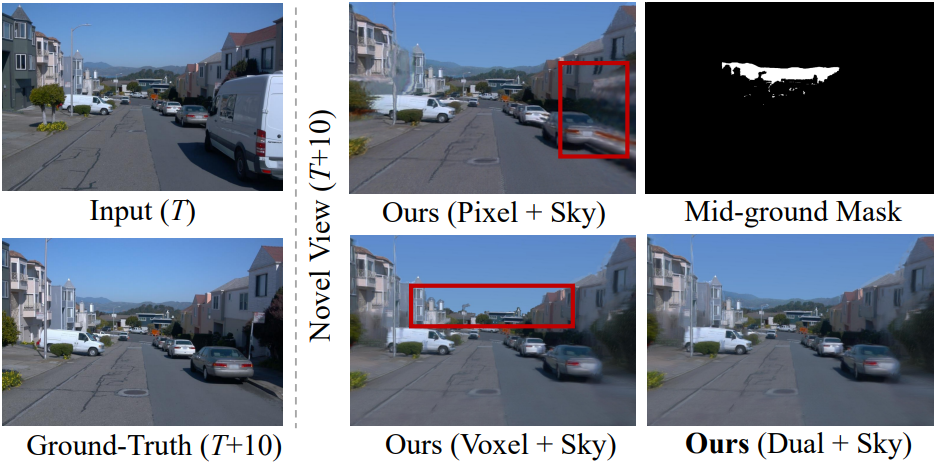
3DGS 표현을 활용하는 SOTA feed-forward 장면 재구성 모델들은 voxel space 또는 pixel space에서 Gaussian 속성을 추론한다. 전자는 일반적으로 더 우수한 geometry 분포를 보이는 반면, 후자는 중간 거리 영역의 콘텐츠와 동적 object의 프레임별 움직임을 더 잘 포착할 수 있다. 따라서 본 논문에서는 이 두 가지 장점을 모두 결합한 새로운 dual-branch 재구성 방식을 제안하였다.
Voxel Branch
Voxel branch는 voxel space와 포즈 정보가 포함된 동영상 프레임을 입력으로 받아, 각 voxel에 대한 3D Gaussian 집합을 출력한다. SCube와 유사하게, 이미지의 feature를 voxel space로 unprojection한 다음, 3D sparse convolution U-Net 아키텍처를 적용하여 해당 feature를 voxel별 Gaussian 속성으로 변환한다. 이때 이미지 feature에서 동적 object는 마스킹하여 제외하고, 정적인 배경 voxel만을 사용한다.
Pixel Branch
Pixel branch는 GS-LRM과 유사하게 2D UNet backbone을 사용하여 입력 이미지를 픽셀별 3D Gaussian으로 변환하며, 이를 통해 문제를 깊이 추정 문제로 단순화한다. 저자들은 pixel branch 내에서 렌더링된 voxel depth $\textbf{Z}$를 활용하여 깊이 예측 능력과 일반화 성능을 향상시키기 위한 self-supervised training 전략을 추가로 제안하였다.
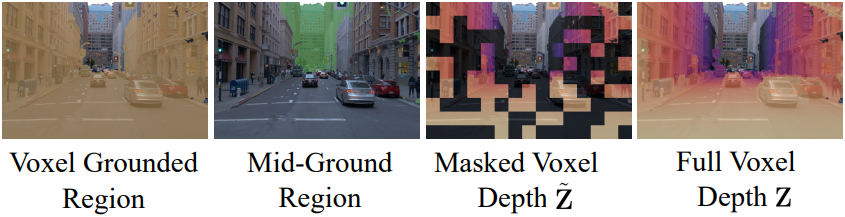
구체적으로, $\textbf{Z}$를 입력과 supervision 신호로 모두 활용한다. 학습 과정에서는 voxel 정보가 없는 영역을 모사하기 위해 $\textbf{Z}$에 랜덤 마스킹을 적용한 $\tilde{\textbf{Z}}$를 사용하고, 예측된 깊이는 전체 $\textbf{Z}$를 이용해 학습된다. 이는 inference 시 pixel branch가 합리적인 중간 거리 영역의 깊이를 예측하는 데 도움을 준다. 또한, SOTA 깊이 추정 모델인 Depth Anything V2의 ViT backbone feature \(\textbf{F}_\textrm{DAV2}\)를 네트워크에 추가로 활용한다.
하늘 모델링
무한한 깊이에 위치한 하늘 영역은 이미지상에서 대부분 보이지 않기 때문에 이를 모델링하는 것은 까다로운 과제이다. 따라서 본 논문에서는 보지 못한 영역으로의 일반화 성능이 뛰어난 STORM의 하늘 표현 방식을 채택하였다. 구체적으로, 가벼운 인코더를 사용하여 이미지로부터 하늘 feature 벡터 $\textbf{c} \in \mathbb{R}^{192}$를 추출하고, AdaLN을 활용하여 시야각을 입력받아 RGB 색상을 출력하는 MLP를 변조한다.
Supervision
Photometric loss를 사용하여 두 개의 branch를 각각 별도로 학습시킨다. Pixel branch에는 깊이 loss를 추가로 적용한다.
동적 object
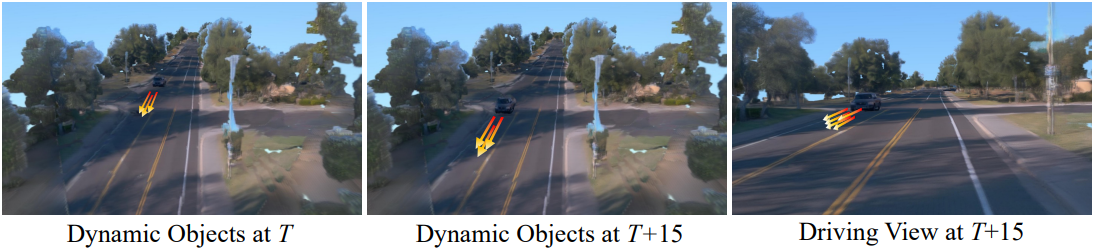
Inference 시에 voxel branch는 장면의 정적 부분에만 적용된다. Pixel 분기는 4프레임마다 반복적으로 적용되지만, 중간 배경 영역과 동적 object의 픽셀에 해당하는 3DGS만 유지한다. 특히, 동적 차량의 경우, semantic buffer에서 얻은 segmentation 결과를 사용하여 각 object에 해당하는 3DGS를 추출하고, 포즈를 이용하여 변환 및 통합한 다음, 입력 bounding box의 Gaussian을 유지하여 최종 Gaussian을 합성한다. Object의 움직임은 궤적을 변경하는 것만으로 완벽하게 제어할 수 있다.
Experiments
1. Large-scale Dynamic Scene Generation
다음은 전체 파이프라인 결과들이다.
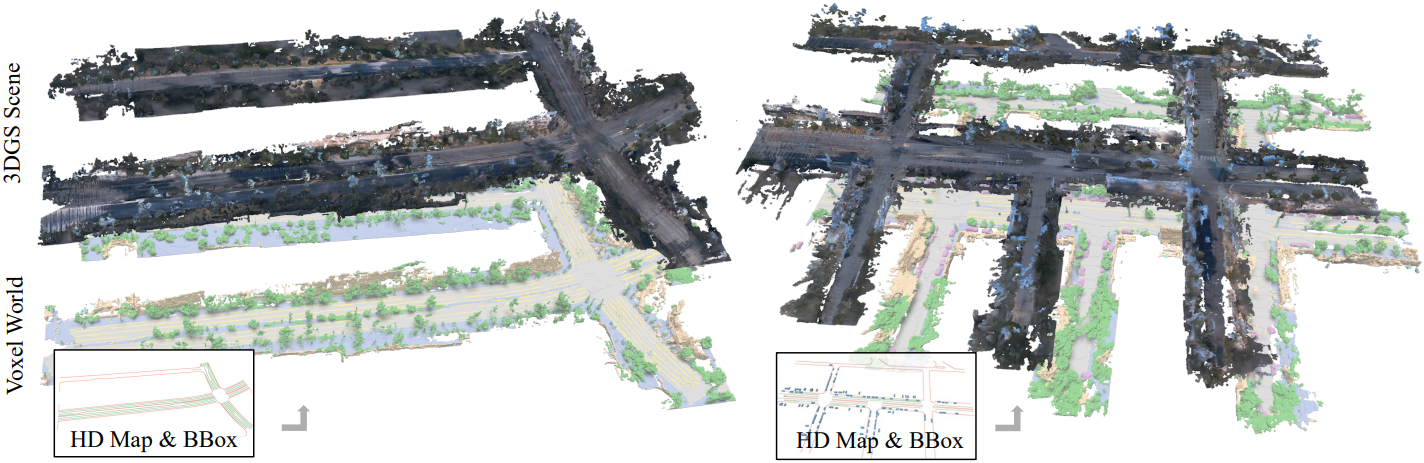
다음은 동적 3DGS 장면을 시각화한 결과이다.
2. Main Components Analysis
다음은 도로 표면 조건 \(\textbf{C}_\textrm{Road}\) 사용 유무에 따른 결과를 비교한 것이다.
다음은 동영상 모델 비교 결과이다.
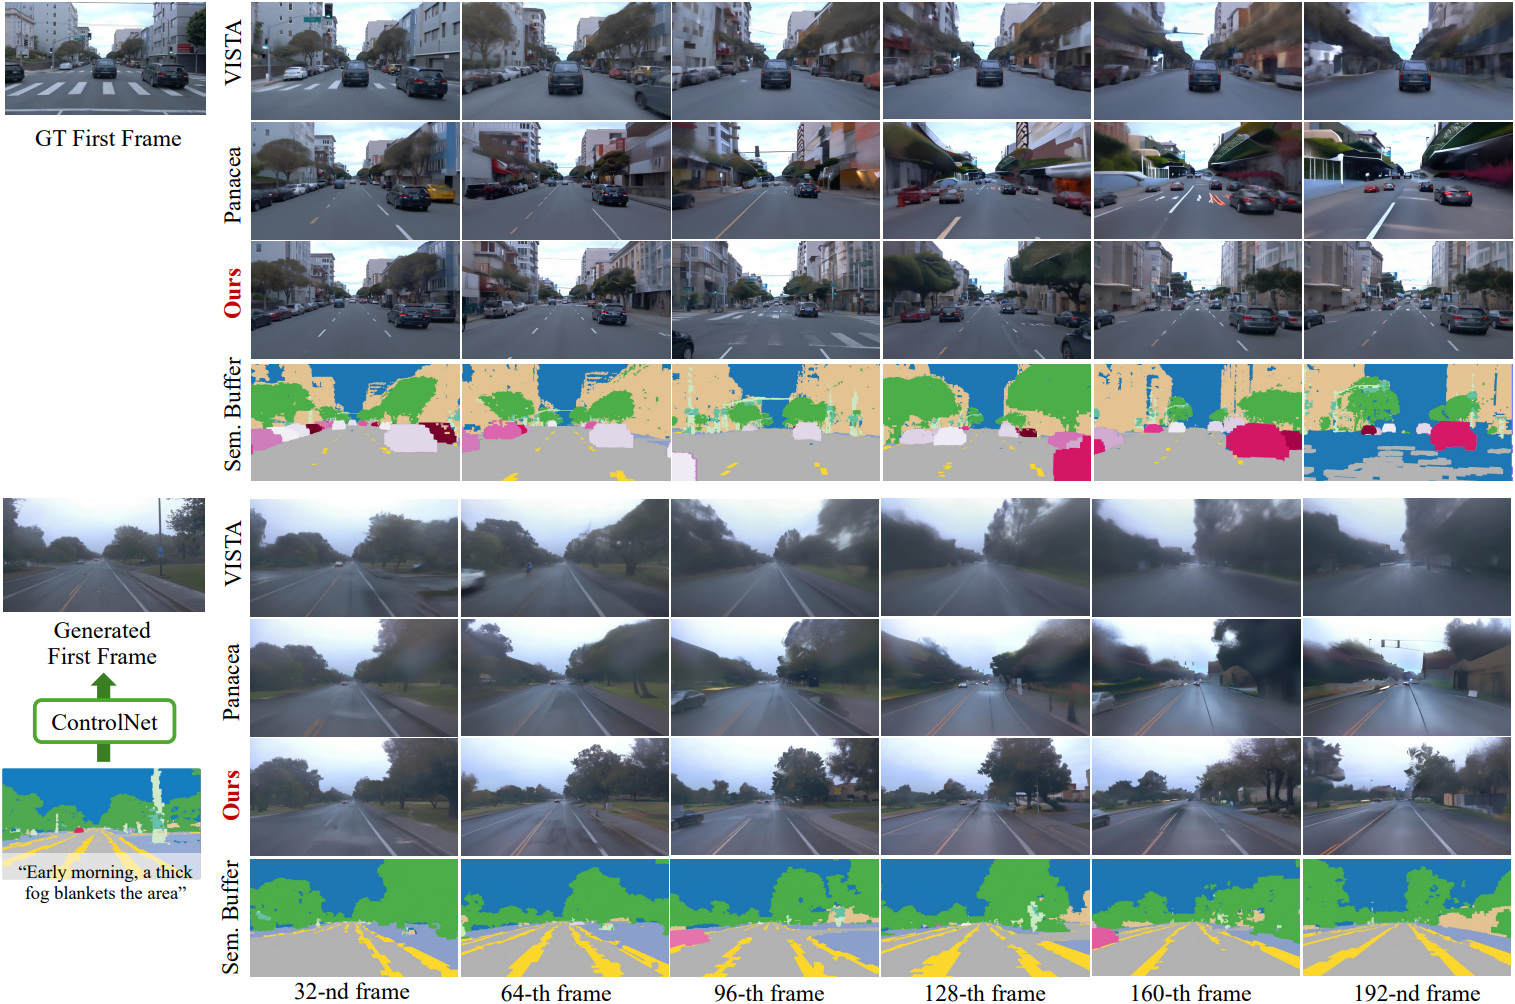
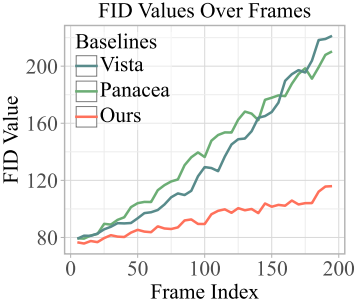
다음은 guidance buffer에 대한 ablation 결과이다.
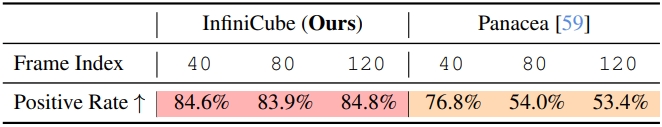
다음은 HD map 정렬에 대한 인간 평가 결과이다.
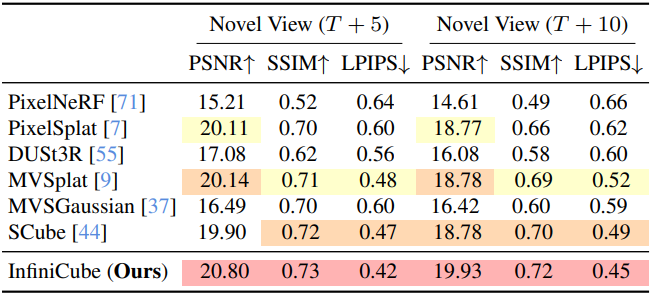
다음은 novel view 렌더링 결과이다.
3. Applications
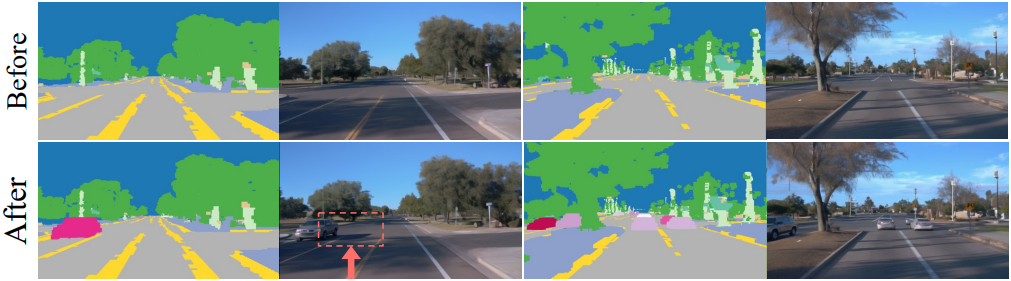
다음은 동영상 모델을 이용한 object 삽입 예시이다.
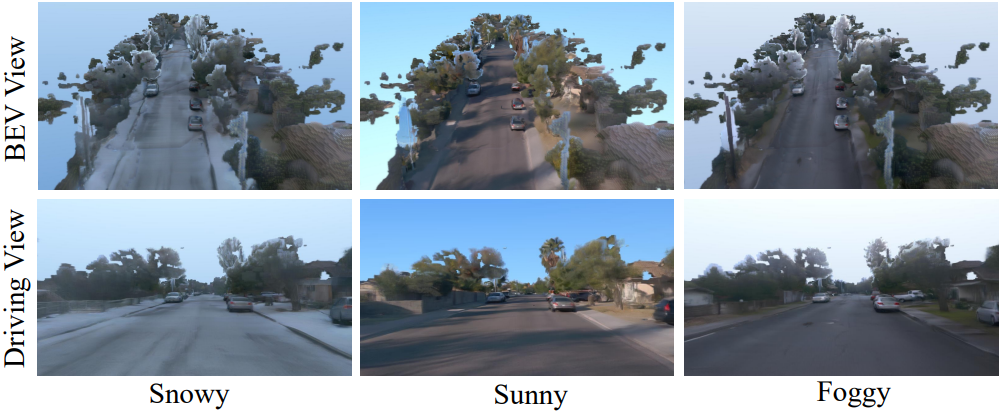
다음은 텍스트 프롬프트를 통한 날씨 제어 예시이다.