[논문리뷰] FastMesh: Efficient Artistic Mesh Generation via Component Decoupling
3DV 2026. [Paper] [Page] [Github]
Jeonghwan Kim, Yushi Lan, Armando Fortes, Yongwei Chen, Xingang Pan
S-Lab, Nanyang Technological University
26 Aug 2025
Introduction
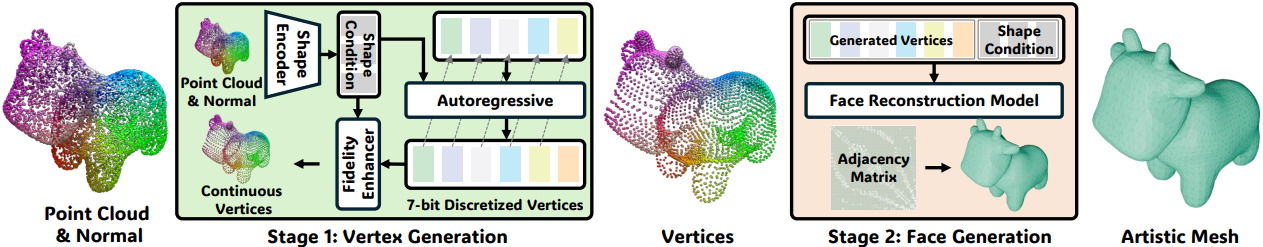
본 논문에서는 고품질 3D 메쉬를 수 초 내에 생성할 수 있는 효율적인 프레임워크인 FastMesh를 소개한다. 핵심 아이디어는 메쉬 tokenization 과정에서 흔히 발생하는 중복 문제를 피하기 위해 vertex와 face의 생성을 분리하고 이를 순차적으로 처리하는 것이다.
Vertex 생성의 경우, 가변적인 vertex 개수를 유연하게 처리할 수 있는 autoregressive 모델을 사용한다. Vertex가 생성된 후, vertex 간의 연결성이 주로 로컬 정보에 의존한다는 점에 착안하여 병렬 처리를 수행한다. 이를 위해 양방향 transformer를 활용하여 vertex 간 관계를 모델링하고, 이를 통해 one step으로 직접 edge 연결을 도출한다. 이렇게 생성된 edge들은 adjacency matrix를 구성하며, 이를 기반으로 닫힌 삼각형을 식별하여 face를 추출한다. 이러한 설계 덕분에 FastMesh는 기존의 가장 효율적인 tokenizer가 요구하던 토큰 수의 약 23% 수준으로 토큰 수를 줄였으며, 이를 통해 긴 토큰 시퀀스로 인해 발생하는 높은 inference latency 및 품질 저하 등의 문제를 크게 완화했다.
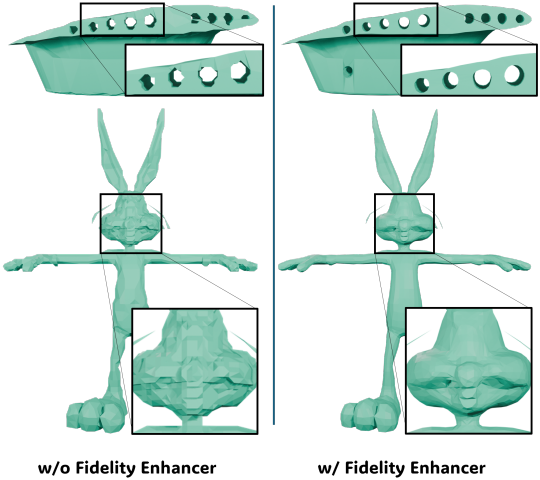
여기에 더해, 메쉬 품질을 더욱 향상시키기 위해 fidelity enhancer 모듈과 prediction filtering 프로세스를 도입했다. Fidelity enhancer는 인덱싱으로 제약된 discretize된 vertex 위치를 continuous한 좌표로 변환한다. 이를 통해 더욱 매끄러운 표면과 자연스러운 vertex 분포를 얻을 수 있다. 또한, face 생성을 위한 후처리 기법인 prediction filtering은 관련 없는 연결을 점진적으로 마스킹하여 adjacency matrix를 개선한다. 이는 의도된 기하학적 구조를 유지하면서 중복되거나 불필요한 face를 줄여 더욱 깔끔하고, 간결한 메쉬를 생성한다.
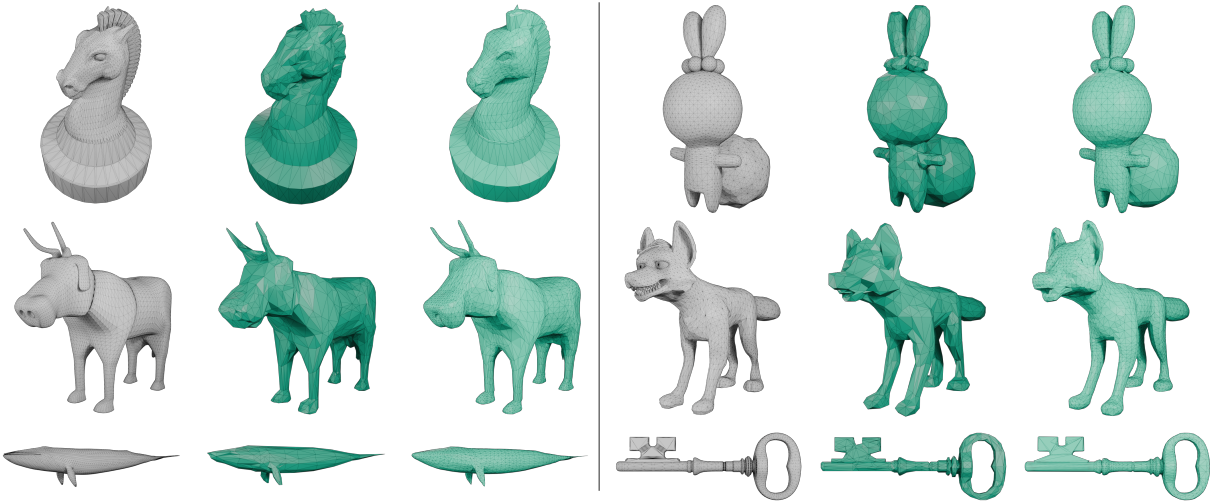
FastMesh는 기존 방식보다 훨씬 적은 시간 내에 더 높은 품질의 3D 메쉬를 생성할 수 있음이 입증되었다. 1,000개 및 4,000개의 vertex를 가진 메쉬를 생성할 때, FastMesh는 각각 약 7초와 30초만이 소요되어 BPT 대비 8배 빠른 속도를 달성했다. 특히, 더 많은 vertex 수를 사용하여 continuous space에서 메쉬를 생성하므로 기하학적 정확도뿐만 아니라 시각적 품질 면에서도 우수한 결과를 보여준다.
Method
1. Stage I: Vertex Generation
Vertex 생성은 전체적인 메쉬 품질에 지대한 영향을 미치므로, 저자들은 고품질의 vertex 예측이 가능하도록 접근 방식을 설계했다. 먼저 autoregressive 모델을 사용하여 vertex 시퀀스를 생성한 다음, fidelity enhancer를 통해 vertex 위치를 정교화함으로써 더욱 정확하고 자연스럽게 배치된 vertex 분포를 얻는다. Autoregressive 모델에서의 효율적인 생성을 지원하기 위해, vertex 표현 시퀀스를 효과적으로 압축하는 block-wise indexing 기법을 사용한다.
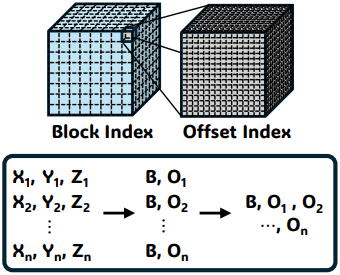
구체적으로, XYZ 좌표를 block index와 offset index로 매핑하는데, 이는 global block과 local offset으로 구분된 discretize된 3D 공간을 나타낸다. 또한, 각 block 내의 vertex들을 통합하여 시퀀스 내의 그룹당 block index를 한 번만 할당한다. 이를 통해 최종 시퀀스 길이를 vertex의 개수와 대략 일치하는 수준으로 압축한다. 이러한 시퀀스 길이의 단축은 inference 속도를 크게 향상시키고, 예측 오차의 누적을 줄여 생성 과정을 안정화한다.
Block-wise indexing은 순차적 표현을 효율적으로 압축하지만, 3D 공간 discretization에 의존하기 때문에 미세한 디테일이 손실된다는 한계가 있다. 3D object의 복잡도가 증가하고 vertex의 수가 늘어남에 따라 더 높은 공간 해상도가 요구되는데, 이는 이러한 정보 손실을 더욱 심화시킨다. 이러한 문제는 주로 vertex 위치가 quantize된 점으로 이동하고 인접한 점들이 병합되기 때문이다.
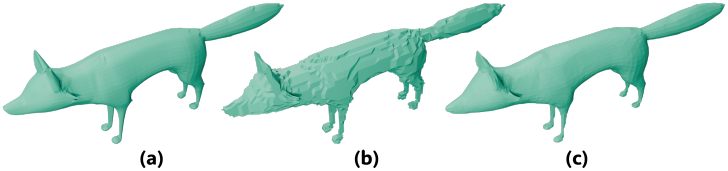
위 그림에서 볼 수 있듯이, object를 7-bit 해상도로 discretize하면 디테일이 눈에 띄게 감소하지만, vertex 위치만 continuous한 값으로 조정하면 원래의 geometry 대부분이 복원된다.
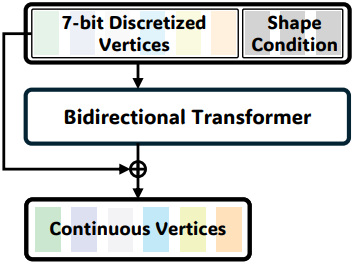
이러한 관찰을 바탕으로, 저자들은 7-bit로 discretize된 vertex 위치와 shape 정보를 입력받아 residual을 예측함으로써 각 vertex를 continuous한 좌표로 변환하는 소형 transformer인 fidelity enhancer를 설계했다.
2. Stage II: Face Generation
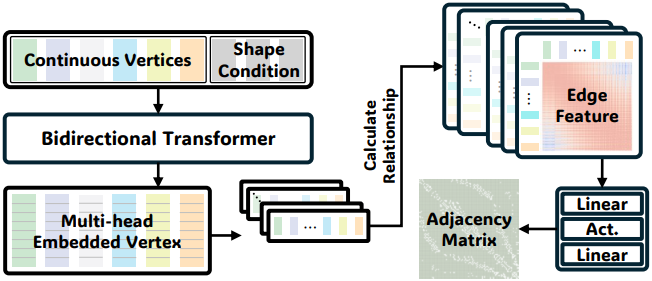
Stage II에서는 bidirectional transformer를 사용하여 vertex 간의 관계를 포착하고 vertex를 임베딩한 뒤, edge를 예측하여 메쉬 구조를 완성한다. SpaceMesh가 관계형 구조 모델링에 있어 spacetime distance function의 유효성을 입증했으므로, 본 논문에서는 이 함수를 채택하여 다음과 같이 정의되는 vertex 간 상호작용을 계산한다.
$u$와 $v$는 입력 벡터로서 임베딩된 vertex feature에 해당한다. 각 벡터는 절반으로 나뉘며, 두 부분에 대해 각각 유클리드 거리가 계산된다.
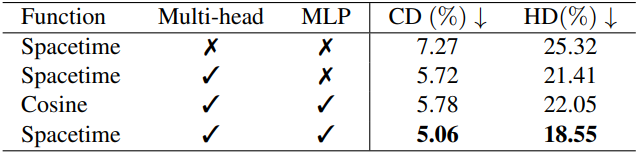
SpaceMesh에서와 같이 이 함수를 최종 activation으로 사용하는 대신, 본 논문에서는 multi-head 방식을 채택하였다. Feature 벡터를 분할하여 각 head에 해당 함수를 독립적으로 적용하고, 각 결과를 edge feature의 개별 차원으로 구성하는 구조이다. 이렇게 생성된 edge feature는 예측 네트워크를 통과하여 vertex 간 연결성을 결정하기 위한 edge logit을 출력한다. 이러한 전략은 다양하고 복잡한 연결성을 표현하는 네트워크의 능력을 크게 향상시킨다. 마지막으로, logit을 0으로 thresholding하여 edge 연결 여부를 결정한 뒤, 서로 연결된 vertex의 triplet을 식별하여 메쉬 face를 구성한다.
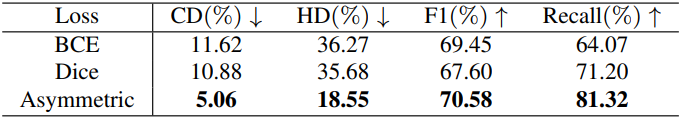
학습 단계에서는 asymmetric loss를 사용하여 edge 예측을 유도하고, vertex 수가 증가함에 따라 비율이 감소하는 positive 쌍을 강조한다. 또한, geometry 정확도를 유지하기 위해 클래스 균형을 추구하기보다는 구멍을 만드는 false-positive edge를 줄이는 데 우선순위를 둔다. Loss는 다음과 같이 정의된다.
\[\begin{equation} \textrm{AsyLoss} (p) = \begin{cases} L_{+} = \log (p) \\ L_{-} = p^3 \log (1-p) \end{cases} \end{equation}\](\(L_{+}\)와 \(L_{-}\)는 각각 positive 샘플과 negative 샘플에 대한 loss 값)
Face 생성 과정이 한 번의 feedforward로 수행되기 때문에 정교한 결과를 생성하면서도 빠른 inference 속도를 달성할 수 있다.
3. Post-processing: Prediction Filtering
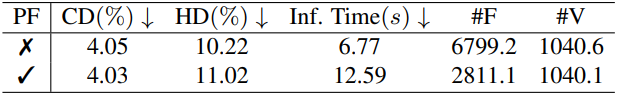
Face 생성 과정에서 간혹 잘못된 연결이 예측되는데, 대부분은 중복으로 인해 메쉬 구조에 큰 영향을 미치지 않지만 계산 비용을 증가시킨다. 이를 해결하기 위해 초기 adjacency matrix 예측 후 적용되는 후처리 전략인 prediction filtering을 도입한다.
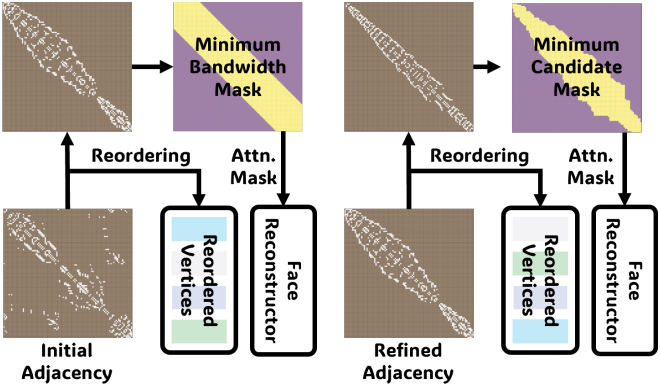
Adjacency matrix의 bandwidth는 $A[i][j] \neq 0$인 경우의 최대 $\vert i - j \vert$ 값으로 정의되며, 이는 대각선으로부터 연결이 발생하는 지점까지의 최대 거리를 나타낸다. 먼저 BFS를 통해 node 순서를 재배치하여 bandwidth를 줄이고, $\vert i - j \vert \le B$인 edge만 유지하는 minimal bandwidth mask를 구성한다. 이 마스크를 사용하여 두 번의 iteration을 거쳐 edge를 재예측하며, 각 step마다 후보 집합을 좁혀 나간다.
그 후, 각 node $i$에 대해 최대 유효 연결 거리 $r_i$를 계산하고, $\vert i - j \vert \le r_i$인 edge만 유지하는 minimum candidate mask를 구성한다. 이 마스크를 사용하여 다시 두 번의 iteration을 거쳐 edge를 재예측한다.
Experiments
1. Performance Evaluation
다음은 Toys4K 데이터셋에서의 비교 결과이다.
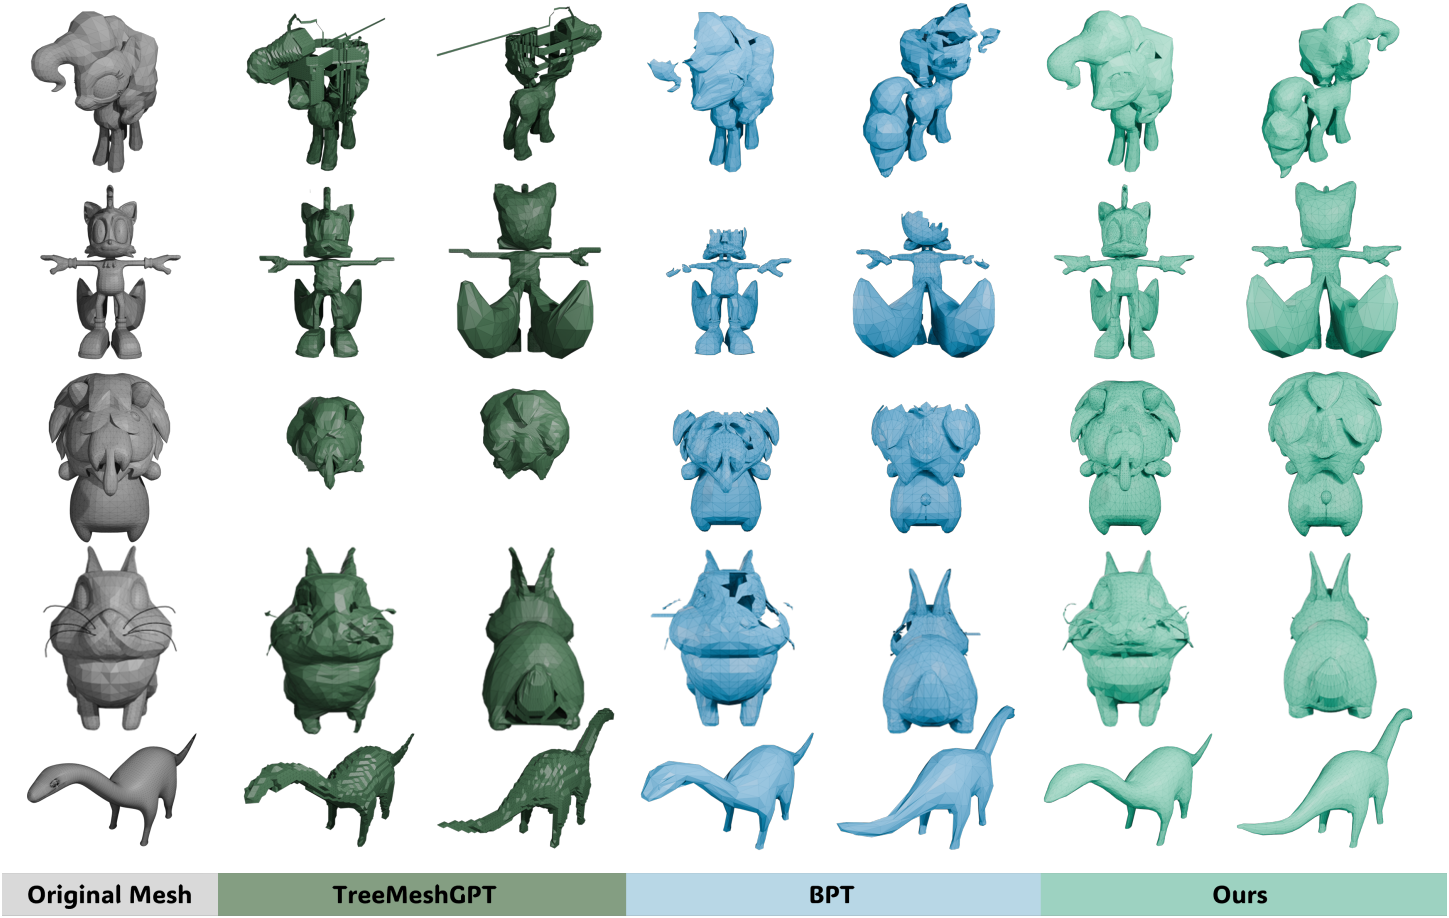
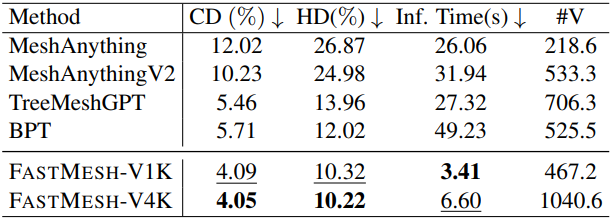
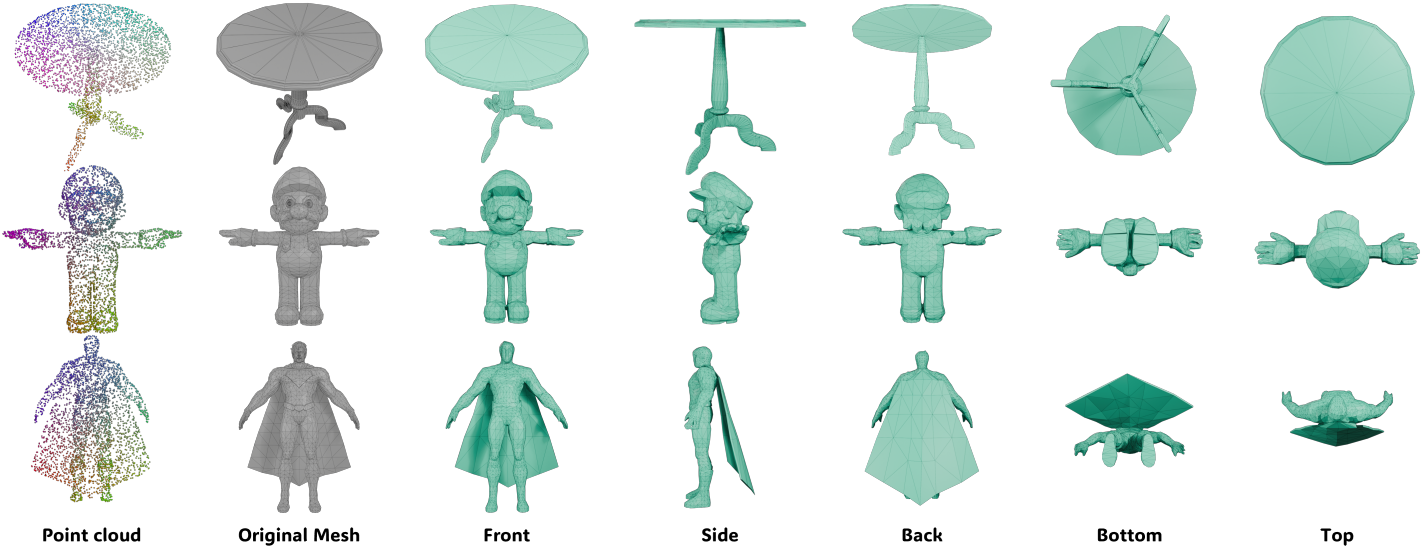
다음은 Objaverse 데이터셋에서의 FastMesh 결과들이다.
2. Ablation Studies
다음은 edge 예측 구조에 대한 ablation 결과이다. (Toys4K)
다음은 loss function에 대한 ablation 결과이다. (Toys4K)
다음은 prediction filtering에 대한 ablation 결과이다. (Toys4K)
다음은 fidelity enhancer에 대한 ablation 결과이다.
3. Discussion
다음은 FastMesh-V1K와 FastMesh-V4K를 비교한 예시들이다.