[논문리뷰] DDT: Decoupled Diffusion Transformer
CVPR 2026. [Paper] [Github]
Shuai Wang, Zhi Tian, Weilin Huang, Limin Wang
Nanjing University | ByteDance Seed Vision
8 Apr 2025
Introduction
DiT는 기존에 주류를 이루던 UNet 기반 모델을 대체하기 위해 diffusion model에 Transformer 아키텍처를 도입했다. 충분한 학습이 이루어질 경우 DiT는 긴 residual connection에 의존하지 않고도 기존 방식보다 우수한 성능을 보인다. 그럼에도 불구하고, 느린 수렴 속도로 인한 높은 비용은 새로운 모델을 개발하는 데 있어 여전히 큰 과제로 남아 있다.
고전적인 컴퓨터 비전 알고리즘은 풍부한 feature 추출을 위한 대형 인코더와 효율적인 inference를 위한 가벼운 디코더를 전략적으로 결합한 encoder-decoder 구조를 주로 사용한다. 반면, 최신 diffusion model은 주로 decoder-only 구조에 의존하고 있다.
저자들은 실험적 조사를 통해, 일반적인 DiT는 추상적인 구조 정보 추출과 디테일한 외형 정보 복원 사이의 최적화 딜레마를 가지고 있음을 확인했다. 또한, DiT는 pixel supervision에 의존하기 때문에 semantic 표현 추출에 한계가 있다. 이러한 문제를 해결하기 위해, 맞춤형 encoder-decoder 설계를 통해 저주파 semantic 인코딩과 고주파 디테일 디코딩을 명시적으로 분리하는 새로운 아키텍처를 제안하였다.
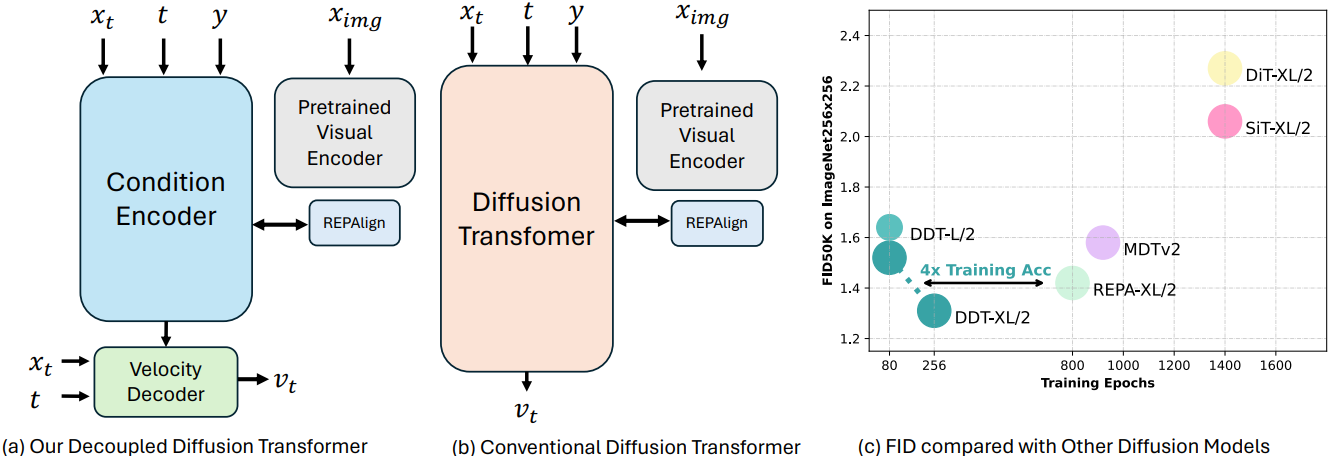
이 encoder-decoder DiT 모델을 Decoupled Diffusion Transformer (DDT)라고 부른다. DDT는 condition encoder를 사용하여 semantic self-condition feature를 추출한다. 추출된 self-condition은 noisy latent와 함께 velocity decoder에 입력되어 velocity field를 예측한다. 인접 step의 self-condition feature의 로컬 일관성을 유지하기 위해, 표현 정렬의 직접적인 supervision과 디코더의 velocity loss로부터의 간접적인 supervision을 활용한다.
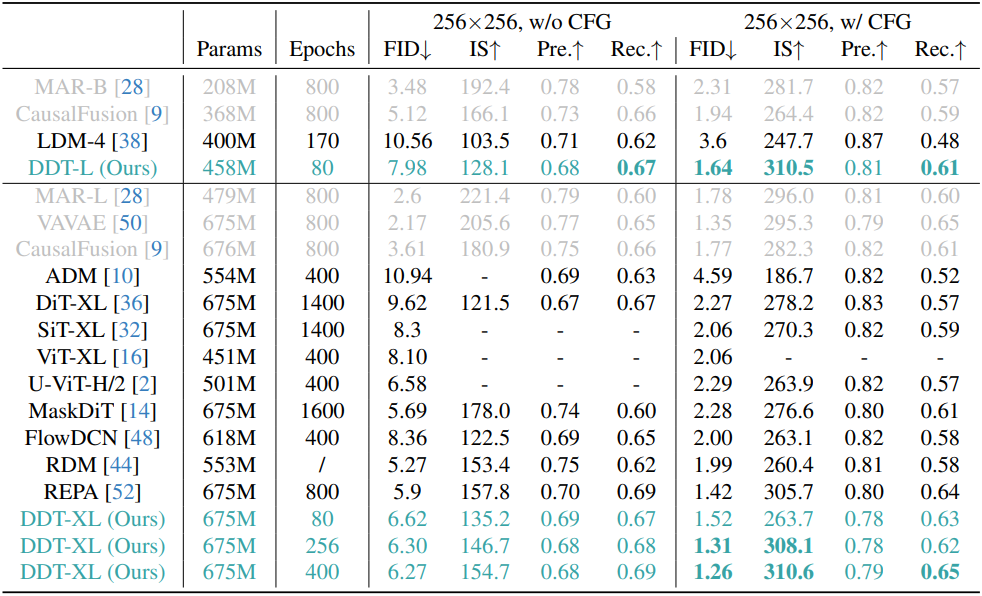
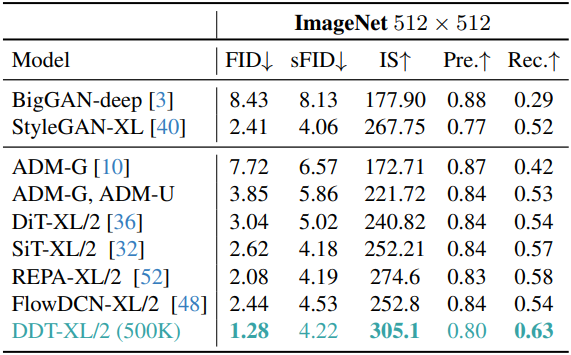
ImageNet 256$\times$256 데이터셋에서 DDT-XL/2 모델은 interval guidance를 적용하여 단 256 epoch 만에 1.31 FID라는 SOTA 성능을 달성했으며, 이는 REPA 대비 약 4배 빠른 학습 속도이다. ImageNet 512$\times$512 데이터셋에서는 DDT-XL/2 모델은 50만 fine-tuning step 내에 1.28 FID를 달성했다.
또한, DDT는 인코더로부터 얻은 self-condition feature에 대해 강력한 로컬 일관성을 달성하였다. 이러한 특성으로 인해 인접 step 간 self-condition을 공유함으로써 inference 속도를 크게 향상시킬 수 있다. 본 논문에서는 인접 step 간 self-condition 공유로 인한 성능 저하를 최소화하는 최적의 인코더 공유 전략을 minimal sum path 문제로 구성하였다. 본 논문에서는 무시할 수 있는 수준의 시간 비용으로 최적의 인코더 공유 전략을 찾기 위한 통계적 dynamic programming 접근 방식을 제안하였다.
Preliminary Analysis
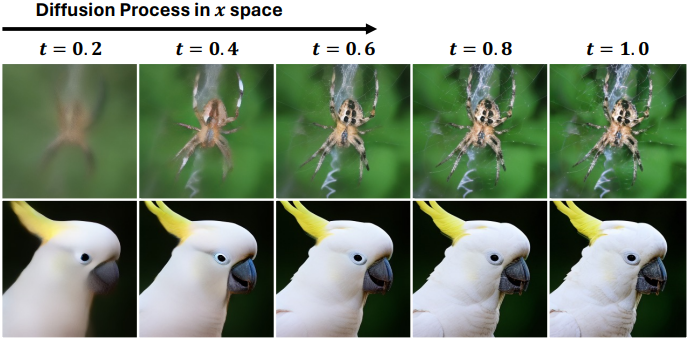
위 그림에서 볼 수 있듯이, diffusion model은 스펙트럼 성분을 autoregressive하게 정제한다. DiT는 noisy latent를 인코딩하여 고주파 디테일을 디코딩하기 전에 저주파 semantic 정보를 포착한다. 그러나 이러한 semantic 인코딩 과정은 필연적으로 고주파 정보를 감쇠시켜 최적화 문제를 야기한다. 이러한 문제점을 해결하기 위해 기존의 decoder-only DiT를 명시적인 encoder-decoder 아키텍처로 분리하는 방안을 제안하였다.
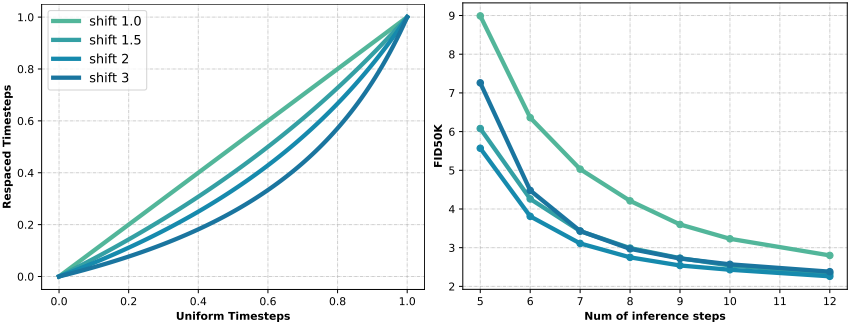
저자들은 현재 diffusion model의 한계를 파악하기 위해, SiT-XL/2를 이용하여 실험을 수행했다. 위 그래프에서 볼 수 있듯이, time-shift 값을 변화시키면서 초기 timestep에 더 많은 계산량을 할당하는 것이 최종 성능을 향상시키는 것을 확인했다. 이는 diffusion model이 noise가 많은 초기 timestep에서 어려움을 겪는다는 것을 보여준다. 따라서 현재의 DiT는 저주파 semantic 인코딩 용량에 근본적으로 제약을 받는다는 결론을 내릴 수 있다.
Method
본 논문에서 제시하는 분리형 DiT 아키텍처는 condition encoder와 velocity decoder로 구성된다. 저자들은 기존의 linear flow diffusion 프레임워크를 사용하여 모델을 학습시켰다.
1. Condition Encoder
Condition encoder는 DiT/SiT의 아키텍처 설계 및 입력 구조를 따른다. 구체적으로, 인코더는 긴 residual connection 없이 attention block과 FFN block이 교차로 배치된 구조로 구성된다. 인코더는 noisy latent \(\textbf{x}_t\), timestep $t$, 클래스 레이블 $y$라는 세 가지 입력을 받아, self-condition feature \(\textbf{z}_t\)를 추출한다.
\[\begin{equation} \textbf{z}_t = \textrm{Encoder} (\textbf{x}_t, t, y) \end{equation}\]구체적으로, noisy latent \(\textbf{x}_t\)는 continuous한 토큰으로 patchify된 후 encoder block을 사용하여 self-condition \(\textbf{z}_t\)를 추출하는 데 사용된다. Timestep $t$와 클래스 레이블 $y$는 임베딩으로 projection되어 외부 조건 정보로 사용된다. 이러한 외부 조건 임베딩은 각 encoder block 내에서 AdaLN-Zero를 사용하여 \(\textbf{x}_t\)의 인코딩된 feature에 점진적으로 주입된다.
인접한 timestep 간 \(\textbf{z}_t\)의 로컬 일관성을 유지하기 위해, REPA의 표현 정렬 기법을 사용한다. 이 방법은 인코더의 $i$번째 layer에서 얻은 중간 feature \(\textbf{h}_i\)를 DINOv2 표현 \(r_\ast\)와 정렬한다.
\[\begin{equation} \mathcal{L}_\textrm{enc} = 1 - \cos (r_\ast, h_\phi (\textbf{h}_i)) \end{equation}\]($h_\phi$는 learnable projection MLP)
이러한 간단한 정규화는 학습 수렴을 가속화하고 인접한 step 간 \(\textbf{z}_t\)의 로컬 일관성을 촉진한다. 이를 통해 인코더가 생성한 self-condition \(\textbf{z}_t\)를 인접한 step들 사이에서 공유할 수 있게 된다.
2. Velocity Decoder
Velocity decoder는 condition encoder와 동일한 아키텍처 설계를 채택하고 있으며, DiT/SiT와 유사하게 attention block과 FFN block이 교차로 적층된 형태로 구성된다. 이 디코더는 velocity \(\textbf{v}_t\)를 추정하기 위해 noisy latent \(\textbf{x}_t\), timestep $t$, 그리고 self-conditioning \(\textbf{z}_t\)를 입력으로 받는다. 인코더와 달리, 여기서는 클래스 레이블 정보가 이미 \(\textbf{z}_t\)에 내재되어 있다고 가정한다. 따라서 조건 입력으로는 timestep $t$와 self-condition feature인 \(\textbf{z}_t\)만이 사용된다.
\[\begin{equation} \textbf{v}_t = \textrm{Decoder} (\textbf{x}_t, t, \textbf{z}_t) \end{equation}\]앞서 설명한 바와 같이, 인접한 단계 간의 self-condition \(\textbf{z}_t\)의 일관성을 더욱 높이기 위해 AdaLN-Zero를 사용하여 \(\textbf{z}_t\)를 디코더 feature에 주입한다. 디코더는 flow matching loss를 사용하여 학습된다.
\[\begin{equation} \mathcal{L}_\textrm{dec} = \mathbb{E}[\int_0^1 \| (\textbf{x}_\textrm{data} - \epsilon) - \textbf{v}_t \|_2^2 dt] \end{equation}\]3. Sampling acceleration
인코더에는 명시적 표현 정렬을, 디코더에는 self-conditioning 주입을 도입함으로써, 학습 과정에서 인접한 step 간 \(\textbf{z}_t\)의 로컬 일관성을 확보했다. 이를 통해 적절한 로컬 범위 내에서 \(\textbf{z}_t\)를 공유할 수 있게 되어, 인코더의 연산 부담을 줄일 수 있다.
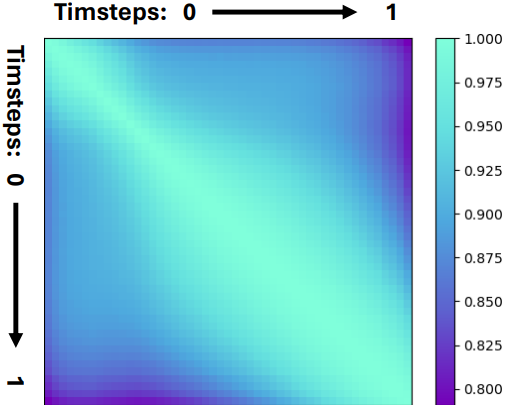
총 inference step 수를 $N$, 인코더 연산 예산을 $K$라고 할 때 (즉, 공유 비율은 $1 - K/N$), self-condition이 재계산되는 timestep의 집합을 $\vert \Phi \vert = K$인 $\Phi$로 정의한다. 현재 timestep $t$가 $\Phi$에 포함되지 않는 경우, 이전에 계산된 \(\textbf{z}_{t - \Delta t}\)를 \(\textbf{z}_t\)로 재사용한다. 반면 $t$가 $\Phi$에 포함되는 경우에는 인코더와 현재의 noisy latent \(\textbf{x}_t\)를 사용하여 \(\textbf{z}_t\)를 재계산한다.
통계적 Dynamic Programming
저자들은 $\Phi$를 구성하기 위한 간단하고 효율적인 통계적 dynamic programming 알고리즘을 제안하였다. 코사인 거리를 이용하여 서로 다른 step 사이의 \(\textbf{z}_t\) 유사도 행렬 $\textbf{S} \in \mathbb{R}^{N \times N}$을 구성한다. 최적의 $\Phi$ 집합은 총 유사도 비용인 \(- \sum_k^K \sum_{i=\Phi_k}^{\Phi_{k+1}} S[\Phi_k, i]\)가 global minimal을 갖도록 보장한다. 이 문제는 잘 정의된 minimal sum path 문제로서, dynamic programming을 통해 해결할 수 있다.
\(\Phi_k = i\)일 때의 cost를 \(\textbf{C}_i^k\), 추적된 경로를 \(\textbf{P}_i^k\)라 하면, \(\textbf{C}_j^{k-1}\)에서 \(\textbf{C}_i^k\)로의 state transition function은 다음과 같다.
\[\begin{aligned} \textbf{C}_i^k &= \min_{j=0}^i \{\textbf{C}_j^{k-1} - \sum_{l=j}^i \textbf{S}[j, l] \} \\ \textbf{P}_i^k &= \textrm{argmin}_{j=0}^i \{\textbf{C}_j^{k-1} - \sum_{l=j}^i \textbf{S}[j, l] \} \end{aligned}\]Cost matrix $\textbf{C}$와 추적된 경로 $\textbf{P}$를 구한 후, \(\textbf{P}_N^K\)에서 $\textbf{P}$를 backtracking함으로써 최적의 $\Phi$를 구할 수 있다.
Experiments
1. Metric comparison with baselines
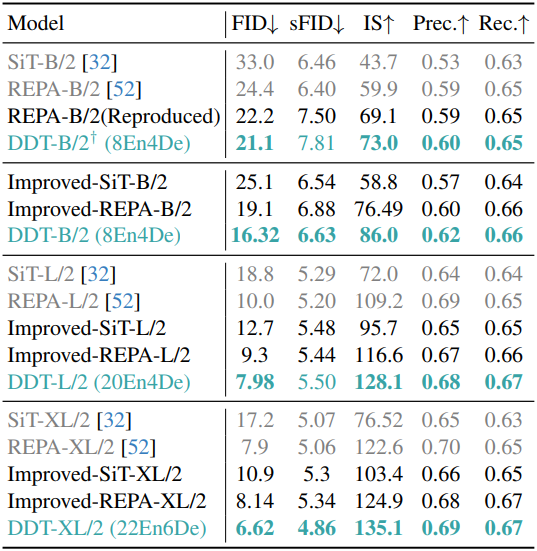
다음은 40만 step의 학습 후 성능을 비교한 결과이다.
2. System level comparison
다음은 ImageNet 256$\times$256 클래스 조건부 생성에 대한 비교 결과이다.
다음은 ImageNet 512$\times$512 클래스 조건부 생성에 대한 비교 결과이다.
3. Acceleration by Encoder sharing
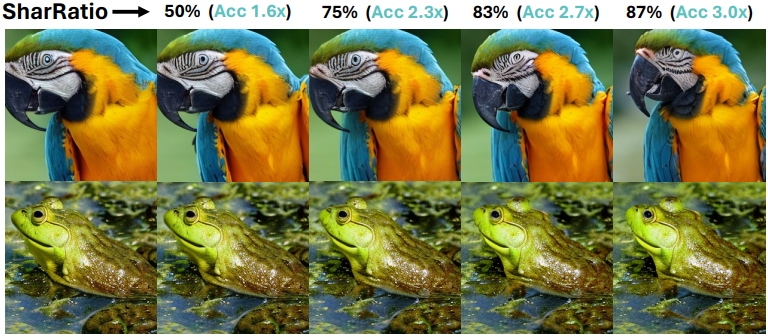
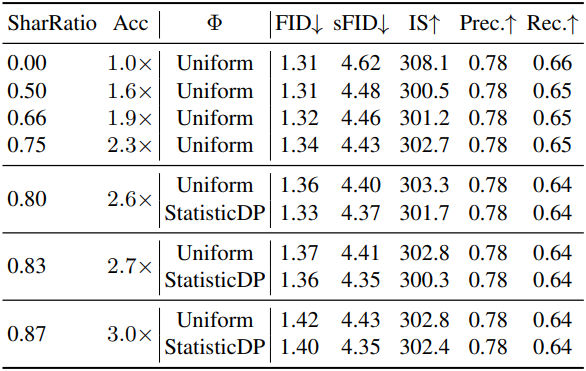
다음은 인접한 step 간의 self-condition 공유 비율에 따른 성능 비교 결과이다.
4. Ablations
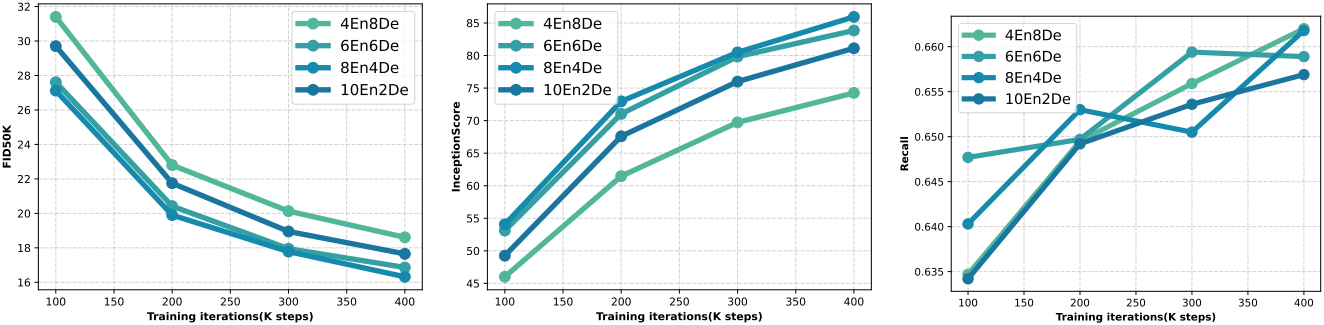
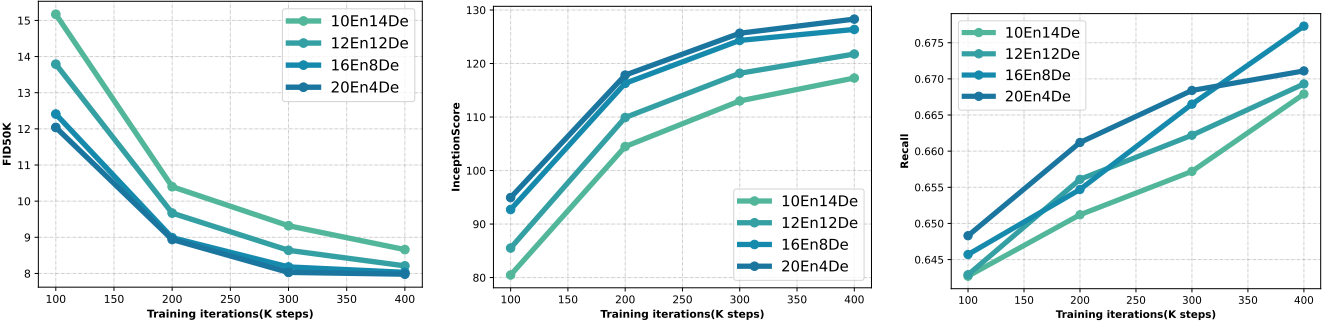
다음은 인코더와 디코더 layer 수에 따른 성능 비교 결과이다. (위: DDT-B/2, 아래: DDT-L/2)
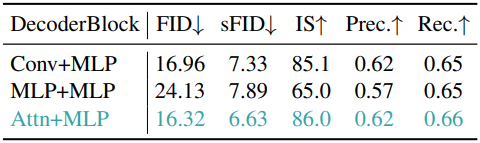
다음은 decoder block 종류에 따른 성능 비교 결과이다. (40만 step 학습, DDT-B/2, 8En4De)