[논문리뷰] DanceGRPO: Unleashing GRPO on Visual Generation
arXiv 2025. [Paper] [Page] [Github]
Zeyue Xue, Jie Wu, Yu Gao, Fangyuan Kong, Lingting Zhu, Mengzhao Chen, Zhiheng Liu, Wei Liu, Qiushan Guo, Weilin Huang, Ping Luo
ByteDance Seed | The University of Hong Kong
12 May 2025
Introduction
Diffusion model과 rectified flow의 학습 중에 인간 피드백을 통합하는 것은 출력을 인간 선호도 및 미적 기준에 맞추는 데 중요하다. 기존의 RL 기반 방법은 주목할 만한 한계에 직면해 있다.
- Rectified flow 모델의 ODE 기반 샘플링이 Markov Decision Process (MDP) 공식과 충돌한다.
- 기존의 policy gradient 접근법(ex. DDPO)은 작은 데이터셋 (ex. 100개 미만 프롬프트) 이상으로 확장할 때 불안정성을 나타낸다.
- 동영상 생성 task에 대해 검증되지 않았다.
본 논문은 diffusion model 및 rectified flow의 샘플링 프로세스를 SDE를 통해 재구성하고, 학습 과정을 안정화하기 위해 GRPO를 적용함으로써 이러한 문제점들을 해결하였다. 본 논문에서는 DanceGRPO 프레임워크를 통해 GRPO를 비전 생성 task에 최초로 도입하였다. 본 논문의 핵심 통찰은, GRPO가 지닌 구조적 안정성 특성이 기존 RL 기반 접근법에서 최적화 불안정성을 야기했던 문제들에 대해 원칙에 입각한 해결책을 제시한다는 점이다.
Method
MDP로서의 denoising
DDPO를 따라, diffusion model과 rectified flow의 denoising process를 Markov Decision Process (MDP)로 구성한다.
\[\begin{equation} \textbf{s}_t = (\textbf{c}, t, \textbf{z}_t), \quad \pi (\textbf{a}_t \mid \textbf{s}_t) = p (\textbf{z}_{t-1} \mid \textbf{z}_t, \textbf{c}), \quad P(\textbf{s}_{t+1} \mid \textbf{s}_t, \textbf{a}_t) = (\delta_{\textbf{c}}, \delta_{t-1}, \delta_{\textbf{z}_{t-1}}) \\ \textbf{a}_t = \textbf{z}_{t-1}, \quad R(\textbf{s}_t, \textbf{a}_t) = \begin{cases} r (\textbf{z}_0, \textbf{c}) & \textrm{if} \; t = 0 \\ 0 & \textrm{otherwise} \end{cases}, \quad \rho_0 (\textbf{s}_0) = (p (\textbf{c}), \delta_T, \mathcal{N}(\textbf{0}, \textbf{I})) \end{equation}\]($\textbf{c}$는 프롬프트, \(\delta_y\)는 $y$에서만 0이 아닌 density를 갖는 디랙 델타 분포)
Denoising 궤적은 $T$개의 timestep으로 구성되며, 이후 $P$는 종료 state로 이어진다. Reward model \(r(\textbf{z}_0, \textbf{c})\)는 CLIP이나 Qwen-VL과 같은 VLM이다.
SDE 샘플링
GRPO는 다수의 궤적 샘플을 통한 확률적 탐색을 필요로 하며, 이때 policy 업데이트는 궤적 확률 분포 및 그와 관련된 reward 신호에 의존한다. 따라서 저자들은 diffusion model과 rectified flow의 샘플링 과정을 SDE 형태로 통합하였다.
Diffusion model의 경우, forward SDE는 \(\textrm{d} \textbf{z}_t = f_t (\textbf{z}_t) \textrm{d} t + g_t \textrm{d} \textbf{w}\)로 주어진다. 이에 대응하는 reverse SDE는 다음과 같이 표현할 수 있다.
\[\begin{equation} \textrm{d} \textbf{z}_t = \left( f_t \textbf{z}_t - \frac{1 + \epsilon_t^2}{2} g_t^2 \nabla \log p_t (\textbf{z}_t) \right) \textrm{d} t + \epsilon_t g_t \textrm{d} \textbf{w} \end{equation}\]이와 유사하게, rectified flow의 forward ODE는 \(\textrm{d} \textbf{z}_t = \textbf{u}_t \textrm{d} t\)로 표현된다. 생성 과정은 이 ODE를 시간 역방향으로 진행하는 것이다. 그러나 이러한 deterministic한 공식으로는 GRPO에 필요한 확률적 탐색을 제공할 수 없다. 따라서 reverse process에 다음과 같이 SDE를 도입한다.
\[\begin{equation} \textrm{d} \textbf{z}_t = \left( \textbf{u}_t - \frac{1}{2} \epsilon_t^2 \nabla \log p_t (\textbf{z}_t) \right) \textrm{d} t + \epsilon_t \textrm{d} \textbf{w} \end{equation}\]정규분포 \(p_t (\textbf{z}_t) = \mathcal{N} (\textbf{z}_t \mid \alpha_t \textbf{x}, \sigma_t^2 I)\)가 주어졌을 때, \(\nabla \log p_t (\textbf{z}_t)\)는 다음과 같다.
\[\begin{equation} \nabla \log p_t (\textbf{z}_t) = - \frac{\textbf{z}_t - \alpha_t \textbf{x}}{\sigma_t^2} \end{equation}\]이를 앞서 언급한 두 개의 SDE에 대입함으로써 \(\pi (\textbf{a}_t \mid \textbf{s}_t)\)를 도출할 수 있다.
알고리즘
DeepSeek-R1에서 영감을 받아, 주어진 프롬프트 $\textbf{c}$에 대해 생성 모델은 기존 모델 \(\pi_{\theta_\textrm{old}}\)로부터 일련의 출력값 \(\{\textbf{o}_i\}_{i=1}^G\)를 샘플링하며, 다음과 같은 objective를 최대화함으로써 policy 모델 \(\pi_\theta\)를 최적화한다.
\[\begin{equation} \mathcal{J}(\theta) = \mathbb{E}_{\{\textbf{o}_i\}_{i=1}^G \sim \pi_{\theta_\textrm{old}} (\cdot \vert \textbf{c}), \textbf{a}_{t,i} \sim \pi_{\theta_\textrm{old}} (\cdot \vert \textbf{s}_{t,i})} \left[ \frac{1}{G} \sum_{i=1}^G \frac{1}{T} \sum_{t=1}^T \min \left( \rho_{t,i} A_i, \textrm{clip} (\rho_{t,i}, 1 - \epsilon, 1 + \epsilon) A_i \right) \right] \\ \textrm{where} \quad \rho_{t,i} = \frac{\pi_\theta (\textbf{a}_{t,i} \vert \textbf{s}_{t,i})}{\pi_{\theta_\textrm{old}} (\textbf{a}_{t,i} \vert \textbf{s}_{t,i})} \end{equation}\]Advantage $A_i$는 각 그룹 내의 출력들에 대응하는 reward 집합 \(\{r_i\}_{i=1}^G\)를 사용하여 계산된다.
\[\begin{equation} A_i = \frac{r_i - \textrm{mean}(\{r_i\}_{i=1}^G)}{\textrm{std}(\{r_i\}_{i=1}^G)} \end{equation}\]실제로는 reward가 sparse하게 나타나는 경우가 많기 때문에, 최적화 과정에서 모든 timestep에 동일한 reward 신호를 적용한다. 기존의 GRPO 방식에서는 reward over-optimization을 방지하기 위해 KL regularization을 사용하지만, 이를 제외하더라도 성능 차이가 거의 없다.
초기화 noise
DanceGRPO 프레임워크에서 초기화 noise는 매우 중요한 요소이다. DDPO와 같은 기존의 RL 기반 접근 방식은 학습 샘플 초기화에 서로 다른 noise 벡터를 사용했다.
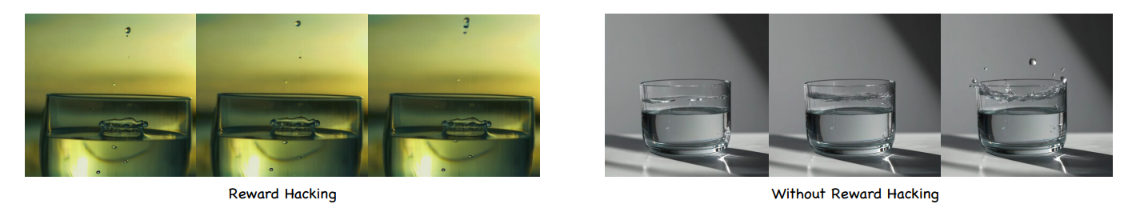
그러나 동일한 프롬프트를 가진 샘플에 서로 다른 noise 벡터를 할당하면 동영상 생성에서 reward hacking 현상, 특히 학습 불안정성이 발생한다. 따라서 본 프레임워크에서는 동일한 텍스트 프롬프트에서 유래한 샘플에 동일한 초기화 noise를 할당하였다.
Timestep 선택
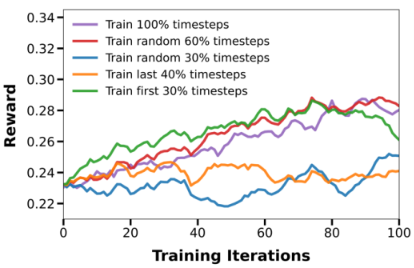
경험적 관찰 결과 denoising 궤적 내의 timestep 일부를 생략해도 성능 저하가 발생하지 않는다. 이러한 계산 step 감소는 출력 품질을 유지하면서 효율성을 향상시킨다.
여러 reward model 통합
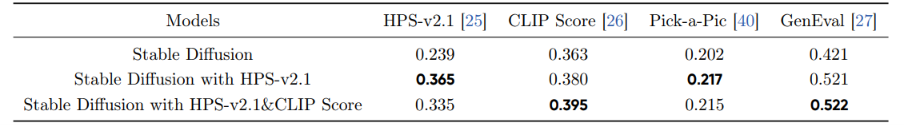
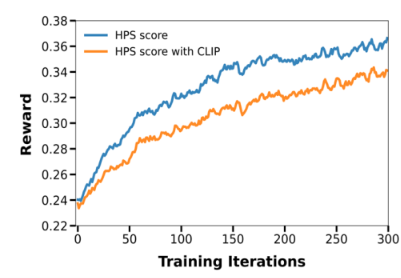
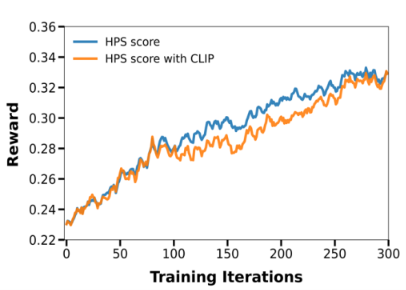
보다 안정적인 학습과 고품질의 시각적 결과를 보장하기 위해 하나 이상의 reward model을 사용한다. HPS-v2.1 reward만을 사용하여 학습된 모델은 부자연스러운 결과물을 생성하는 경향이 있는 반면, CLIP score를 통합하면 보다 현실적인 이미지 특성을 유지하는 데 도움이 된다.
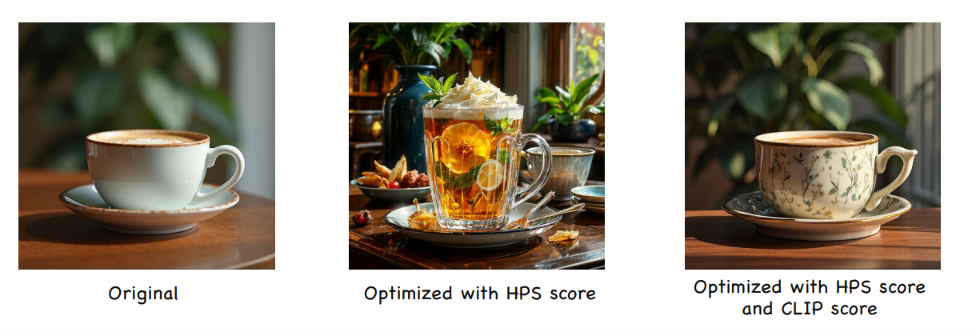
서로 다른 reward model이 종종 다른 규모에서 작동하기 때문에, reward를 직접 결합하는 대신 advantage를 통합한다. 이 접근 방식은 최적화를 안정화하고 보다 균형 잡힌 결과를 생성한다.
Best-of-N Inference Scaling
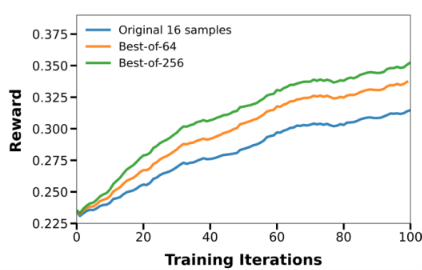
본 방법론은 효율적인 샘플, 특히 Best-of-N 샘플링에서 선택된 상위 $k$개 및 하위 $k$개 후보와 관련된 샘플의 사용을 우선시한다. 이러한 선택적 샘플링 전략은 solution space의 높은 reward 영역과 낮은 reward 영역에 집중함으로써 학습 효율성을 최적화한다. 저자들은 이러한 샘플을 생성하기 위해 brute-force search를 사용하였다.
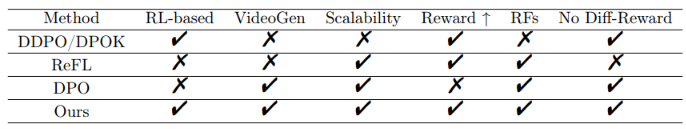
Comparisons with DDPO, DPOK, ReFL, and DPO
DanceGRPO는 모든 평가 차원에서 다른 모델 대비 전체 스펙트럼 우월성을 달성하였다.
- 원활한 동영상 생성 (VideoGen)
- 대규모 데이터셋으로의 확장성 (Scalability)
- 상당한 reward 개선 (Reward ↑)
- Rectified flow와의 호환성 (RFs)
- 미분 가능한 reward로부터의 독립성 (No Diff-Reward)
Experiments
1. Text-to-Image Generation
다음은 Stable Diffusion v1.4에 대한 결과이다.
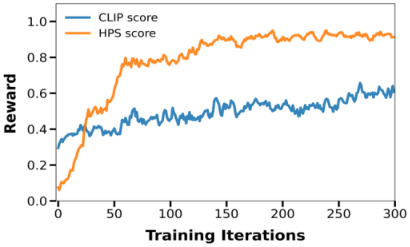
다음은 binary reward model에 대한 결과이다.
다음은 Best-of-N inference scaling 결과이다.
다음은 FLUX.1-dev에 대한 결과이다.
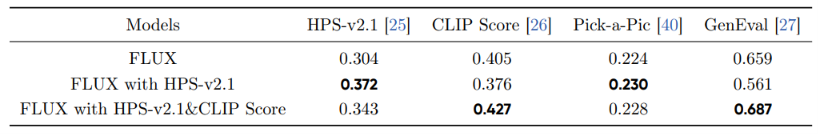
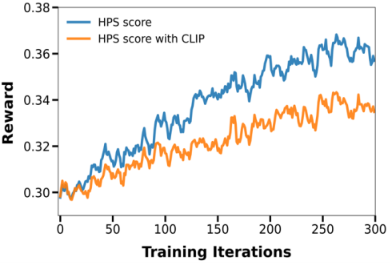
다음은 HunyuanVideo-T2I에 대한 결과이다.
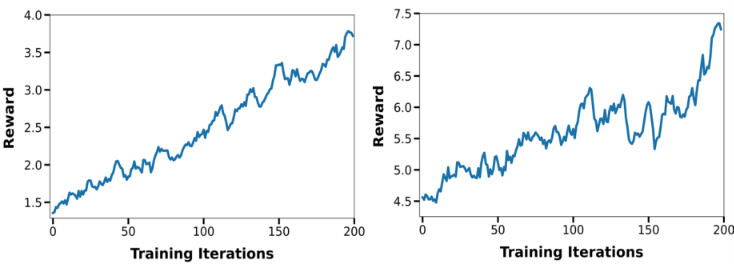
2. Text-to-Video Generation
다음은 HunyuanVideo에 대한 결과이다.
3. Image-to-Video Generation
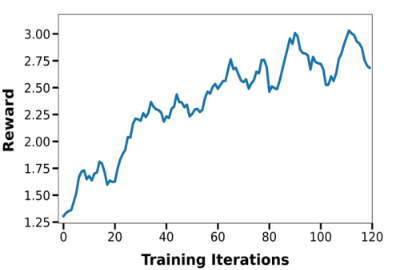
다음은 SkyReels-I2V에 대한 결과이다.
4. Human Evaluation
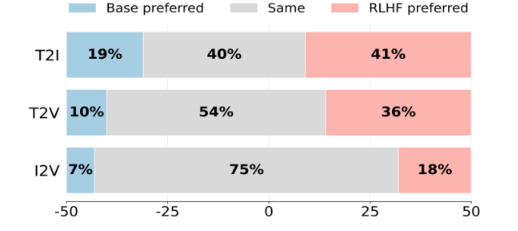
다음은 3가지 task에 대한 인간 평가 결과이다. (FLUX, HunyuanVideo, SkyReels)
5. Ablation Study
다음은 timestep 부분 선택에 대한 ablation 결과이다.
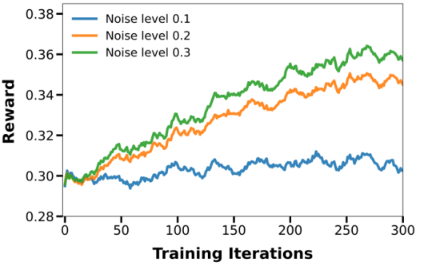
다음은 noise level \(\epsilon_t\)에 대한 ablation 결과이다.